让光来判真假:一次过十五条视频的深度伪造筛查

识别深度伪造视频,现在的主流办法是跑深度神经网络。问题不在准不准,在规模:最好的检测模型单次推理要几千亿次浮点运算,而且只能一条一条视频地看。内容越多,延迟和能耗就线性往上走。平台每天要过的内容量,和这套成本结构对不上。
识别深度伪造视频,现在的主流办法是跑深度神经网络。问题不在准不准,在规模:最好的检测模型单次推理要几千亿次浮点运算,而且只能一条一条视频地看。内容越多,延迟和能耗就线性往上走。平台每天要过的内容量,和这套成本结构对不上。
加州大学洛杉矶分校的团队给了一个不同的答案:把检测流程里最重的一段交给光。他们在 eLight 上发表了题为 "Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection" 的论文,展示了一套数字—光学混合架构,可以在一次光传播过程中同时判别至少 15 路视频。
数字编码,光学解码
整套系统分成前后两段。前端是一个轻量的数字编码器,从每段视频抽若干帧人脸图像,分别提取空间域和傅里叶域的特征,再把多帧信息压缩成一个相位图,加载到可编程空间光调制器上。后端是一套自由空间的被动光学解码器:编码后的光波前直接传播过去,末端的成对光学探测器给出这段视频的真伪分数。
关键在"被动"两个字。原本需要一个计算量很大的数字解码网络,现在由一次并行的物理过程取代。衍射层是静态的、不需要供电的结构,推理时不额外耗电。
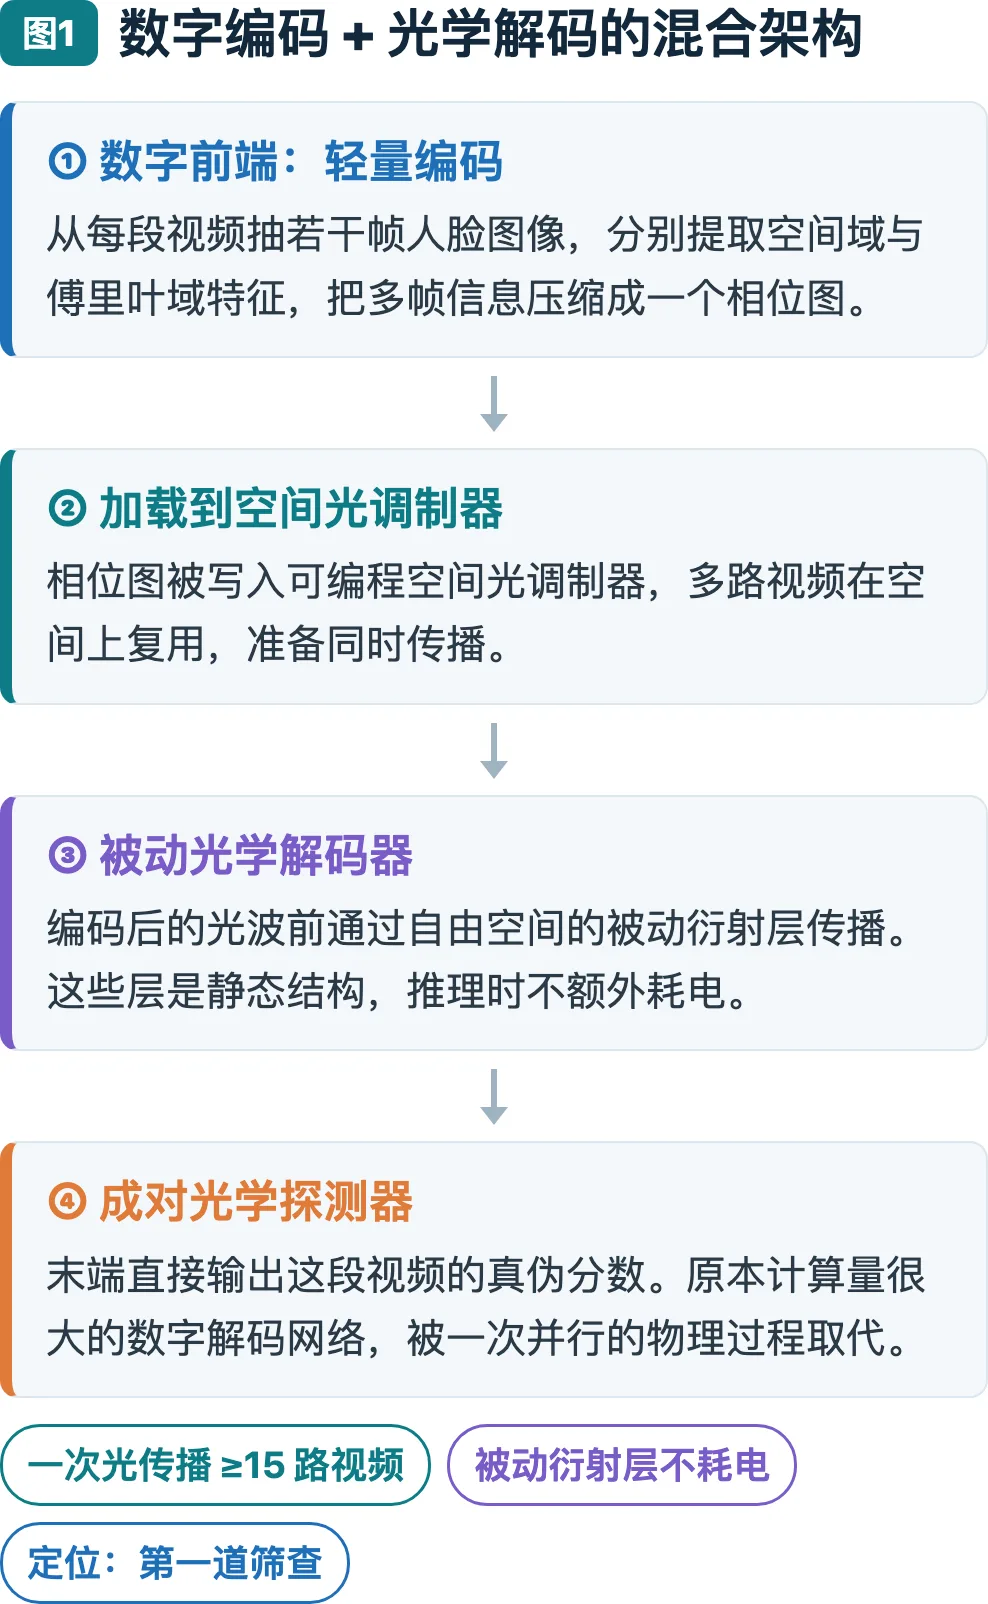
轻量化数字前端把视频压成相位图,经空间光调制器后在被动衍射层中并行传播,末端探测器直接输出真伪分数
实测数字
在可见光波段的实验装置上,系统单次光传播同时处理 15 条 Celeb-DF 视频,平均检测准确率 97.79%,灵敏度 99.86%,特异度 95.72%。灵敏度接近满值意味着假阴性率约 0.14%——对一道"第一道筛查"来说,这个方向很重要,它的职责是尽量不让伪造内容漏过去。
把复用能力提到每次 18 条视频时,平均准确率仍有 96.13%。团队还发现,增加被动光学解码器的物理深度可以提升性能,而能耗和推理延迟基本不变。在更难的伪造手法上,加两层经过优化的纯相位衍射层,准确率提高了约 6.8%。
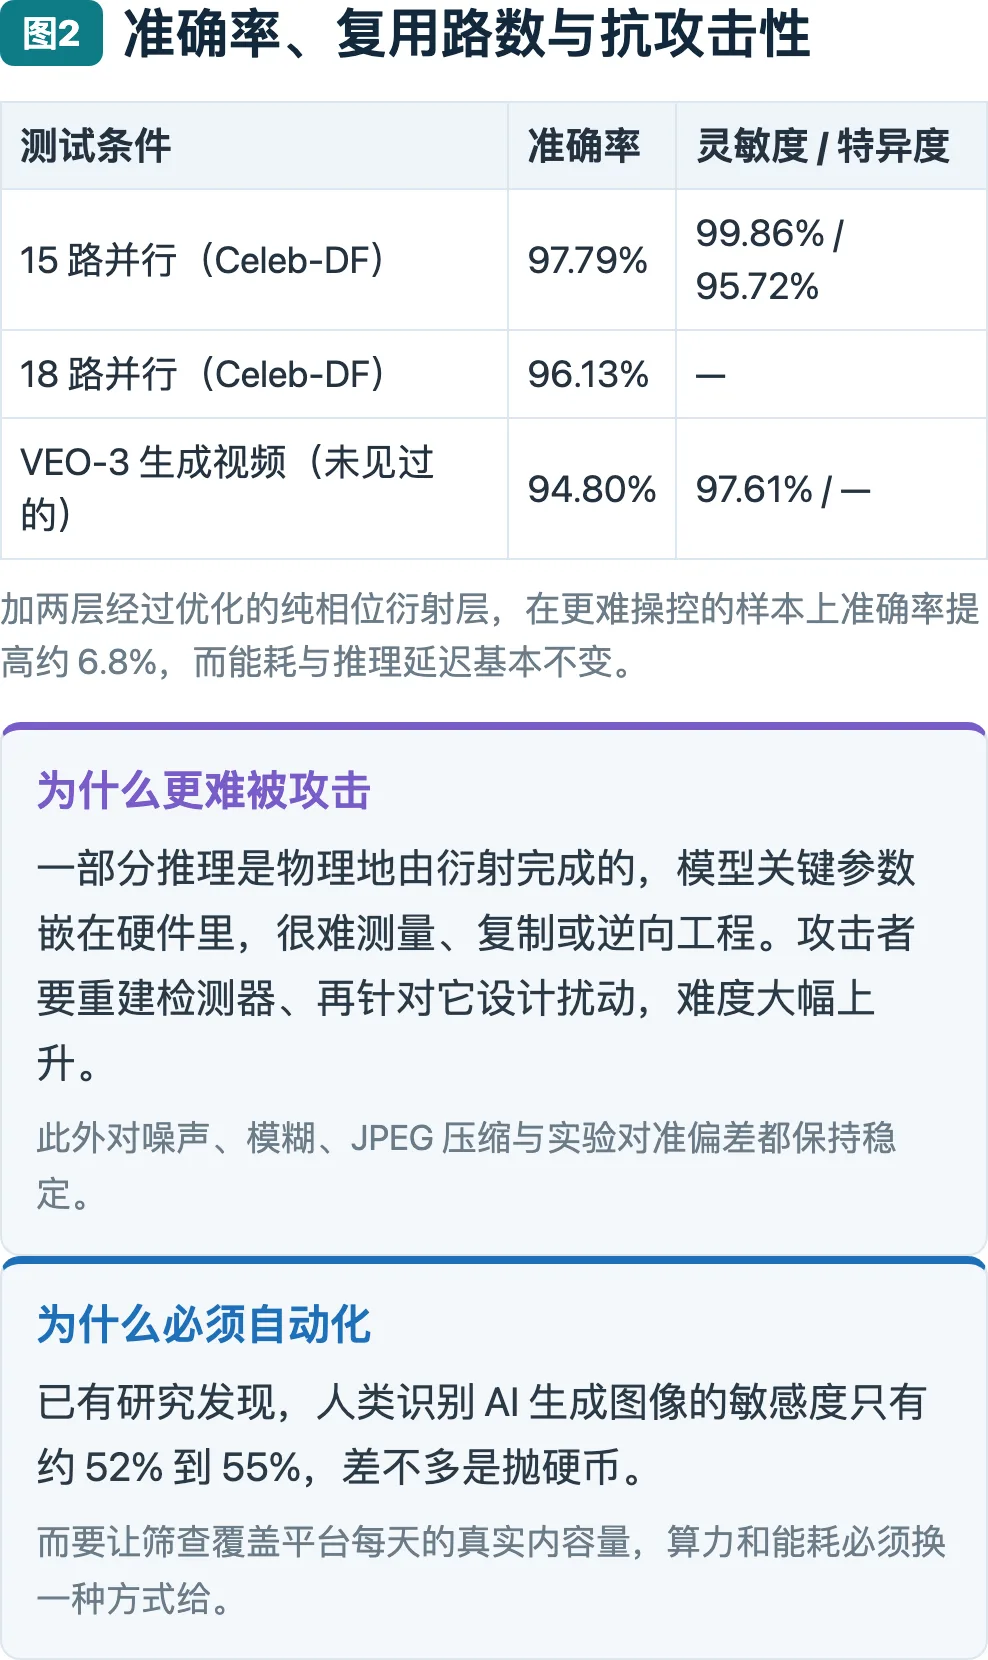
15 路并行 97.79%、18 路 96.13%、对从未见过的 VEO-3 生成视频 94.80%;物理衍射让模型参数难以逆向
真正考验新检测器的是没见过的生成器。团队用谷歌 VEO-3 模型生成的视频做了测试——这类视频缺少早期深度伪造常见的那些伪影。只做极少量微调后,光学处理器在从未见过的 VEO-3 视频上拿到 94.80% 的准确率和 97.61% 的灵敏度。这说明这套框架有机会跟上新的生成式流水线,而不是只认得训练时见过的那几种破绽。
为什么物理过程更难被攻击
数字检测器有个公开的弱点:对抗攻击。攻击者可以构造人眼几乎看不出的扰动,让预训练的检测器彻底失效。研究者测试了这套光学处理器对黑盒对抗攻击的抵抗能力,结果稳健;对白盒攻击,它还有一层天然保护。
原因是有一部分推理是物理地由衍射完成的,模型的关键参数嵌在硬件里,很难测量、复制或逆向工程。攻击者想重建这个检测器、再针对它设计对抗扰动,难度大幅上升。此外,系统对图像噪声、模糊、JPEG 压缩以及实验中的对准偏差都保持稳定。
它的位置是筛查,不是终审
团队对这个系统的定位很清楚:高灵敏度的第一道筛查。大量视频先由并行的光学处理器快速过一遍,被标记出来的再交给计算更重的数字模型做最终判定。并行度、低解码能耗、高灵敏度、对新生成模型的适应能力、较强的抗攻击性——这五件事在纯数字系统里很难同时拿到,而这个架构把它们凑到了一起。
背景值得提一句:已有研究发现,人类识别 AI 生成图像的敏感度只有约 52% 到 55%,差不多是抛硬币。自动化筛查不是锦上添花,而是必需品。而要让筛查覆盖平台每天的真实内容量,算力和能耗必须换一种方式给。用光来算,是其中一种正在被认真验证的答案。
论文作者为 Parnian Ghapandar Kashani 和 Shiqi Chen(共同第一作者)以及 Aydogan Ozcan 教授,均来自 UCLA 电气与计算机工程系、生物工程系和加州纳米系统研究所。
#### 参考来源- Researchers harness light to detect deepfake videos at scale, EurekAlert / UCLA
- Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection, arXiv:2605.19360
- 论文发表于光学期刊 eLight
- 光里有个"洞"跑赢了光:一条 1970 年代的预言,2026 年第一次被测出来 — 光的行为比直觉复杂得多
- 把器件倾斜 0.3 度,光的转换效率涨了 7.2 万倍 — 光学器件里的非线性回报
- AI 共同科学家:科研从"人做"到"人机共创" — AI 介入知识生产的另一面
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…