基因测序简史:从九千五百万降到五百美元
四十年,测序成本从九千五百万美元降到五百美元,降速超过半导体摩尔定律。
有一个数字,比任何技术名词都更能说明过去四十年发生了什么。
根据美国国家人类基因组研究所(NHGRI)长期追踪的数据:测完一个人的基因组,2001 年大约要花 9,500 万美元;到 2015 年前后,降到 1,000 美元左右;2022 年前后,约 525 美元。
二十年,成本降了约十八万倍。同期没有任何一项复杂技术,降本速度能与之相比——半导体的摩尔定律在它面前都算温和。
这条曲线是怎么走出来的?下面是一份简史。
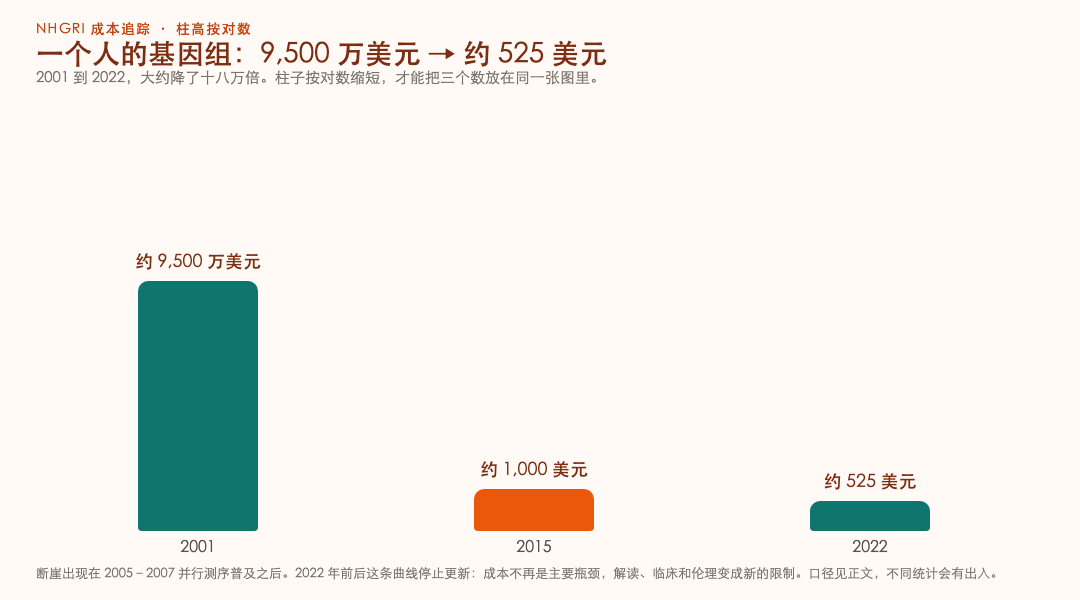
图 1 NHGRI 口径:2001 约 9,500 万美元,2015 约 1,000 美元,2022 约 525 美元。柱高按对数。
1977:两种读法同时诞生
现代测序的起点是 1977 年,那一年出现了两种截然不同的思路。
Sanger 的双脱氧链终止法。Frederick Sanger 的办法很巧妙:DNA 复制时,如果在原料里掺入少量"掺进去就停住"的假核苷酸(双脱氧核苷酸),复制就会在不同位置随机中断,产生长短不一的片段。把这些片段按长度排开,末端的碱基顺序,就是原序列。
Maxam-Gilbert 化学降解法。Allan Maxam 与 Walter Gilbert 用的是化学手段:用特定的化学试剂在指定碱基处切断 DNA 链,同样靠片段长度读出序列。
两种方法一并开启了"读取遗传信息"的时代。最终胜出的是 Sanger 法——更安全、更容易自动化,也成了他第二座诺贝尔化学奖的基础。
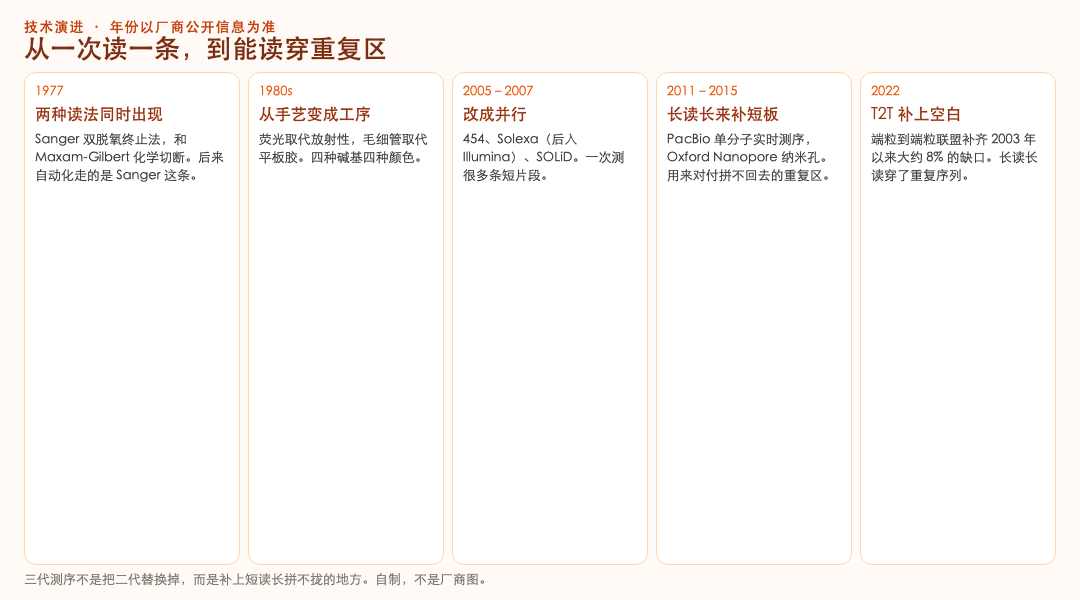
图 2 从 1977 年两种读法到 2022 年补齐重复区空白。
1980s:从手艺活到机器活
早期的 Sanger 测序依赖放射性标记和手工跑胶,一个人一天能读几百个碱基就已经很快。
1980 年代发生的两件事改变了这一点:一是荧光标记取代放射性标记,四种碱基各染一种颜色;二是毛细管电泳取代平板凝胶,让片段分离可以自动化、并行化。ABI 等公司推出的自动测序仪,把测序从一门手艺变成了一道工序。
这一步是必要的铺垫——没有自动化,后面那个耗资数十亿美元的计划根本无从谈起。
1990–2003:人类基因组计划,一次国家级动员
1990 年,人类基因组计划启动,目标是读出人类三十亿个碱基对。反对者认为这在技术上过于激进,在预算上近乎挥霍。
计划推进的过程中,自动化测序仪与规模化中心(如英国桑格研究所)构成了真正的产能基础。2000 年,人类基因组序列草图宣布完成;2003 年,计划宣告完成。
但"完成"这个词需要打引号:当时得到的序列并不完整,仍有约 8% 的区域是空白——它们多是高度重复的序列,当时的技术读不过去。这个缺口要再等近二十年才被补上。
2005–2007:二代测序,把成本曲线掰弯
真正的转折点来自思路的改变:为什么要一次测一条?能不能同时测几百万条?
2005 年,454 Life Sciences 推出基于焦磷酸测序的高通量平台,第一次把"大规模并行"变成产品。(后被 Roche 收购)
2006 年,Solexa 的测序仪上市,采用边合成边测序的路线,后来被 Illumina 收购,成为此后十余年的主流平台。
2007 年,ABI 推出 SOLiD 平台,走的是连接测序路线。
这三年里发生的事,本质是把测序从串行改成并行。通量提升了几个数量级,单位成本开始断崖式下跌。NHGRI 的成本曲线正是在这段时间之后陡然掉头向下的。
2011–2015:长读长,把碎片拼回去
二代测序有个代价:读得短。它把基因组打成无数小片段,测完再靠算法拼回去。遇到高度重复的区域,拼接就变得不可靠——这正是当年那 8% 空白的根源。
2011 年,Pacific Biosciences 推出 PacBio RS,采用单分子实时测序(SMRT),单次读取长度大幅提升,代价是早期错误率较高。
Oxford Nanopore 的 MinION 在 2014 年以早期试用形式推出,2015 年商业化。它走得更极端:让 DNA 分子穿过一个纳米孔,靠电流变化直接识别碱基。设备小到可以插在电脑上,甚至被带上过太空站。
长读长技术解决的正是"拼不回去"的问题。三代测序不是二代测序的替代品,而是它的补丁。
2010s–2020s:从"测序列"到"测状态"
一旦测序足够便宜,问题就变了。人们不再满足于知道序列是什么,而是想知道:在哪个细胞里、在什么位置、处于什么状态。
单细胞测序:把一个组织拆成单个细胞分别测序,揭示了"同一组织里的细胞其实千差万别"。
空间转录组学:保留细胞的位置信息再测,回答"谁挨着谁"。
Hi-C 等染色体构象捕获技术:把三维基因组折叠方式变成可测的数据。
测序从"读取字母",进化成了"读取一份带有上下文的说明书"。
2022:那个 8% 终于被补上
2022 年 4 月,端粒到端粒(Telomere-to-Telomere, T2T)联盟在《科学》上集中发表了多篇论文,宣布完成了第一个真正完整的人类基因组序列,补齐了 2003 年以来一直空缺的那约 8%。
这件事的象征意义大于实用意义:它标志着长读长技术终于成熟到可以读穿重复区域。人类用了二十二年,才把自己基因组的第一个完整版本读全。
曲线的尽头是什么
NHGRI 在 2022 年前后停止更新这条成本曲线——因为当测序降到几百美元时,成本已经不再是主要瓶颈。真正的瓶颈转移到了我们这边:数据解读、临床转化、隐私与伦理。
回看这四十年,主线其实只有一条:把一件少数专家才能做的事,变成一件任何人都能负担的事。半导体做到了这件事,测序也做到了。而每一次这种转变发生,紧接着出现的,都是我们事先预料不到的应用。
成本数据来自 NHGRI 公开追踪的测序成本统计(该序列近年已停止更新);各技术商业化年份以厂商公开信息与文献报道为准,不同统计口径可能略有出入。
延伸阅读
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…