不写一个字的推理:1.5 亿参数小模型在潜空间里做完 ARC 谜题
主流大模型靠思维链一步步"说"出推理过程,每个中间 token 都要算力。BDH-CQ 用固定大小的循环记忆把示例压进内部状态,推理过程不落成文字,在 ARC-AGI-1 上以约十一分之一的单题成本拿到约 29.5% 的通过率。
当下解决复杂问题的常规做法是让模型把中间步骤写出来。办法有效,代价也直白:为了一个很短的答案,模型可能生成长长一串中间 token,而每个 token 都要消耗算力。推理链越长,响应越慢、账单越厚。
Pathway 公司的团队试了另一条路。他们提出的 BDH-CQ 只有约 1.5 亿参数,思路是把"示例"用来更新一块固定大小的循环记忆,而不是把所有示例一直挂在上下文里。这块记忆不会随示例数量增长,因此模型不必反复回溯已经看过的东西。收到问题后,它在一个内部工作区里反复迭代计算,最后直接给出答案。
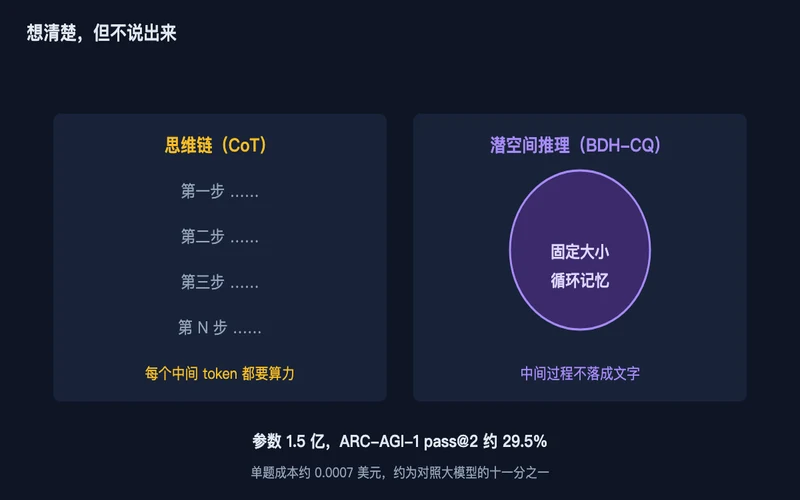
图1:思维链推理与潜空间推理的路径差异
"任务一旦提出,模型完全不会用文字写出它的思考。"公司 CEO、复杂性科学家 Zuzanna Stamirowska 说,"中间没有任何环节转换成语言。"
测试用的是 ARC-AGI-1,一组需要从少数彩色格子示例里推断抽象规则、再应用到新题目的视觉推理题。给两次尝试机会的前提下,BDH-CQ 解出约 29.5%,单题成本约 0.0007 美元。团队指出这一结果穿过了既有的成本-准确率前沿,把 ARC-AGI-1 上的成本效率刷到了新位置,并有独立团队复现验证。
擅长与不擅长的题目泾渭分明。图形旋转、平移这类空间变换它处理得干脆;颜色改变、多条规则叠加的场景就吃力;更难的对象排序与嵌套题,只需要先给它看一道难度相当的示例,表现就明显回升。
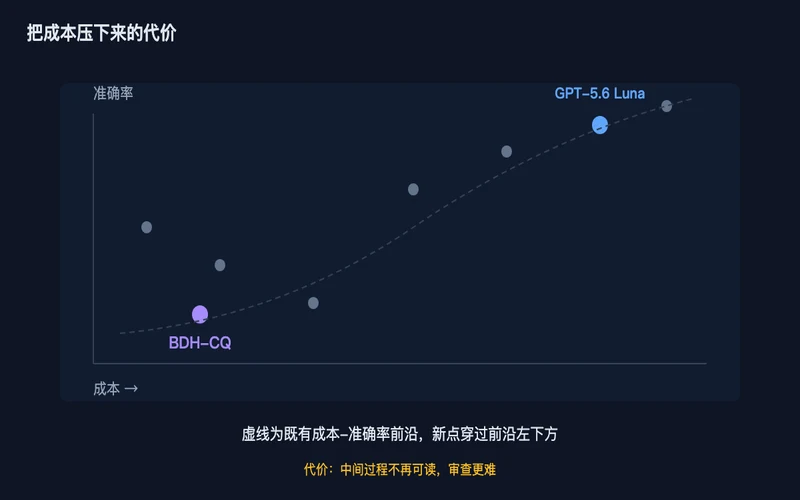
图2:成本与准确率的散点关系,新模型落在既有前沿的左下方
外部评价并不一致地乐观。滑铁卢大学的计算机科学家 Yuntian Deng 认为这是"一个有意思的效率结果",但没有证明 BDH-CQ 的底层架构优于其他方案——小模型加专门设计是一条可行路线,只是还需要更多测试把架构本身的贡献与训练方式区分开。他还指出了一个更实质的代价:推理过程不写成文字,模型就更难被检查。
这个批评值得展开一点。思维链并非可信的"内心独白",写出来的步骤未必忠实反映模型真实的计算过程,这一点已有研究支持。但至少它提供了一份可读的记录。潜空间推理把这份记录彻底取消,可解释性问题从"记录可能不忠实"变成了"没有记录",对受监管场景是性质上的变化。
此外,BDH-CQ 是专为 ARC 类题目构建的,与通用模型直接比较存在口径问题。Tübingen 的 Jonas Geiping 称其做法"巧妙",特别提到它能在不重新训练的情况下处理测试题。研究团队表示下一步会把架构放大到更强的数学、语言与视觉任务上——那才是真正能看出这条路线上限的地方。
关联推荐
- 推测解码是什么:为什么它能让大模型快 9 倍 — 另一条以效率为目标的推理优化路线
- 香农 1948 一句话定义"信息" — 从信息量角度看推理成本
- 把知识截到 1911 年,AI 能自己推出相对论吗 — 推理能力边界的另一种测法
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…