虚拟细胞与 AI 药效预测:从组学数据到模型判读
课程简介
「虚拟细胞」是这两年 AI 与生物医药交叉领域最热的词之一,也是最容易被滥用的词之一。同一个名字底下,有的模型能预测患者对药物的反应,有的只能把已知数据重新画一遍。
这门课不教你训练一个基础模型,而是教你判断:一个虚拟细胞模型到底靠不靠谱。课程以 2026 年 9 月发表在《自然》的 ProteinTalks 工作为主线,拆开它的数据设计、训练策略和评估方法,再对照转录路线的常见做法,看清差别在哪里。
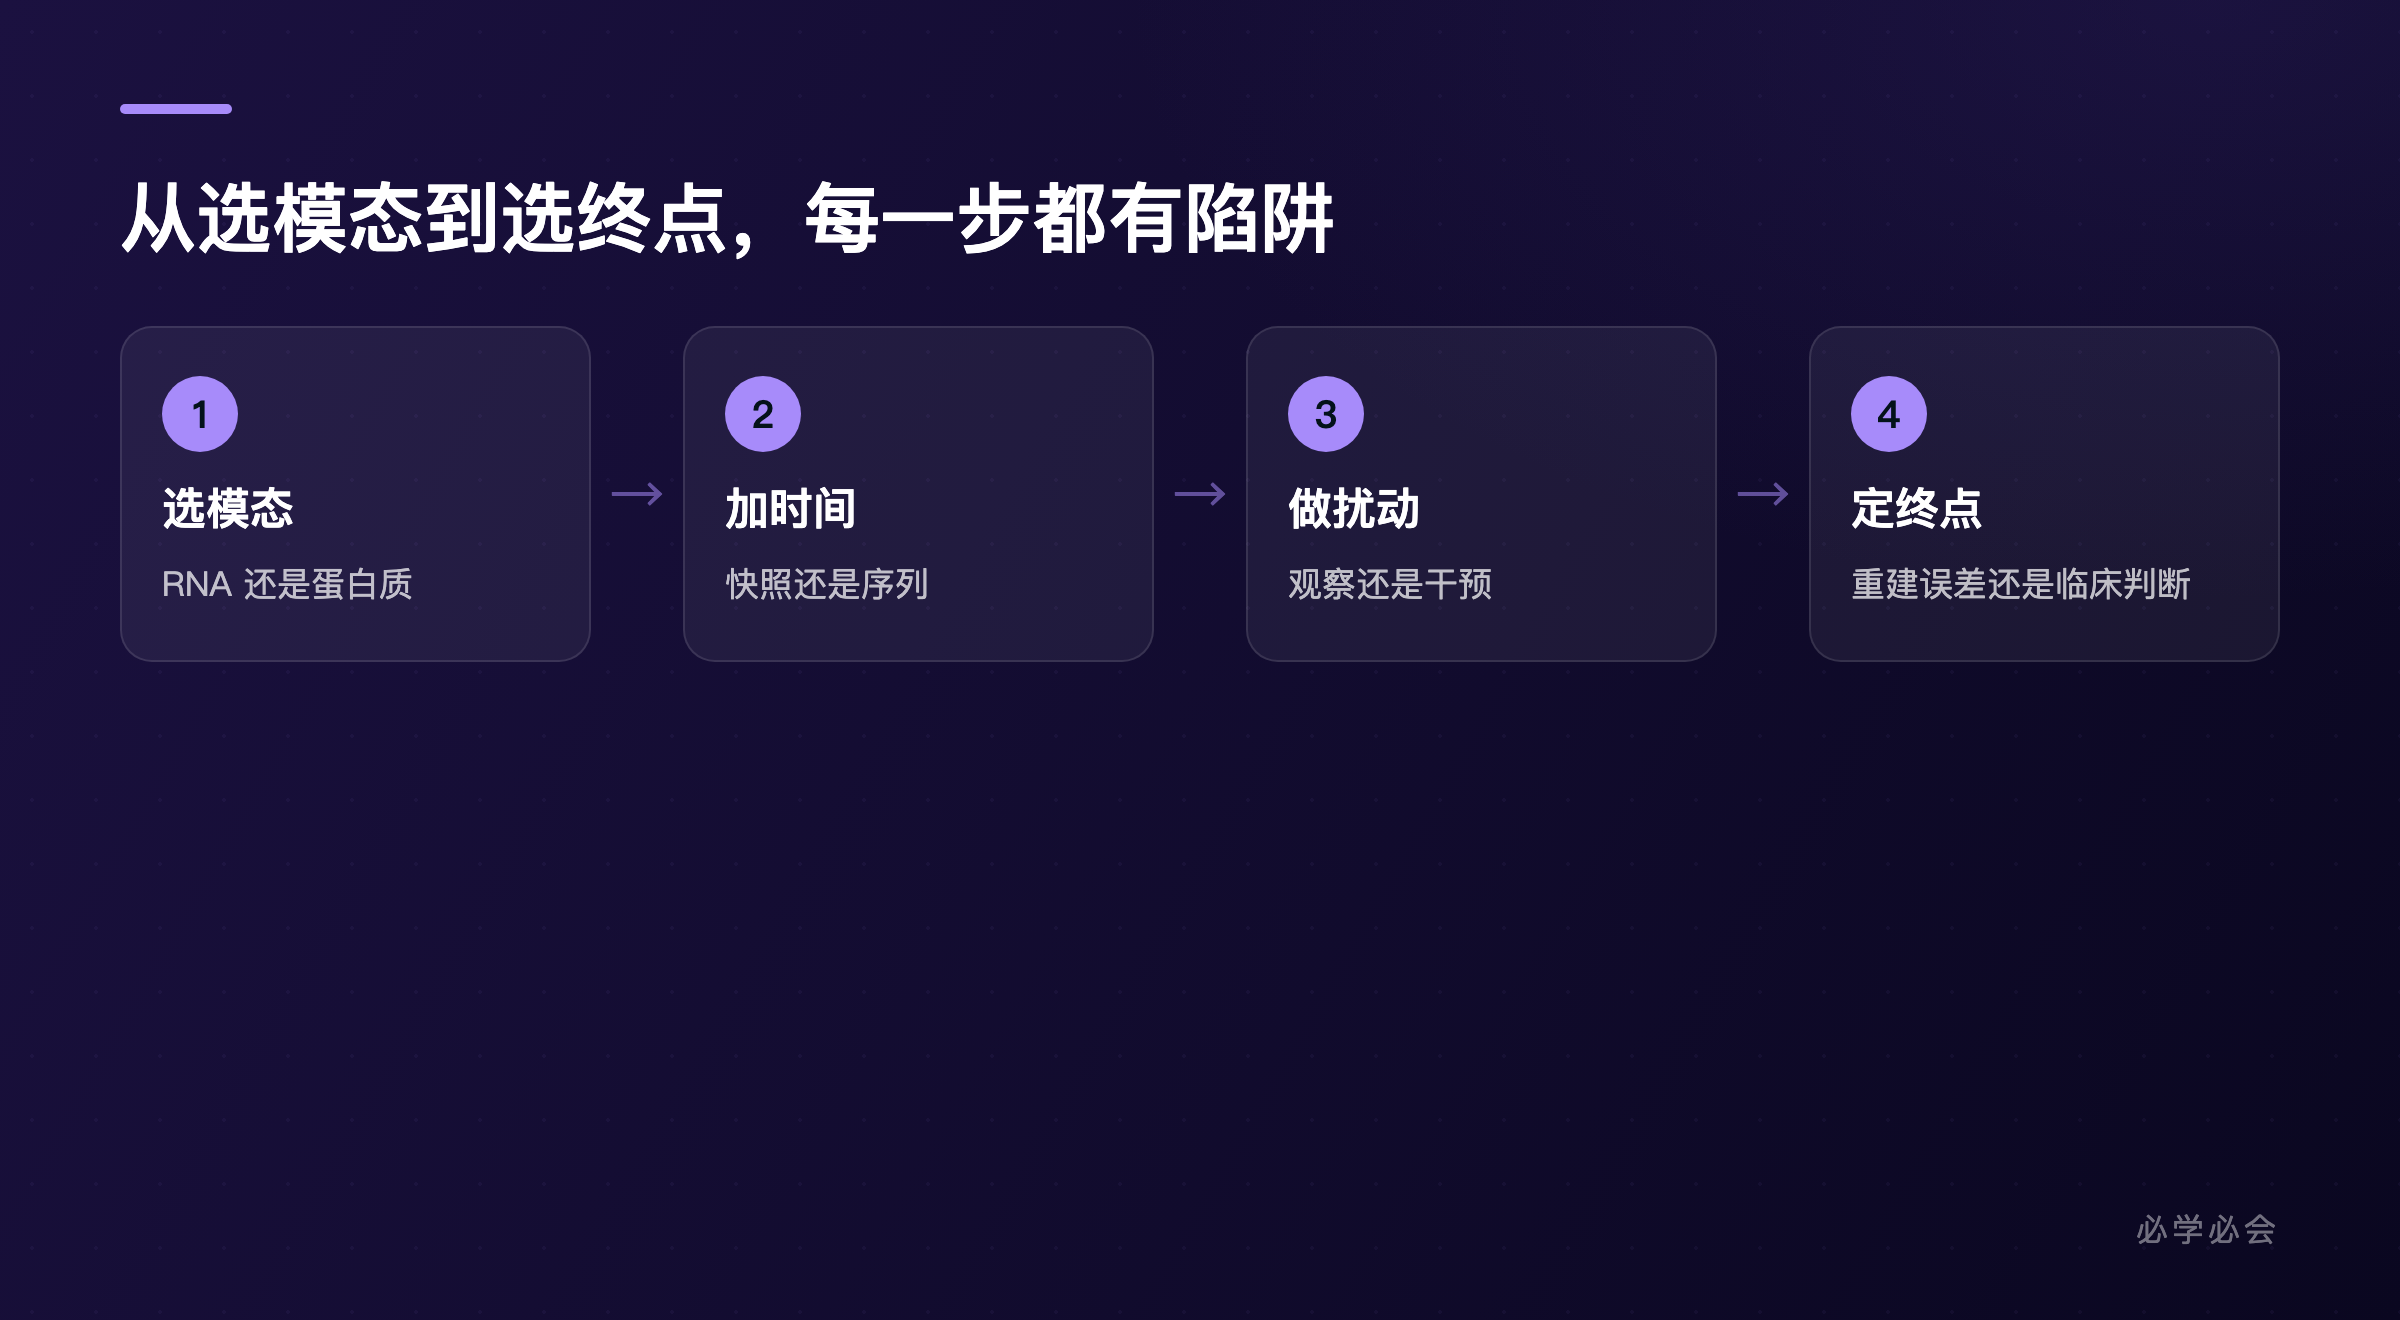
图1:从选模态到选终点,每一步都有陷阱
学习目标
- 区分转录组与蛋白质组在药效预测中的信息含量差异,理解相关性仅约 0.4 意味着什么
- 判断一份组学数据是否具备时间分辨与扰动设计,能否支撑反事实预测
- 读懂虚拟细胞论文的评估部分,分辨「重建误差低」与「临床可用」的差别
- 掌握迁移验证的基本思路:模型在其它癌种上还能不能用,说明什么
- 能独立列出一个虚拟细胞项目的关键风险点:批次效应、样本量、通量成本
章节概览
- 第一章:细胞状态的可观测层——从基因组到蛋白质组
- 第二章:为什么 RNA 丰度不等于蛋白质丰度
- 第三章:时间分辨与扰动设计:从照片到电影
- 第四章:ProteinTalks 拆解——数据、模型、评估三段式
- 第五章:虚拟细胞的评估陷阱与临床终点选择
- 第六章:迁移、外推与失败案例分析
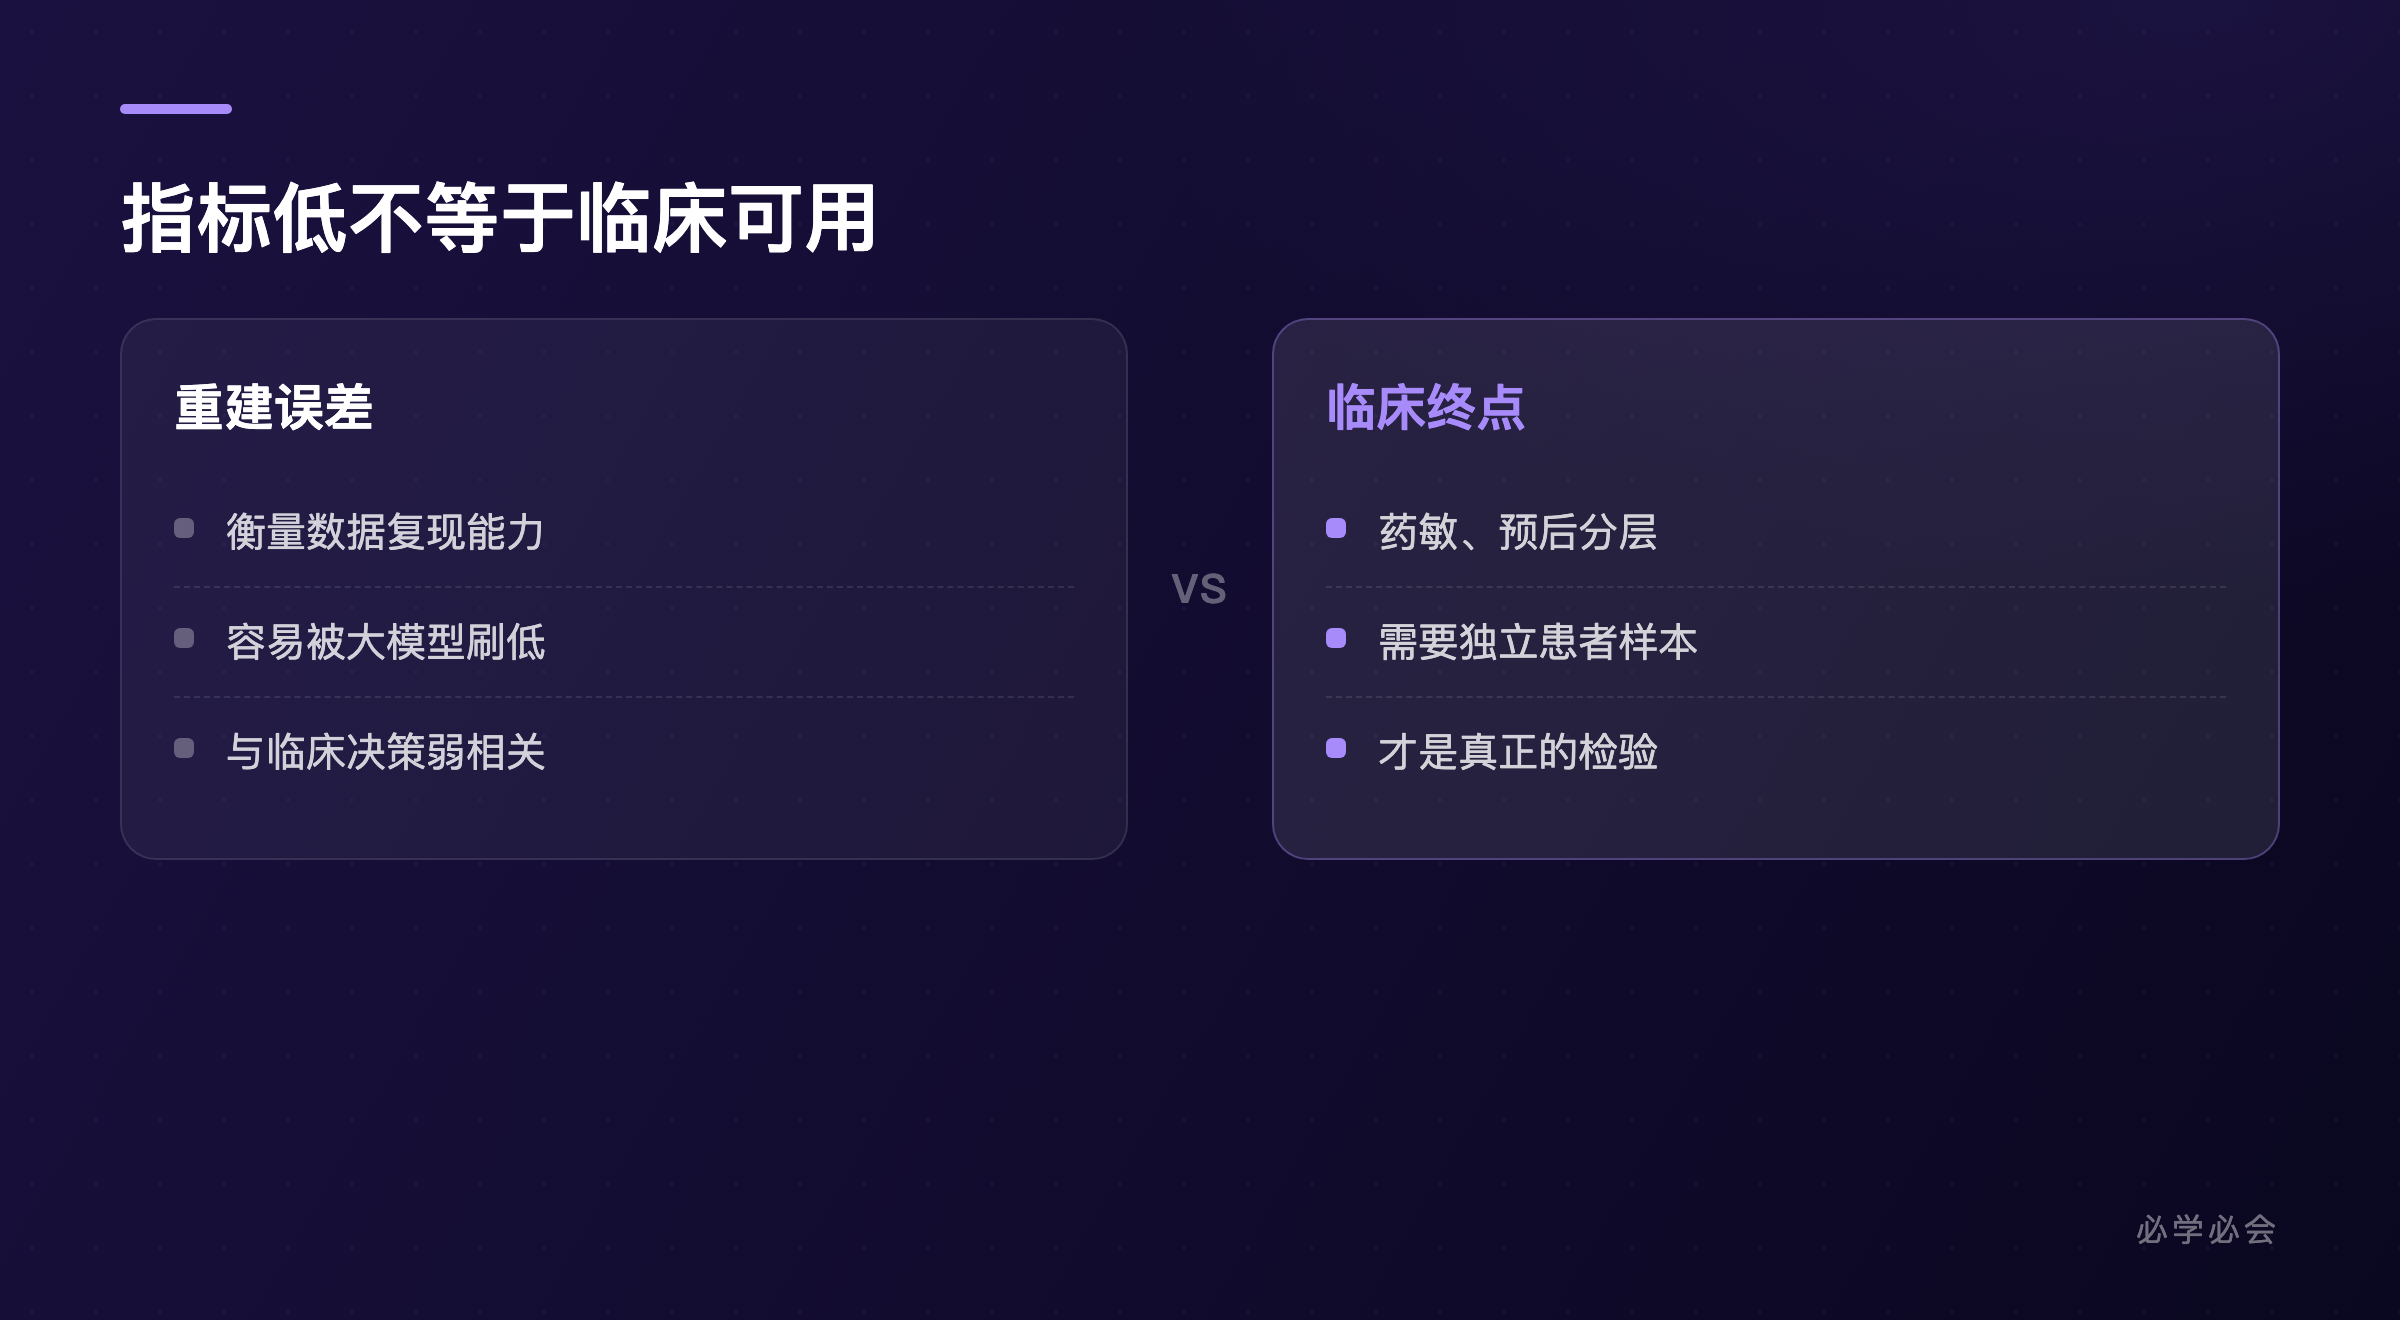
图2:指标低不等于临床可用
适合谁
有基础分子生物学或生物信息学背景,需要阅读和评判 AI 生物学论文的研究者、药企研发人员,以及正在决定要不要投入虚拟细胞方向的技术负责人。不需要深度学习背景。