结构优先的生命科学:从蛋白质折叠预测到"暗蛋白"发现
课程简介
过去二十年,读蛋白质的主流语言是序列。判断一个蛋白属于哪个家族、大概做什么功能,靠的是把它的氨基酸序列丢进数据库做比对。这套方法支撑了整个功能基因组学,但它有一个清晰的天花板:当序列相似度低于阈值,比对就什么都给不出来。
结构预测模型改变了这个局面。当三维形状变成可以批量计算的数据之后,"不查拼写查长相"成了一条新的搜索路径,而这条路径正在把一批长期隐身的蛋白——所谓"暗蛋白"——逐个拎出水面。
这门课沿着这条线索走一遍:从序列搜索为什么会失效,到结构为什么更保守,到大规模结构聚类怎么实现,再到发现一个新成员之后要补哪些实验才算数。课程以 2026 年 9 月《自然》发表的 TM184C 工作为主线案例,同时对照同一周发表的灵长类脑细胞图谱,看清"大规模数据 + 新的搜索维度"这套组合拳在什么类型的科学问题上奏效。
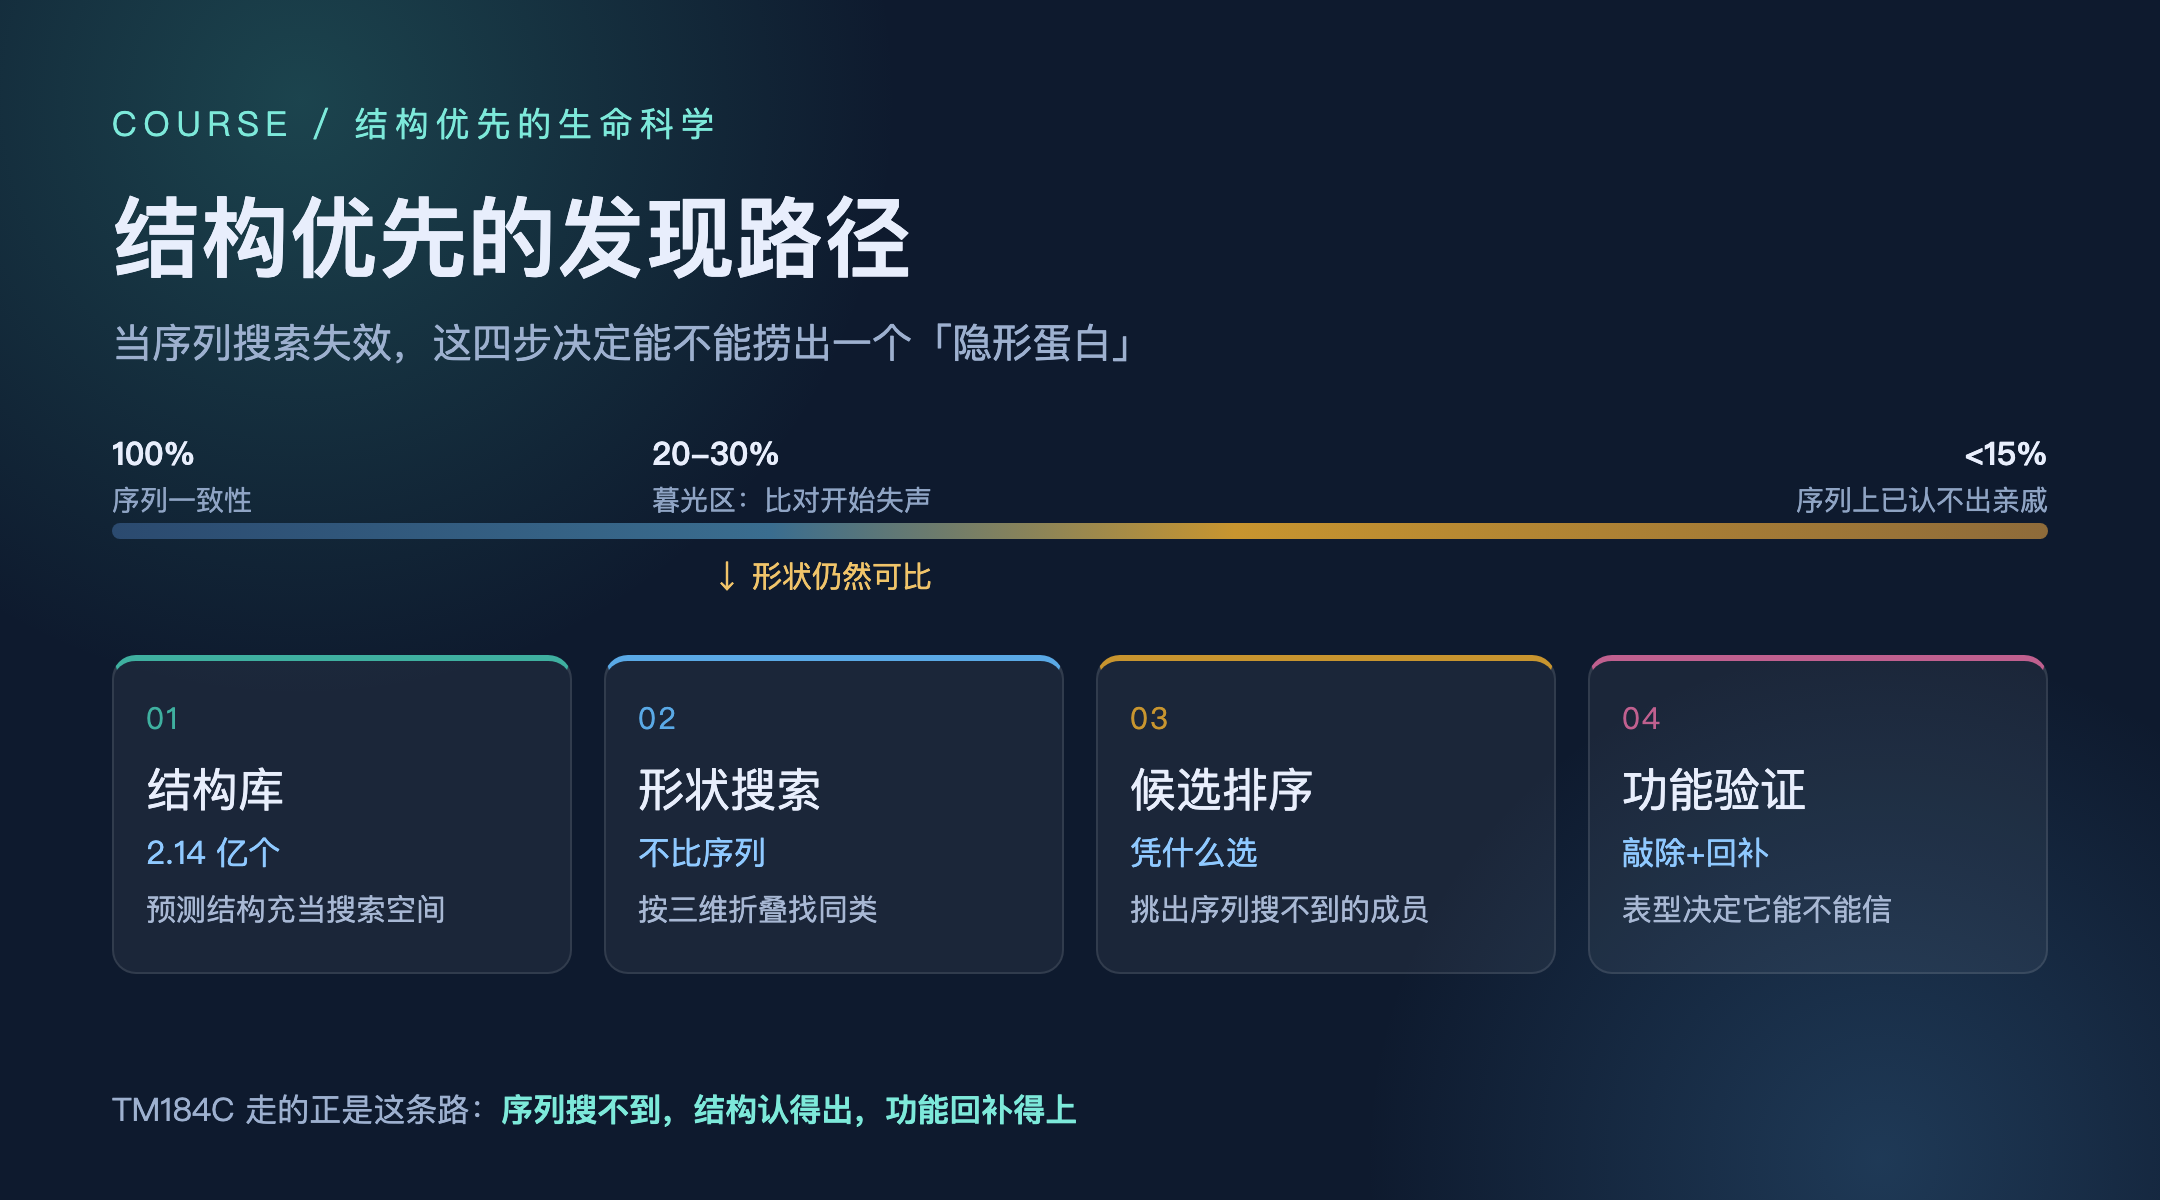
图1:结构优先的发现路径——序列失效之后,靠形状走完四步
学习目标
- 解释序列一致性"暮光区"的成因,以及结构为何比序列更能抵抗进化漂变
- 区分同源(homology)、相似(similarity)与趋同收敛(convergence)三类关系
- 理解大规模结构比对必须先做粗筛的工程必要性,能估算其复杂度量级
- 读懂一项结构驱动的发现类论文:从算库、筛选、排序到功能验证的完整链条
- 判断一个"AI 发现的新蛋白"的证据强度:区分计算线索、定位证据、敲除表型与回补实验
- 理解 GPCR 家族的生物学地位,以及为什么在这个家族里发现新成员格外重要
章节概览
- 第一章:序列的语言——从 BLAST 到多序列比对,以及它们失效的地方
- 第二章:为什么形状比拼写保守:进化约束与物理约束的分工
- 第三章:结构预测如何把"实测稀缺"变成"批量可算"
- 第四章:两亿个结构的比对怎么算——指纹、聚类与粗筛工程
- 第五章:TM184C 案例拆解——线索、验证与跨物种回补
- 第六章:GPCR 家族与药物靶点:为什么这个发现落在最值钱的位置
- 第七章:对照案例——灵长类脑细胞图谱中的"另一种搜索"
- 第八章:结构驱动发现的边界与常见误读
适合谁
有分子生物学基础、需要阅读或评判 AI 生物学交叉论文的研究生、药企研发人员,以及想理解"AI 到底在生物学里做了什么"的技术从业者。不要求深度学习背景,但会涉及基本的算法复杂度概念。
---