基因组变异解读实战入门:从序列到调控证据
课程简介
拿到一份全基因组测序结果,常见的情况是:几百万个变异,其中绝大多数是良性的,真正需要解释的可能只有一两个。难点从来不是“测出来”,而是“挑出来”。
这门课围绕非编码区展开。约 98% 的人类基因组不直接编码蛋白质,而 GWAS 找到的疾病关联位点又大量集中在这里。课程会从最基础的序列坐标讲起,一路走到如何把一个非编码变异的预测读数,组织成一条能拿去讨论的证据链。
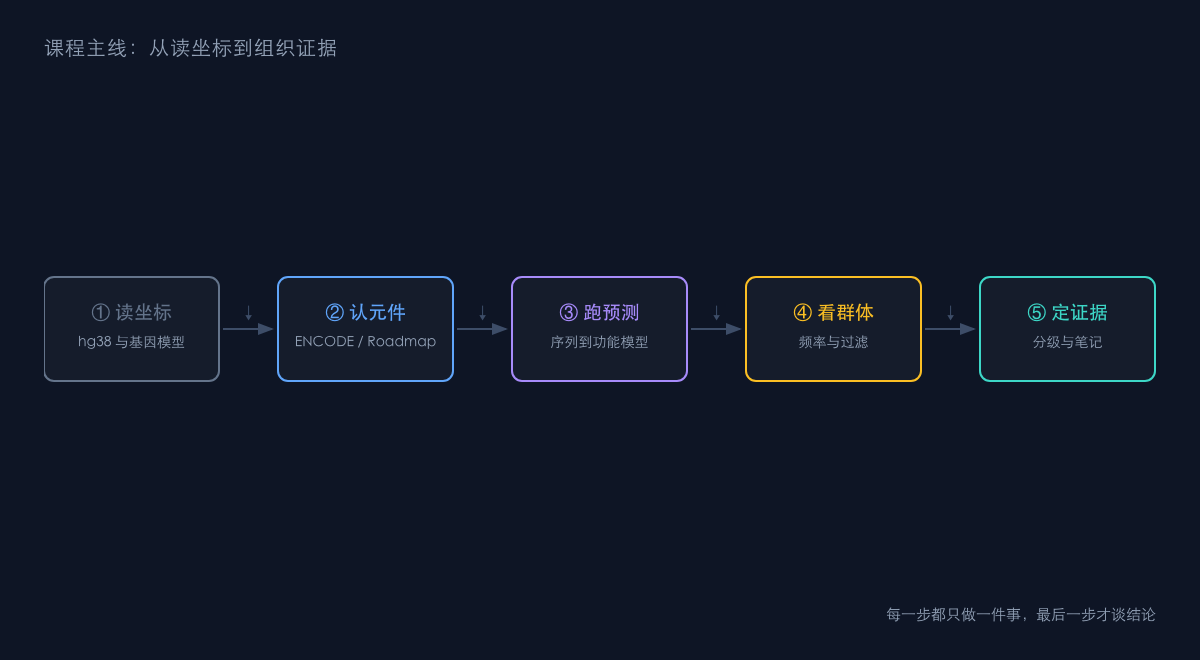
图1:课程主线,从读坐标走到组织证据
学习目标
- 能在 hg38 坐标体系下定位变异,判断它落在哪类功能区域
- 区分启动子、增强子、剪接信号、绝缘子这四类元件的作用方式
- 读懂序列到功能模型的输出,知道每种读数对应什么实验
- 会用群体频率、保守性、组织特异性三类信息交叉筛掉假阳性
- 能写出一份结构完整的变异解读笔记,标明哪些结论有实验支持、哪些只有预测
章节概览
- 第一章:坐标与注释——hg38、基因模型、转录本的选择
- 第二章:非编码元件图谱——ENCODE 与 Roadmap 的数据怎么用
- 第三章:序列到功能模型——输入长度、输出轨道、注意什么陷阱
- 第四章:变异打分——从原始读数到单一排序分数的取舍
- 第五章:群体数据与过滤——gnomAD、UK Biobank 的频率该怎么看
- 第六章:证据分级——预测、体外实验、家系共分离各自的分量
- 第七章:实战案例——一个内含子变异从候选走到 Likely Pathogenic
- 第八章:边界与伦理——为什么预测结果不能直接用于临床诊断
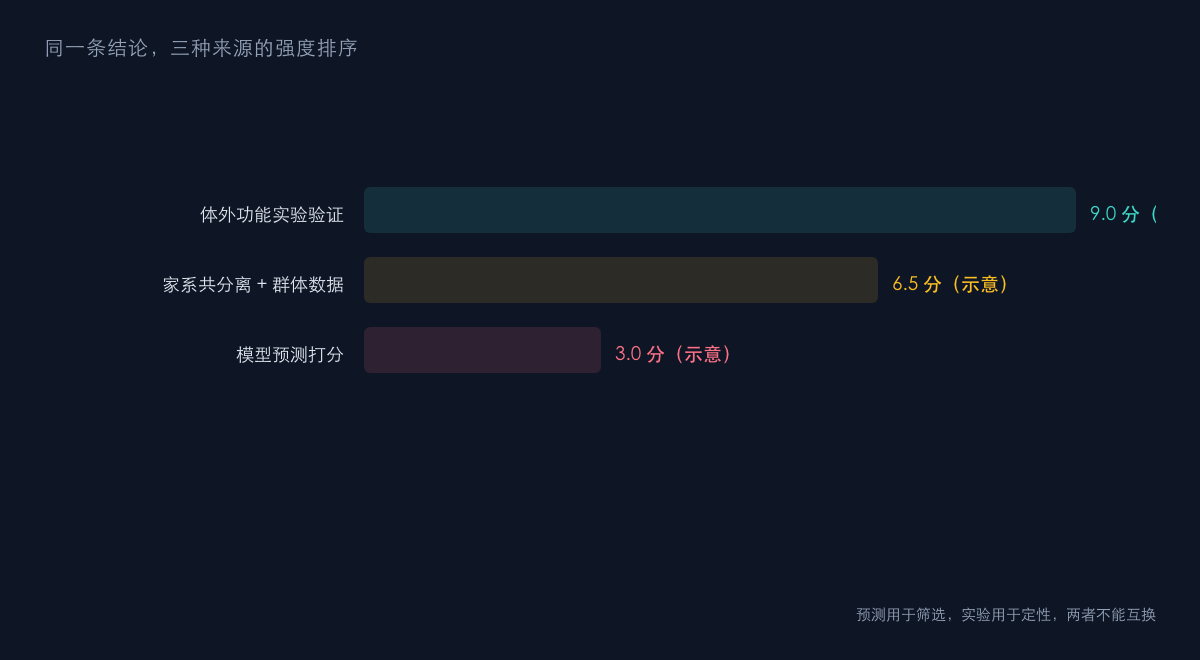
图2:同一条结论,三种来源的证据强度并不相同
适合谁
有基础分子生物学背景,需要处理测序数据但没系统学过调控基因组学的研究生、实验员或转行者。课程不要求编程基础,但会使用公开的网页工具与 API。