从读序列到读细胞:单细胞组学入门
二、主题课程
课程简介
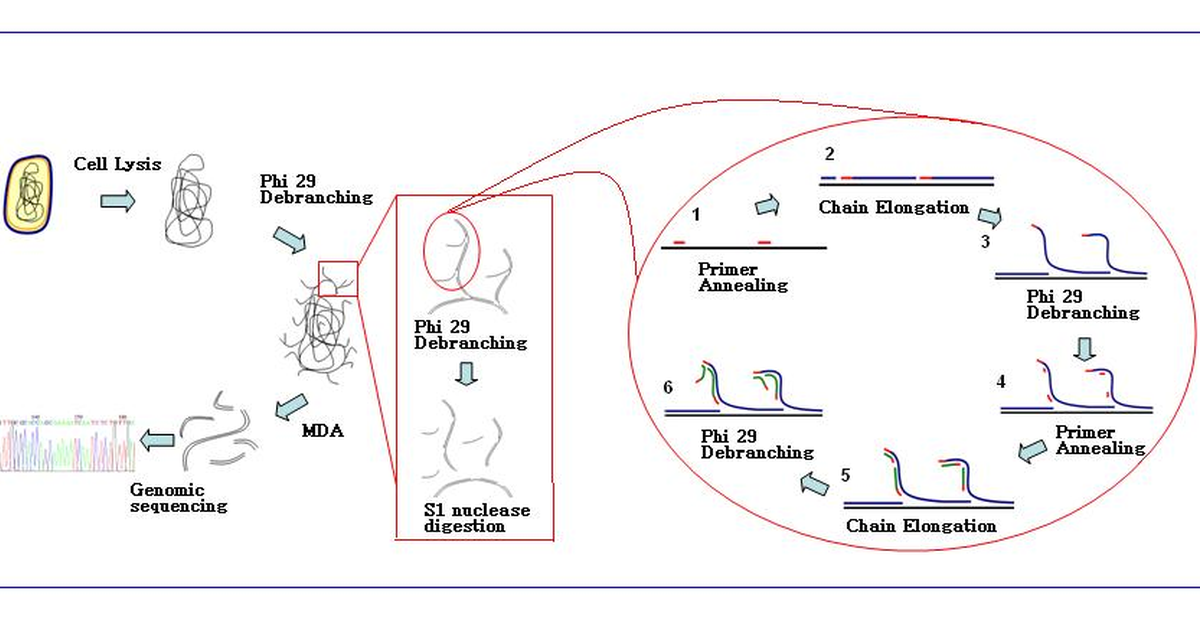
图1:单细胞测序流程示意——分离单个细胞后做全基因组扩增,再建库测序
把一块组织磨碎测序,得到的是几百万个细胞的平均值。这个平均值掩盖了细胞之间的差异——而差异往往正是问题所在。单细胞测序把分辨率推到单个细胞,让我们第一次能问「是哪一群细胞在变化」。
2026 年 9 月,PsychAD 合作组在《自然》系列期刊发表了迄今规模最大的人脑前额叶皮层基因表达图谱,覆盖 1494 名已故供体、逾 630 万份表达谱。这份工作之所以可能,靠的正是单细胞与单核测序技术的成熟。本课程沿着这条技术脉络,从实验设计讲到数据分析。
学习目标
- 理解单细胞测序相对传统转录组测序(bulk RNA-seq)解决了什么问题
- 掌握从组织解离、建库到测序的完整流程,以及每个环节的关键取舍
- 能够独立完成一次质控、降维聚类与差异表达分析
- 读懂单细胞论文中的图谱类结果,判断其结论强度
章节概览
- 为什么需要单细胞:平均值如何掩盖异质性;bulk 与 single-cell 的信息差
- 湿实验流程:组织解离、单细胞悬液制备、微流控与微孔板建库、UMI 与细胞条码
- 从序列到矩阵:比对与定量、空液滴与双细胞的判别、质控指标怎么读
- 降维与聚类:PCA、邻居图、UMAP 的适用边界;聚类分辨率不是越细越好
- 细胞类型注释:标志基因法与参考数据集映射法;注释错了后面全错
- 差异表达与拟时序:条件对比的设计陷阱;轨迹推断能说什么、不能说什么
- 多样本整合:批次效应校正;为什么大规模图谱必须做 Harmony 或类似处理
- 案例精读:以人脑前额叶皮层图谱为例,拆一篇顶刊论文的证据链
适合谁
具备基础分子生物学知识、会写 Python 或 R 的本科生与研究生。不要求先验的单细胞分析经验。
---