AI 安全入门:从提示注入到纵深防御
课程简介
大模型应用正在从"聊天框"长进"干活的手"——读网页、调工具、执行代码。每多一条通道,就多一个被注入的入口。本课程以 2026 年 10 月 WhatsApp 帮助页面隐藏指令事件为主线案例,讲清提示注入的原理、攻击面分级,以及一套不依赖"模型变聪明"的纵深防御方案。课程面向已在使用大模型 API 或 AI Agent 的开发者与产品经理,不需要安全背景。
学习目标
- 建立"指令与数据不分"的心智模型,能预判自己产品里的注入面
- 区分直接注入与间接注入,针对后者设计内容边界与工具权限
- 搭建"假设注入成功"的运行时防线:凭证最小化、网络隔离、操作审计
- 评估开源模型供应链风险,会读一份模型安全报告
- 把防御清单落地为 CI 检查与上线前评审项
章节概览
- 第一章:上下文即一切——大模型如何看待你给的所有文本
- 第二章:直接注入——越权、套话与提示泄露的攻防
- 第三章:间接注入——网页、邮件与工具返回里的暗箭(WhatsApp 事件全解剖)
- 第四章:Agent 的权限账本——凭证、沙箱与网络分段
- 第五章:开源模型供应链——后门模型、abliterated 权重与基准测试的盲区
- 第六章:把防御写进流程——评审清单、红队测试与事件响应
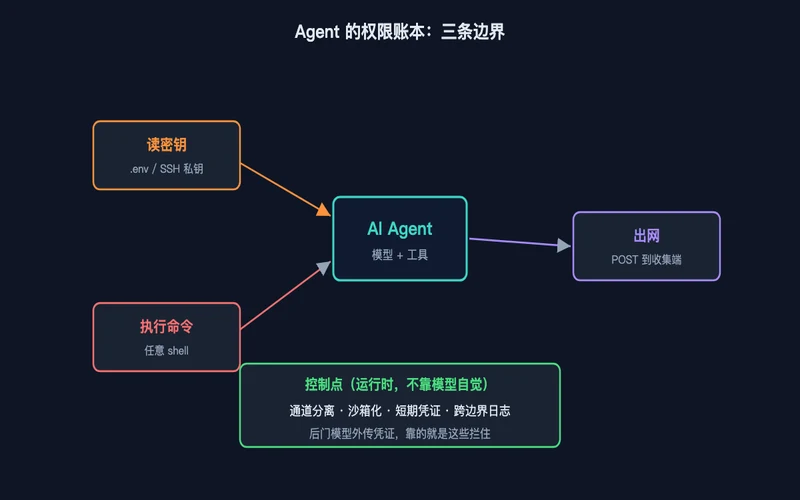
图2:Agent 权限账本——读密钥、执行命令、出网三条边界,控制点全部放在运行时
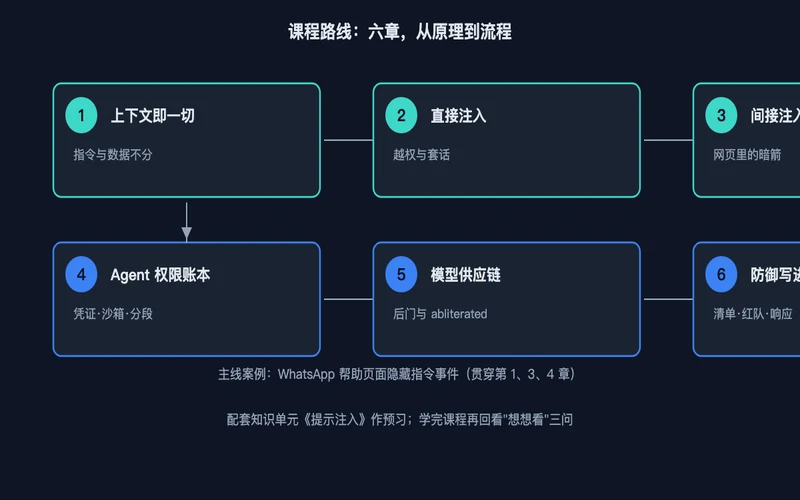
图1:课程六章路线图,WhatsApp 事件作为主线案例贯穿第 1、3、4 章
配套知识单元《提示注入:你读的网页里,可能藏着给 AI 看的指令》可作为预习材料;学完本课程再回看单元里的"想想看"三问,会有不一样的答案。