零阶优化与反向传播——当算力足够便宜,我们还需要处处可微吗?
完成本课后,你将能够:
- 用一句话讲清反向传播在 40 年里的位置,以及它依赖的"处处可微"前提;
- 说出零阶优化(Zeroth-Order Optimization)的核心思想,以及在哪些场景它比梯度更现实;
- 解释 Dust 为什么把扰动从"权重空间"搬到"激活空间",以及"虚拟种群"是怎么借 token 维度省算力的;
- 对着一篇新出的训练方法论文,能判断它是在"绕开可微"还是在"优化可微"。
- 第 1 章 · 梯度统治的四十年:1986 年那篇论文做了什么,链式法则如何长成今天的硬件生态
- 第 2 章 · 零阶优化的直觉:不用导数,只靠"试"能逼近梯度吗?有限差分与随机扰动
- 第 3 章 · 权重空间 vs 激活空间:为什么在权重上扰动会随模型变大而爆炸,Dust 的搬移怎么解
- 第 4 章 · 虚拟种群:一个序列、几千个 token,如何一次前向并行"试"出成千上万份扰动
- 第 5 章 · 反直觉的结果与冷水:越大越灵的趋势、贵几个数量级的代价、第三方的复现结论
- 第 6 章 · 还差什么,以及该问什么问题:Dust 不是终点,它是"还需要处处可微吗"这个问题的重启键
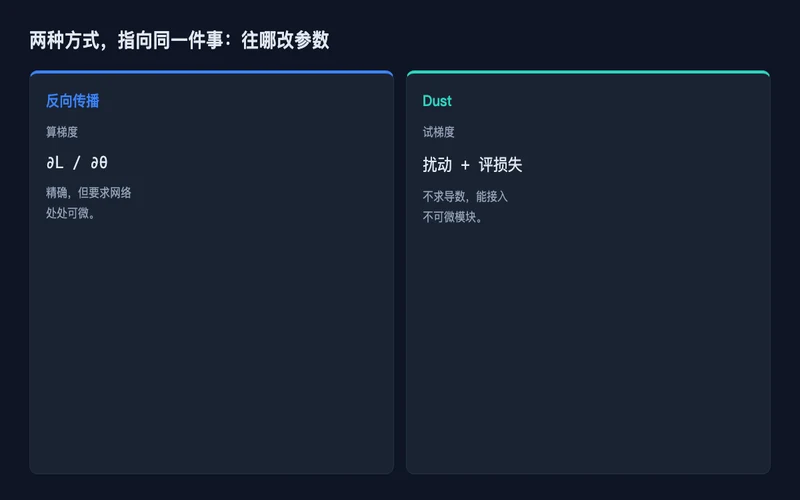
图1:课程六章路线
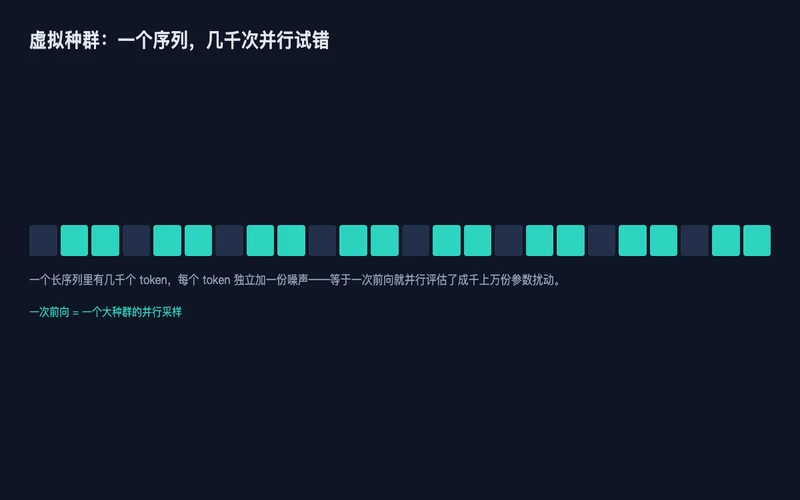
图2:从大语言模型到零阶训练的技术路线位置