统计语言模型动手课:从计数表到困惑度
课程简介
这门课不追新模型。它把语言模型最底下的那层拆开:一句话怎么变成计数,计数怎么变成概率,没见过的组合怎么留余量,以及我们凭什么说一个模型比另一个好。四章写完,你手里会有一个能跑的二元语法模型、一份自己的困惑度实验,和对「评估」这件事的基本警惕。
配套知识点是「新句子的概率不该是零:统计语言模型里的平滑」。课程里会把那个知识点里的公式展开成完整代码,再加一层独立验证集的实验设计。
学习目标
- 从零实现 bigram 计数、加一平滑、回退插值,并解释三者在零样本上的差别
- 手算并代码实现困惑度,说清它随词表大小、语料规模变化的方向
- 设计一个不泄漏的 train/dev/test 切分,识别「测试集进过训练集」这类污染
- 读完一篇模型论文的结果表,能指出哪些结论有独立验证支撑、哪些只是同一份数据上的分数
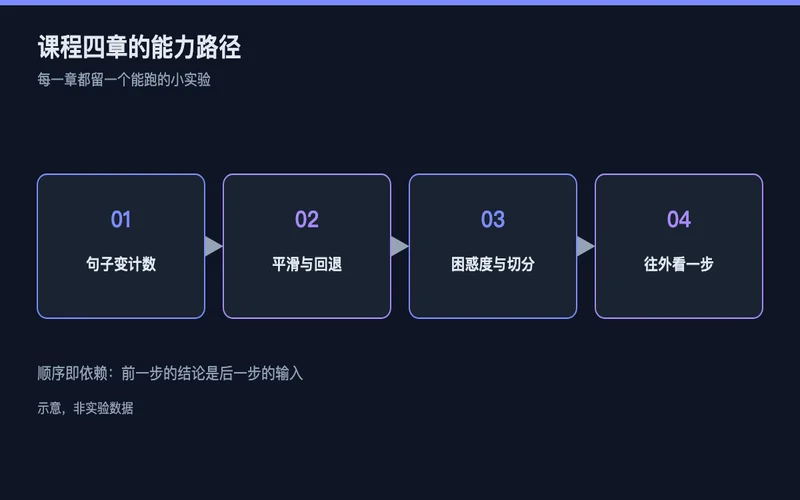
图1:课程四章的能力路径
章节概览
- 第一章 从句子到计数:分词、词表、MLE 与零概率问题
- 第二章 平滑与回退:加一、插值、Kneser–Ney 的动机,动手比较三者在未见词对上的表现
- 第三章 评估:困惑度的推导、独立验证集、过拟合与分布偏移
- 第四章 往外看一步:n-gram 到神经语言模型,参数规模变大之后哪些老问题没变
一个必须先讲清的规矩
课程里所有分数都要求在同一套 held-out 数据上报告。训练集上算出来的困惑度没有比较价值。这条规矩在 2011 年 Norvig 列工程清单时是默认前提,到了 2026 年反而经常被漏掉。站内那篇讲 AI 医疗评测翻车的文章,说的其实是同一件事。
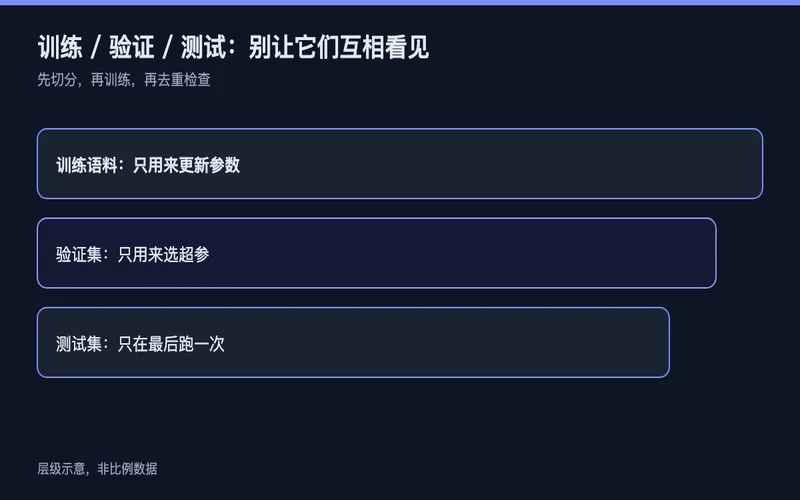
图2:训练语料、验证集、测试集怎么 split
核心信息来源
课程结构、代码练习与切分示意均为本文自编,非官方课程大纲。概念依据:Norvig 2011 年文章(norvig.com/chomsky.html)关于平滑、Gold/Horning 与评估口径的讨论;Leo Breiman, Statistical Modeling: The Two Cultures(2001)关于 data modeling / algorithmic modeling 的划分。第二章 Kneser–Ney 部分建议配合原始论文阅读,课程只讲动机,不复现完整推导。