LLM 工具调用机制详解:从提示工程到约束解码
大语言模型的工具调用(Tool Calling)是 AI Agent 的核心能力。本文深入解析工具调用的底层机制——从带内信号标记到约束解码,揭示为什么更强大的模型有时反而在工具遵循上表现退化,以及开发者应如何设计更可靠的工具接口。
当你让 LLM 调用一个外部工具——比如查询数据库、编辑文件、发送邮件——这背后发生的事情远比表面看起来复杂。工具调用(tool calling,也称 function calling)是现代 AI Agent 的基石,但它的实现机制常常被开发者误解为某种"魔法"。实际上,它是一种精巧的带内信号(in-band signaling)协议。
工具调用的本质:带内信号
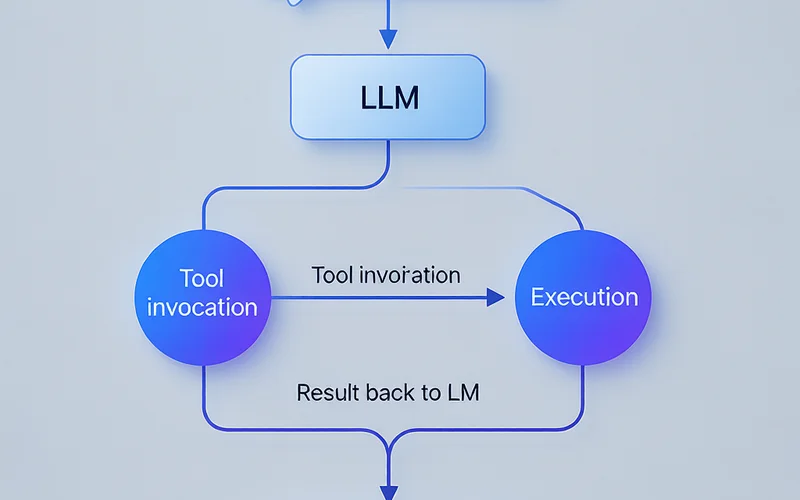
图1:LLM 工具调用的完整流程——从用户消息到工具执行再到最终响应
工具调用并不是模型内置的特殊能力,而是通过提示工程和训练实现的一种约定。当开发者向 API 提交工具定义时,服务端会将工具的 JSON Schema 嵌入到系统提示中,用特殊的标记 token(marker tokens)包裹。模型在训练阶段学习了这种格式,在生成时如果"决定"调用工具,就会输出符合约定格式的文本。
以 Anthropic 的模型为例,工具调用的输出可能长这样:
    src/main.py

[
  {
    "oldText": "print('hello')",
    "newText": "print('world')"
  }
]
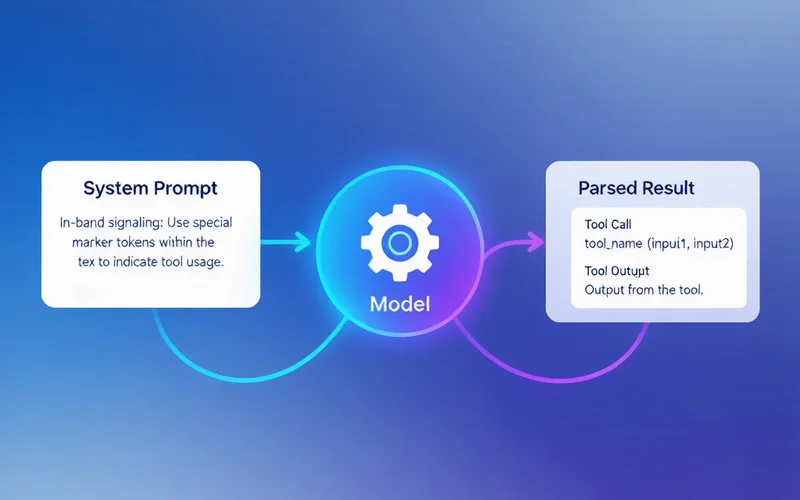
图2:带内信号机制——工具 schema 通过特殊标记嵌入系统提示
注意一个关键细节:这看起来像 XML,但实际上并不是真正的 DOM 解析。顶层的字符串参数直接内联在标签中,而嵌套的数组/对象参数则通过 JSON 序列化嵌入。这种混合编码方式在高熵区域(如长字符串结束后)容易产生格式错误。
两种实现路径:自由生成 vs 约束解码
让模型生成符合 schema 的工具调用,有两条技术路线:
- 自由生成 + 后验证:让模型自由生成文本,然后用 JSON Schema 验证器检查结果。如果验证失败,将错误信息反馈给模型重试。这种方式灵活但不可靠——模型可能反复生成同样的错误格式。
- 约束解码(constrained decoding):在采样阶段直接屏蔽不符合语法的 token。如果 schema 只允许
oldText和newText两个字段,采样器会阻止模型生成"requireUnique"等非法键名。这种方式更可靠,但可能影响生成质量。
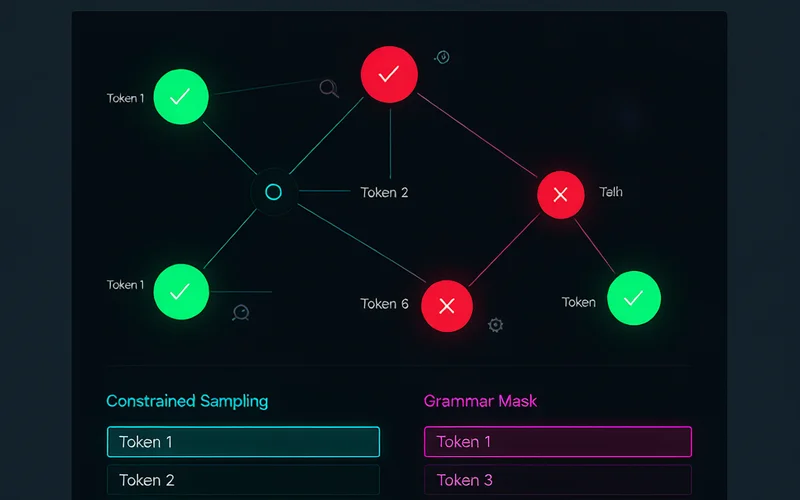
图3:约束解码——采样阶段屏蔽不符合语法的 token
OpenAI 的 harmony 响应格式采用了类似思路:模型通过 <|constrain|>json 标记声明接下来的内容是 JSON,推理引擎据此切换到 JSON 约束采样模式。
为什么更强的模型可能更差
一个反直觉的现象是:新一代模型在某些工具调用场景中反而比旧模型表现更差。Armin Ronacher(Flask 作者)最近发现,Anthropic 的 Opus 4.8 和 Sonnet 5 在调用非标准工具接口时,会"发明"不存在的参数字段(如 requireUnique、oldText2、matchCase 等),而旧模型没有这个问题。
根本原因在于RL 后训练的副作用。现代模型在 Claude Code 等封闭 harness 中进行强化学习,而这个 harness 对工具调用错误非常宽容——它会静默修复畸形参数、过滤未知字段、提供参数别名。在这种环境中,稍微畸形的工具调用仍然能完成任务并获得奖励,模型因此缺乏"不要发明字段"的梯度信号。
更麻烦的是,模型可能对 Claude Code 的扁平化编辑工具格式(file_path + old_string + new_string)形成了强先验。当遇到不同的工具 schema 时,这个先验反而成了障碍——模型"知道"编辑操作应该有一个额外字段,但在新 schema 下不知道该叫什么名字,于是每次随机猜测一个。
开发者的应对策略
- 启用 strict 模式:Anthropic API 提供
strict参数,启用服务端约束解码,从根源上阻止非法字段的生成。 - 工具 schema 尽量扁平:避免深层嵌套的数组和对象,减少高熵区域的格式错误风险。
- 不要假设模型会遵循文档:工具 schema 不是中性契约,某些形状更接近模型训练分布,某些则更远。设计接口时要考虑模型的"偏好"。
- 用外部测试套件验证:像 Phargo 项目那样,用别人写的测试用例验证模型行为,而不是让模型给自己的输出打分。
工具调用是 AI Agent 走向可靠工程的关键一环。理解它的底层机制——而不是把它当成黑盒——是构建生产级 Agent 系统的前提。随着模型能力的提升,工具调用的可靠性问题不会自动消失,反而可能因为训练分布的收窄而加剧。开发者需要更深入地理解这套机制,才能设计出既安全又高效的工具接口。