基因组里 98% 不编码蛋白,那它在做什么
人类基因组约 30 亿碱基,只有 2% 直接编码蛋白质。剩下那 98% 曾在 1970 年代被叫作“垃圾 DNA”。这篇讲它后来怎么被重新认识:启动子、增强子、剪接信号、绝缘子,以及为什么读懂它比读到它难得多。
本节你将能
- 说清“非编码区”这个词在不同年代指的三件不同的事
- 列出四类常见调控元件,并说明各自的失效后果
- 解释为什么一个不在蛋白编码区里的变异也能致病
- 判断一段变异效应预测的证据强度,知道它离临床诊断还差几步
直觉模型:把基因组想成一份带批注的说明书
如果基因组是一本书,蛋白质编码区是正文——那些真正被翻译成氨基酸序列的句子。剩下 98% 不是空白页,而是页边批注、目录、页码和印刷说明:它们不进入最终成品,却决定正文在第几页、印多少份、什么时候停。
1972 年,遗传学家 Susumu Ohno 用 junk DNA 称呼这部分序列。当时这么叫有它的道理:从“翻译出蛋白质”这一条标准看,它们确实什么都不做。问题出在标准本身太窄。
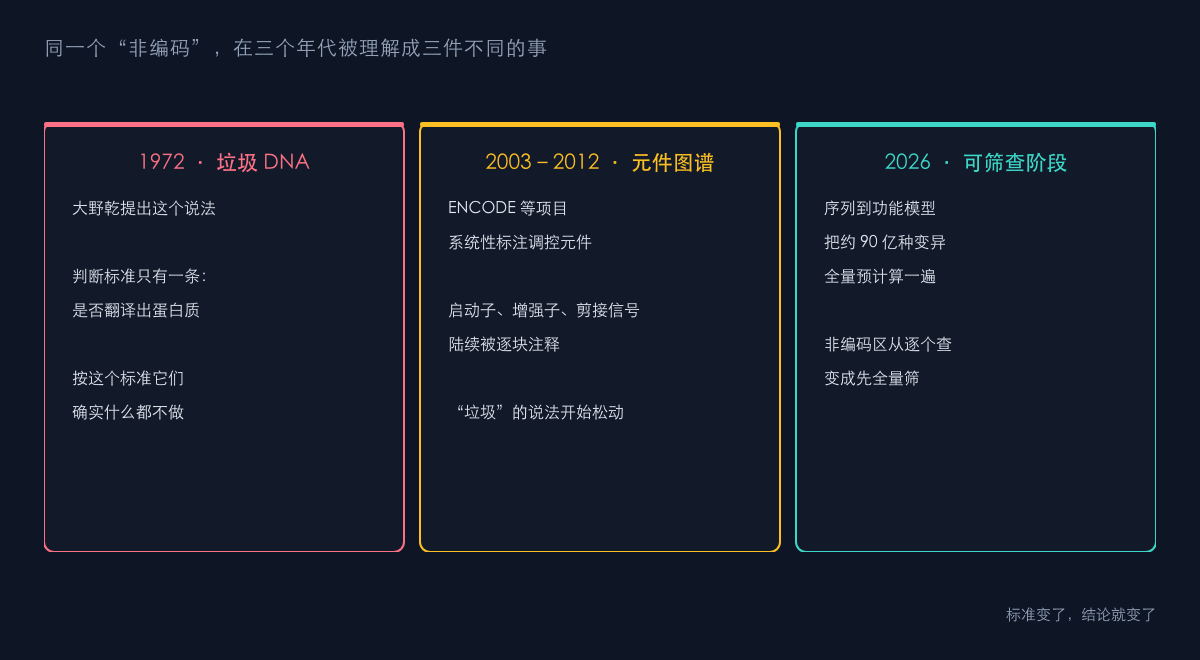
图1:同一个“非编码”,在三个年代被理解成三件不同的事
四类调控元件,各自管一件事
今天能在数据库里查到的非编码功能元件,大致可以归成四类。它们的共同点是:本身不被翻译,但序列改变会改变下游基因的“产量”或“场合”。
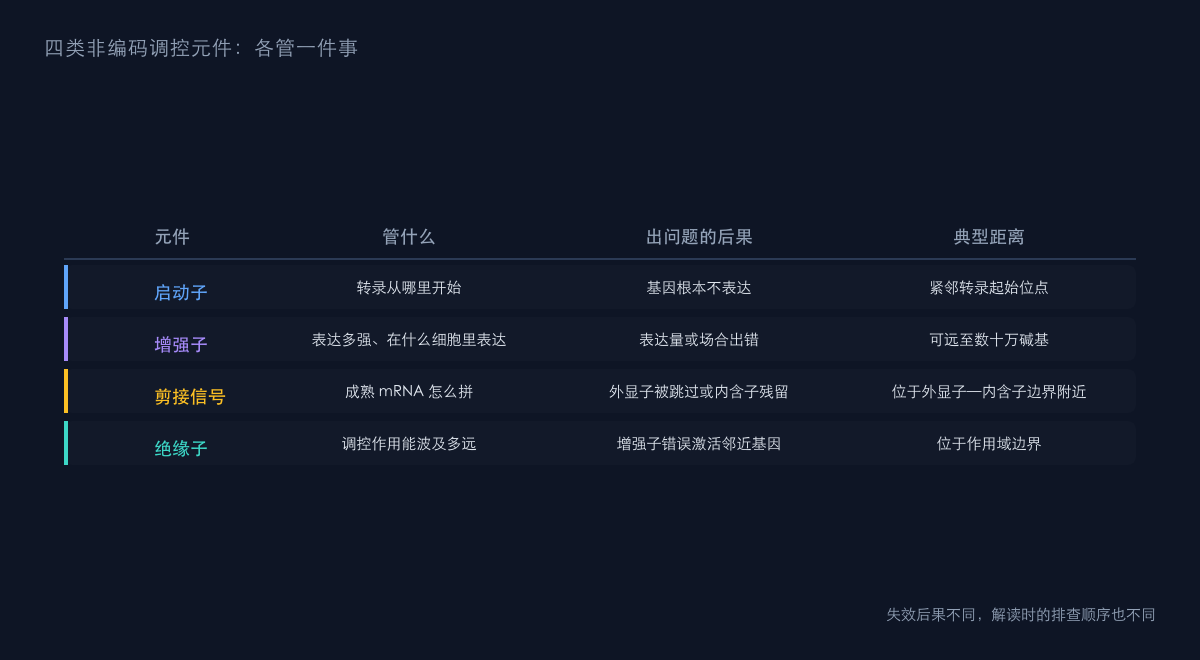
图2:启动子、增强子、剪接信号、绝缘子,坏掉的后果各不相同
为什么非编码变异这么难判
一个错义变异落在编码区,解读路径相对直接:氨基酸变了,蛋白结构或活性可能受影响,ACMG 的变异分类指南也是在“蛋白功能受损”这套逻辑上长出来的。
非编码变异没有这条捷径。它可能出现在一个只在胚胎第 12 周、只在某种神经元里才起作用的增强子上;可能只是把某个转录因子的结合亲和力从 0.9 降到 0.7,生物学后果要在特定刺激下才显现;也可能它影响的那个基因离它 80 万碱基远,中间隔着两三个无关基因。
全基因组关联研究(GWAS)十几年积累下来的结果是:与复杂性状和疾病相关的位点,绝大多数落在非编码区。找到位点只是第一步,从“统计上相关”走到“这个碱基改变了某个调控事件”,中间还隔着功能验证。
计算模型补上了哪一段
实验上做饱和诱变——把某个区域的每个碱基依次改一遍再测表型——成本高到只能覆盖很小的区域。序列到功能的深度学习模型做的是另一件事:用已有的大量表观基因组实验数据训练,然后对一个从未测过的变异给出预测。
这类模型通常同时输出多种读数,比如基因表达量、RNA splicing、染色质开放性、转录因子结合。2026 年 9 月,Google DeepMind 把这类预测推到了极限:对 hg38 参考基因组上约 90 亿种可能的单核苷酸变异全部预计算一遍,打包成 AlphaGenome Atlas 发布,数据体量约 1 PB。
这一步的意义不在“算得更快”,而在把非编码区从“只能逐个查”变成“可以先全量筛一遍,再挑可疑的做实验”。
核心要点
- 非编码区不是没有功能,而是功能不在“翻译”这条路上,早期缺乏检测手段时容易被当成背景
- 启动子决定起点,增强子调节强度与场合,剪接信号决定成熟 mRNA 的拼法,绝缘子划定作用范围
- 非编码变异的致病性判断,难点在“细胞类型 × 发育阶段 × 作用距离”三维组合
- 模型预测是筛选工具,不是诊断结论;实验验证仍是把候选变成证据的必经环节
自测
如果一个变异落在某基因内含子深处、离最近的外显子边界还有 200 个碱基,它最可能通过哪种机制致病?想清楚这个问题,你就抓住了非编码解读的关键。