量子纠错:用一堆不靠谱的比特,换一个靠谱的
量子比特极其脆弱,今天最好的硬件大约每一千次操作就会出错一次。经典计算机靠复制备份纠错,但量子态不可克隆,这条路走不通。1995 年起,研究者改用纠缠把信息摊到多个物理比特上,只测量"哪里出错"而不读出信息本身,从而绕过不可克隆定理。1996 年前后确立的阈值定理证明:只要物理错误率低于某个临界值,加大编码规模就能让逻辑错误率指数下降。2024 年 12 月,谷歌 Willow 处理器第一次在实验中跨过这条线:码距每增加 2,逻辑错误率下降 2.14 倍。
本节你将能
读完本单元,你应该能:
- 说清楚为什么经典计算机的"复制备份"套路在量子世界里直接失效。
- 解释 QEC 如何在不读取量子信息的前提下发现错误。
- 讲出阈值定理的含义,以及 2024 年谷歌 Willow 实验跨过的那条线意味着什么。
- 说明"通用门集"为什么是容错量子计算的第二个门槛,以及 2026 年非阿贝尔任意子路线在这一步上的进展。
直觉模型
把经典比特想成抄在纸上的一句话。怕抄错,就多抄几份,对不上时少数服从多数。量子比特不行——no-cloning theorem禁止你把一份未知的量子态复制成两份,测量又会把它当场塌缩掉。你既不能备份,也不能直接偷看。
于是换了思路:不复制信息,而是把一份信息"摊"到多个物理比特的纠缠态里。这样任何一个比特单独出错,都不会动到信息本身,只会在相邻比特之间留下可探测的痕迹。纠错电路周期性检查这些痕迹(称为 syndrome),只回答"哪里错了、错成什么样",不回答"你存的是什么"。知道错在哪就能纠正,而真正的量子信息从头到尾没被读过。
核心要点
一、从"不能复制"到"摊开存"。1995 年,彼得·肖尔(Peter Shor)给出第一个能纠正任意单比特错误的量子纠错码,用 9 个物理比特编码 1 个逻辑比特;几乎同时安德鲁·斯蒂恩(Andrew Steane)提出 7 比特版本。这类编码的核心手法是比特翻转与相位翻转分开处理:量子错误是连续的,但一旦被投影测量,就只剩下有限几种离散类型需要处理。这个"连续转离散"的技巧,是整套纠错体系能成立的第一步。
二、阈值定理:一条把工程问题变成数学问题的分界线。1996 到 1997 年间,多方工作汇成结论:只要物理错误率低于某个临界值(阈值),并且错误在空间和时间上足够局域,那么增加码距(code distance)带来的额外错误,会被纠错能力压过去,逻辑错误率随码距指数下降。反之,物理错误率一旦高于阈值,堆再多的比特只会更糟。这条定理把"量子计算机能不能造出来"从一个无底洞式的工程难题,变成了"把单次操作错误率降到百分之几以下"这个明确目标。表面码(surface code)的阈值大约在 1% 量级,具体数值随噪声模型不同落在 0.5% 到 1.1% 之间。
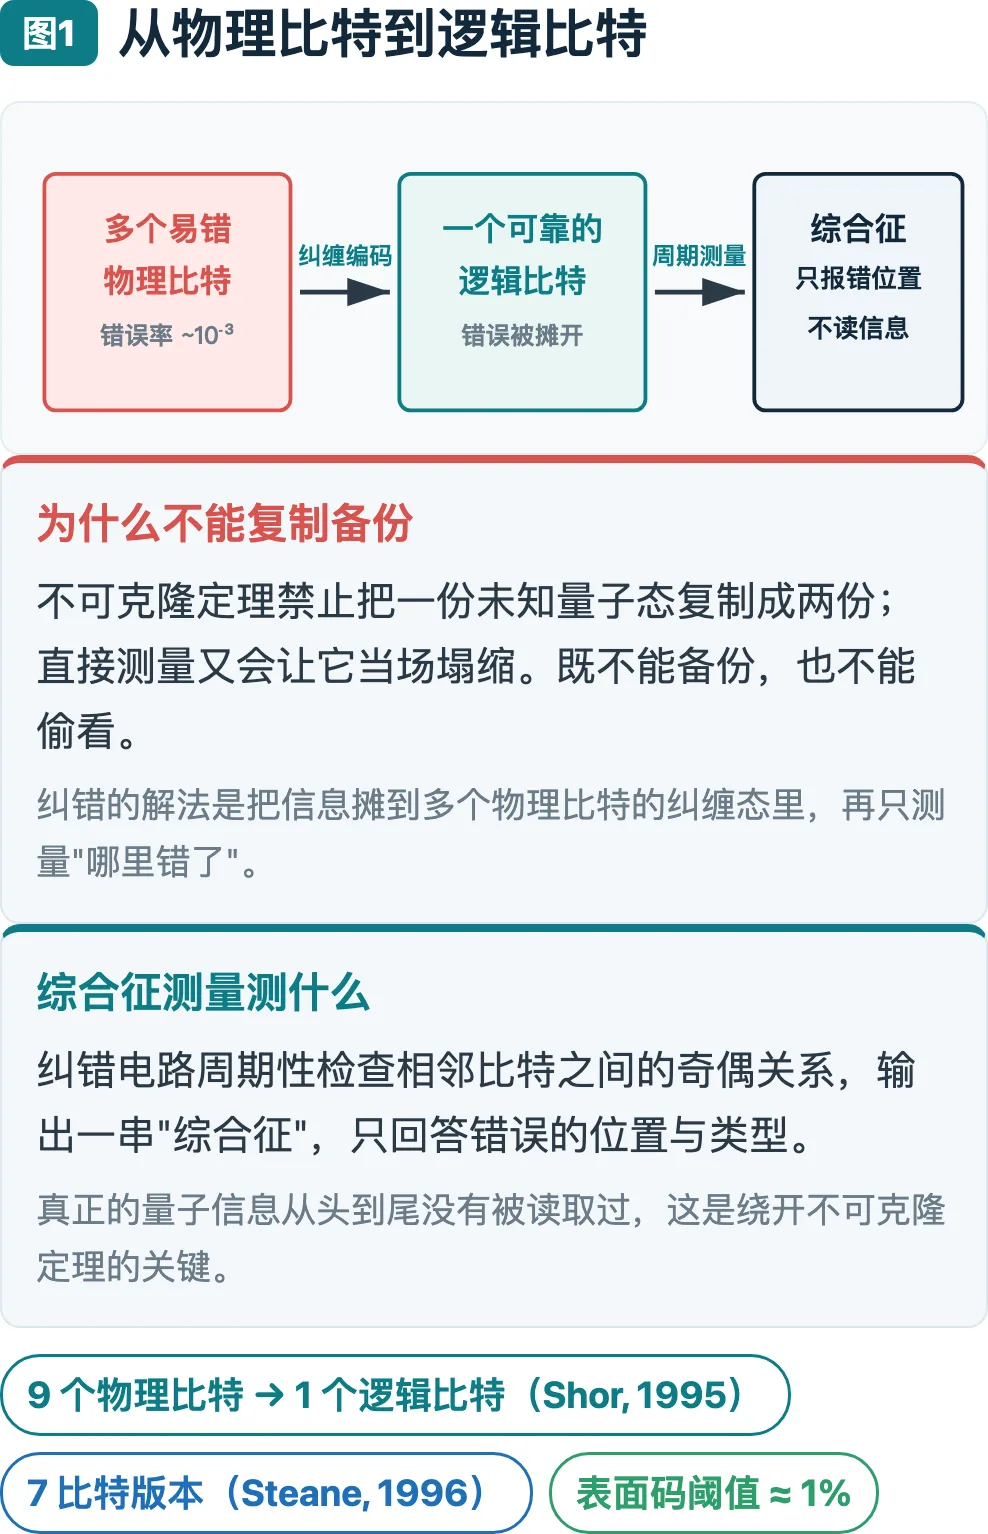
多个易错的物理比特通过纠缠编码成一个逻辑比特;纠错电路周期性测量综合征,只报错位置而不读取信息内容
三、2024 年 12 月:第一次真正跨过阈值。阈值定理在纸上等了近三十年。谷歌量子人工智能团队在 105 量子比特的超导处理器 Willow 上报告了结果,论文《Quantum error correction below the surface code threshold》于 2024 年 12 月 9 日发表于《自然》。相比上一代 Sycamore,Willow 的平均 T1 从约 20 微秒提升到 68 微秒。团队跑通了码距 5 与码距 7 的表面码:码距每增加 2,逻辑错误率下降 Λ = 2.14 ± 0.02 倍。码距 7 的码用了 101 个物理比特,每轮纠错的逻辑错误率为 0.143% ± 0.003%,寿命超过其最好的单个物理比特 2.4 ± 0.3 倍——这是"纠错后的量子比特比组成它的任何零件都活得更久"的首次实证。实时解码在码距 5 上的平均延迟为 63 微秒,而纠错周期只有 1.1 微秒。
实验也留下了新的问题。团队把重复码(repetition code)一直做到码距 29,发现逻辑性能最终被一类罕见关联错误卡住:大约每小时发生一次,相当于 3×10⁹ 个周期一次,成因尚未弄清。这类事件给重复码设下了 10⁻¹⁰ 量级的错误地板。它提醒我们,跨过阈值不等于高枕无忧——下一个台阶来自机制未明的物理。
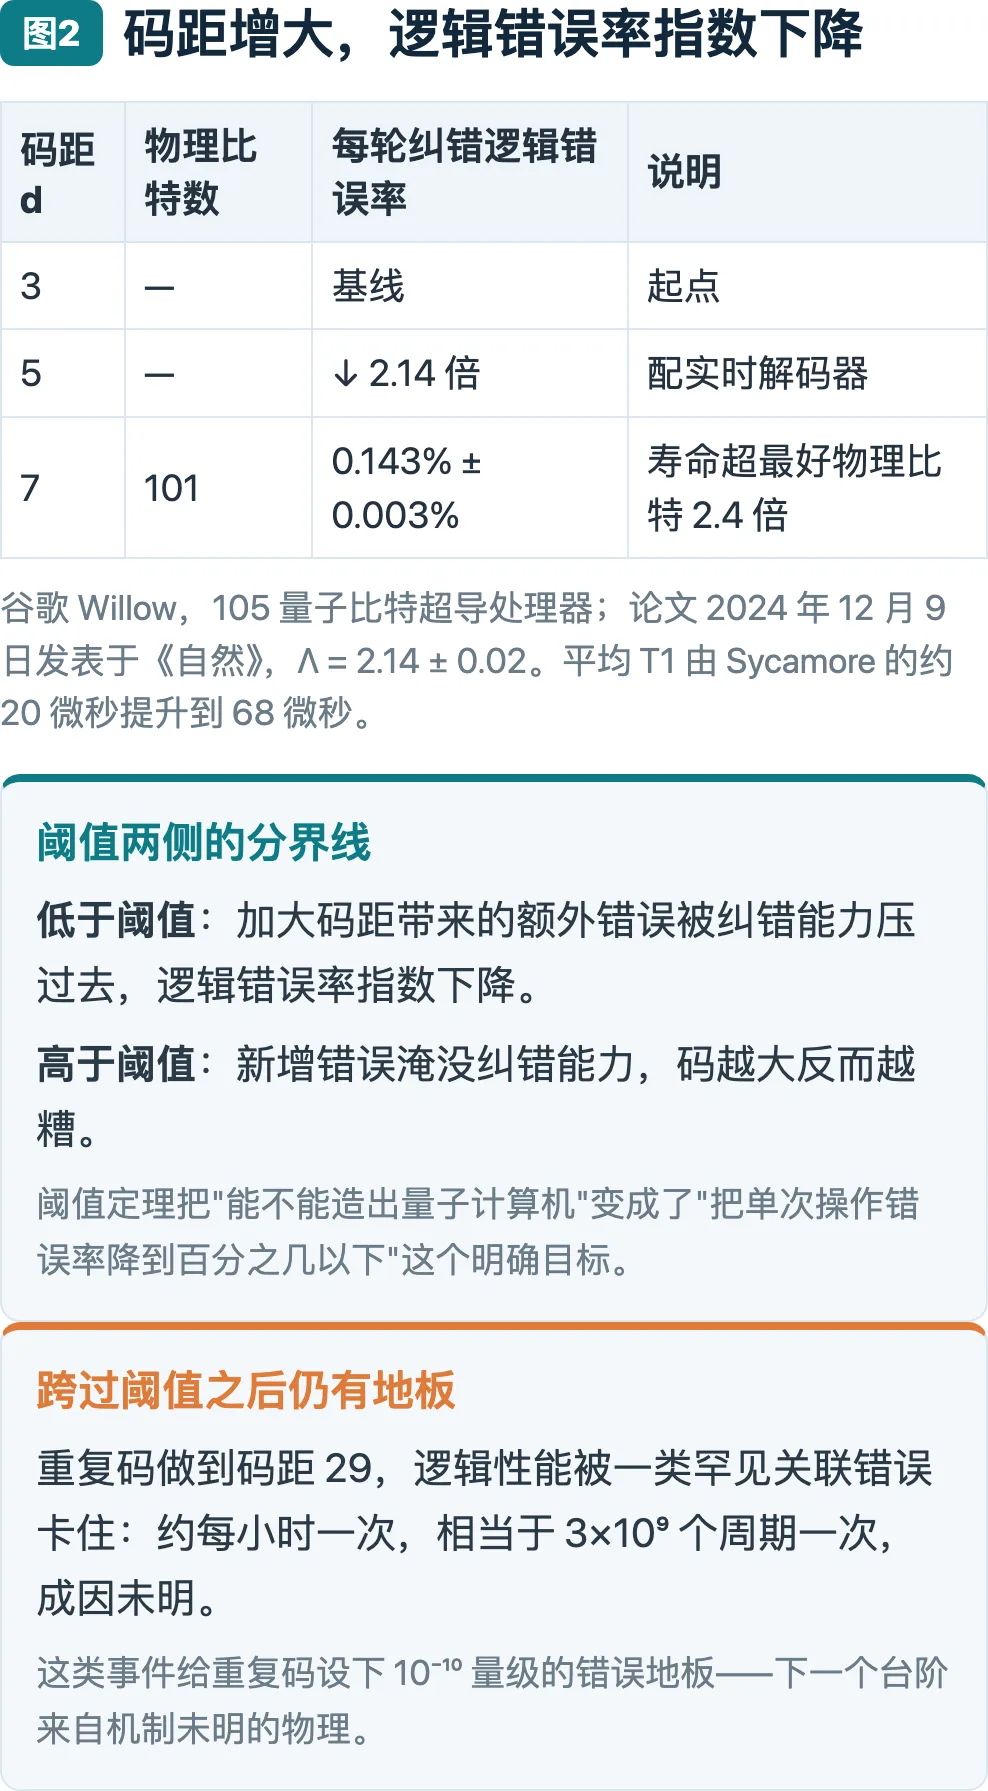
Willow 上码距 3、5、7 的表面码逻辑错误率对比;码距每加 2 逻辑错误率下降 2.14 倍,码距 7 已越过"盈亏平衡点"
四、存得住还不够,还得算得动。纠错只解决"记住",通用计算还需要一整套逻辑门。表面码这类编码天然提供的门不多,缺的那部分通常用"魔态"(magic state)补上,而制备高保真魔态要经过蒸馏(distillation)——反复提纯,消耗大量物理比特与操作,是容错架构里最贵的一笔开销。
2026 年有一条新路线走到了这一步。芝加哥大学、哈佛大学、石溪大学与 Quantinuum 的团队在 H2 离子阱处理器上,用 54 个量子比特制备出基于 S₃ 对称群的非阿贝尔任意子态,把信息编在三能级的拓扑量子三态(qutrit)里。他们组合了两种操作:braiding提供一个纠缠门,fusion测量提供另外两个编织给不了的操作,三种合起来构成通用门集;魔态则是直接用拓扑操作制备出来的,绕开了蒸馏。两条融合通道的投影保真度分别为 0.987(2) 与 0.962(4)。这是非阿贝尔编码中首次演示通用门集,但要注意它仍是原理验证——实验没有跑主动纠错,也没有展示逻辑错误率随编码规模下降。
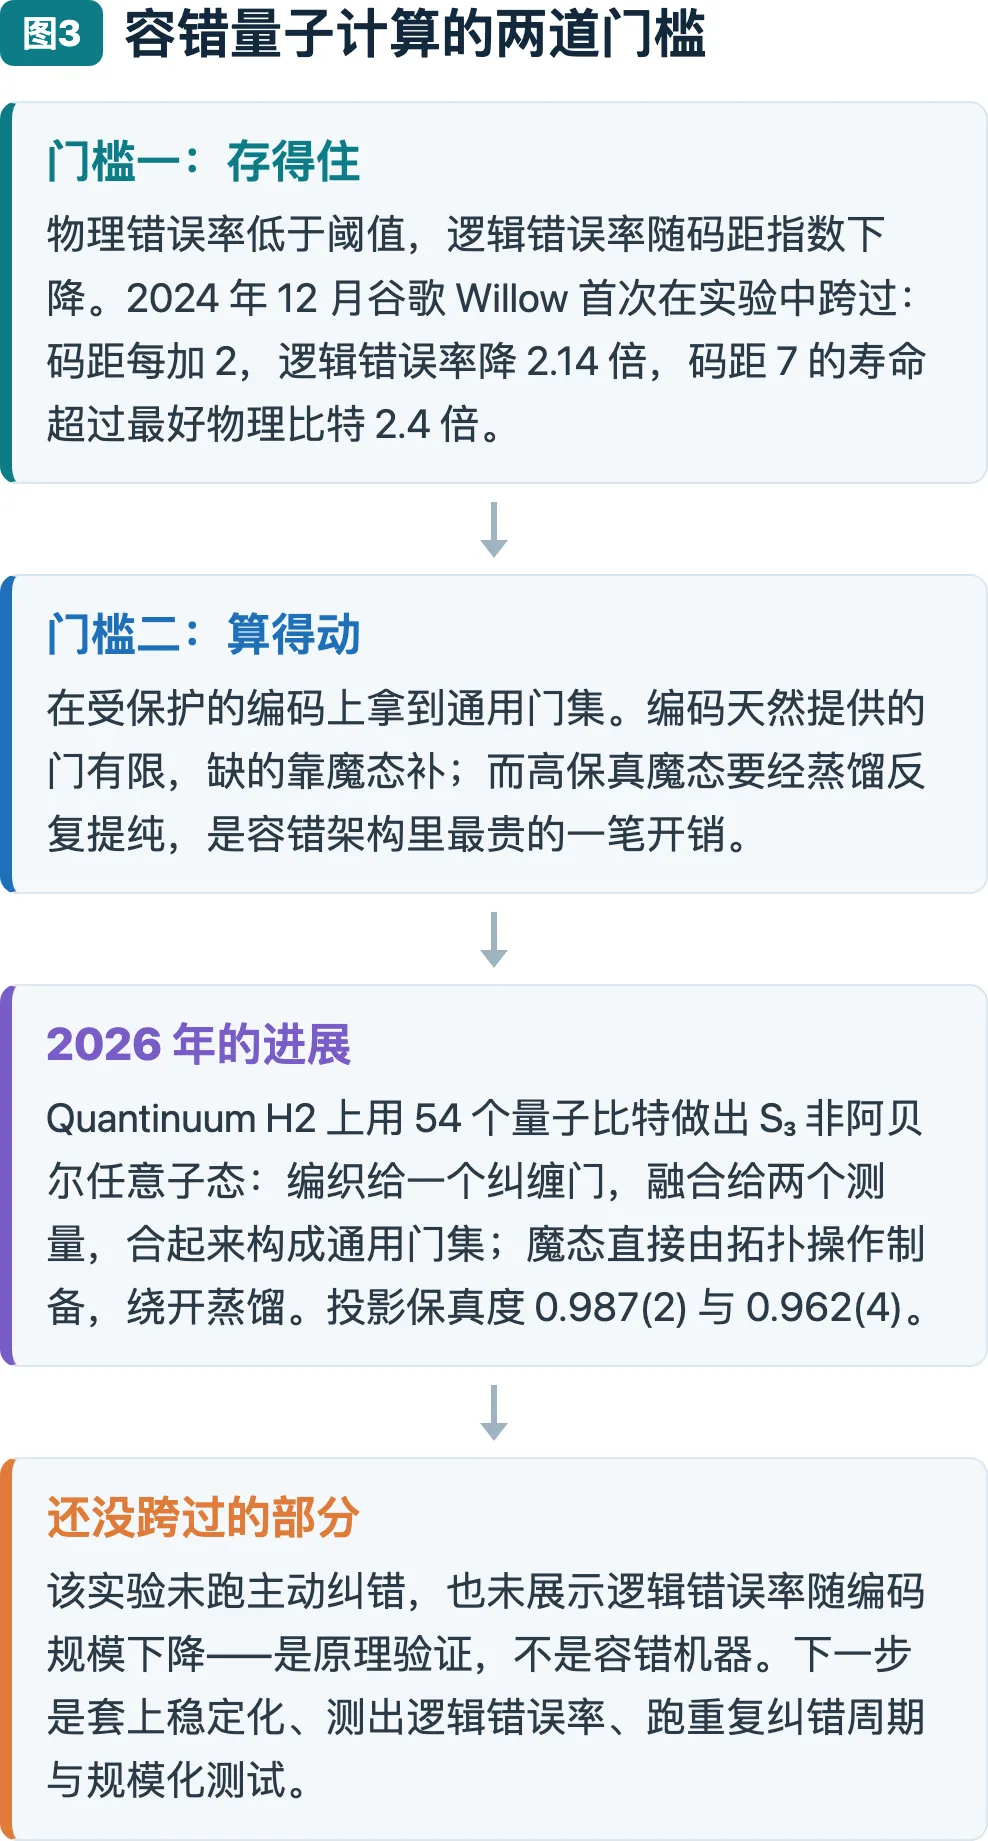
第一道门槛:物理错误率低于阈值、逻辑错误率随码距指数下降;第二道门槛:在受保护编码上拿到通用门集
常见误解
"纠错就是把量子态复制几份。"不行。不可克隆定理禁止复制未知量子态,纠错走的是纠缠编码加综合征测量这条路。
"跨过阈值就能做通用计算了。"两件事。阈值定理保证的是"存得越来越好",通用门集是另一道独立门槛,其中魔态制备往往是开销最大的部分。
"逻辑错误率会一直降下去。"Willow 的重复码实验显示,罕见关联错误会形成地板。码距越大,这类稀有事件越可能成为新的瓶颈。
---