科学辟谣的底层方法:为什么"眼见的数据"也会骗人
从"相关不等于因果"到"可重复性危机",拆解几类最常见的认知陷阱。让你看到一条新闻、一组数字时,先问三个问题,而不是先转发。
本节你将能
读完你会明白:为什么"喝咖啡致癌""某食物防癌""玩游戏变聪明"这类标题年年换,却总经不起推敲。问题往往不在数据本身,而在我们怎么读数据。
陷阱一:相关不等于因果
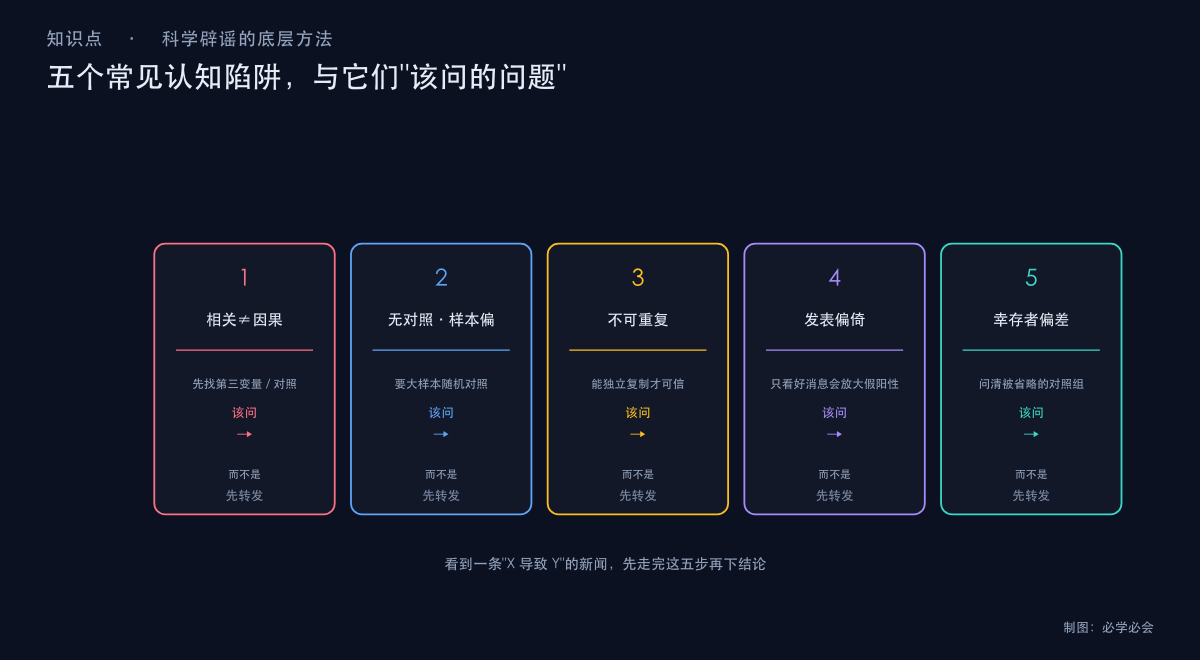
冰淇淋销量和溺水人数高度正相关——但谁都知道吃冰淇淋不会让人溺水,背后是"夏天"这个共同原因。很多新闻把"同时发生"直接读成"因为所以",这是误读的第一重来源。读任何"X 导致 Y"之前,先问:有没有第三变量?是不是反过来(Y 导致 X)?有没有对照实验?
陷阱二:没有对照,或样本有偏
"我邻居家吃了某保健品好了"是个例,不是证据。一个结论要靠大样本、随机、有对照的研究才能站住。样本只来自特定人群(比如大学生、比如某一国),结论却推广到全人类,也会翻车。
陷阱三:可重复性危机
一个实验做一次"显著",不代表它可靠。心理学、生物医学近年均曝出大量"做不出来"的著名结果:棉花糖实验、斯坦福监狱实验都在复核中打了折扣。能独立重复,才接近真相。
陷阱四:发表偏倚
期刊偏爱"好看"的显著结果,于是大量"没效果"的研究默默躺在抽屉里不发表。你看到的新闻,可能只是所有研究里最乐观的那一小撮——这叫"抽屉文件问题"。
陷阱五:幸存者偏差
只看到"活下来"的样本就会得出错误结论。比如"辍学创业也能成"——你没看到的是成千上万失败的人。解读任何"成功学数字"时,先想:被省略的对照组长什么样?
核心要点
- 看到"X 导致 Y",先找第三变量和对照实验。
- 个例和轶事不是证据,大样本随机对照才更接近真相。
- 能独立重复的结果,比一次性"显著"更可信。
- 只报好消息的发表环境,会系统性放大假阳性。