不反向传播也能训练大模型?Dust 把 1986 年的设想往前推了一步
反向传播自 1986 年起就是训练神经网络的唯一主流算法。2026 年 10 月,Q Labs 的 Dust 用一种"给激活加噪声、看谁让损失下降"的零阶方法,在 Transformer 预训练上第一次和反向传播正面对上了。它还没法替代反向传播,但撬动了一个老问题:当算力足够便宜,我们还需要处处可微吗?
本节你将能
说清为什么反向传播成了 40 年的默认选择;讲明白 Dust 不碰权重、只动激活的"笨办法"到底怎么估出梯度;知道为什么圈内一边兴奋、一边又把它泼了一盆冷水。
先想清楚:学习有两种
一个网络有上亿个参数,要让它在任务上变好,本质上是"往哪个方向改参数"。最主流的答案是算梯度——损失函数对每个参数的偏导数,告诉你每个参数该加一点还是减一点。这叫解析梯度,精确、高效、能被硬件加速。
Dust 走的是另一条路:不计算梯度,而是随机扰动网络、看改动让它变好还是变坏,变好的方向就留、变坏的就扔。这叫零阶优化。它笨,但有个好处——不管网络内部能不能求导、模块可不可微,它都能用。
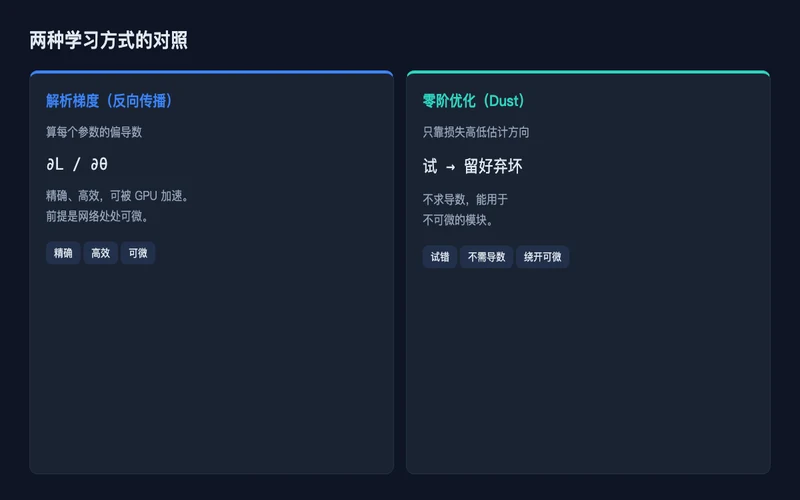
图1:解析梯度(算方向)与试错搜索(试方向)是两种信用分配方式
反向传播为什么这么难被取代
1986 年 Rumelhart、Hinton 和 Williams 把反向传播讲清楚之后,整个深度学习生态都围着"可微"长出来了:链式求导、自动微分、GPU 上高度优化的矩阵运算,甚至硬件本身都假设你在算梯度。想绕开它,等于和一套运行了 40 年的基础设施作对。
Dust 的笨办法,这次有点不一样
传统零阶方法要在权重空间做扰动:复制多份略不同的模型,各自跑一遍前向,再比谁好。模型越大,代价越爆炸。Dust 把扰动搬到了激活空间:不复制权重,而是给每个线性层的输出加一份高斯噪声,并且在每个 token 上独立地加。
这样一来,一个序列里有几千个 token,每个 token 就像在体验一份略不同的参数。一次前向传播就能并行"试"几千个样本,Q Labs 管这叫虚拟种群。哪个噪声让损失降了,就给它记功;把记功后的噪声加权平均,就近似出梯度。残差混合那 2L 个标量还留在普通权重扰动上。
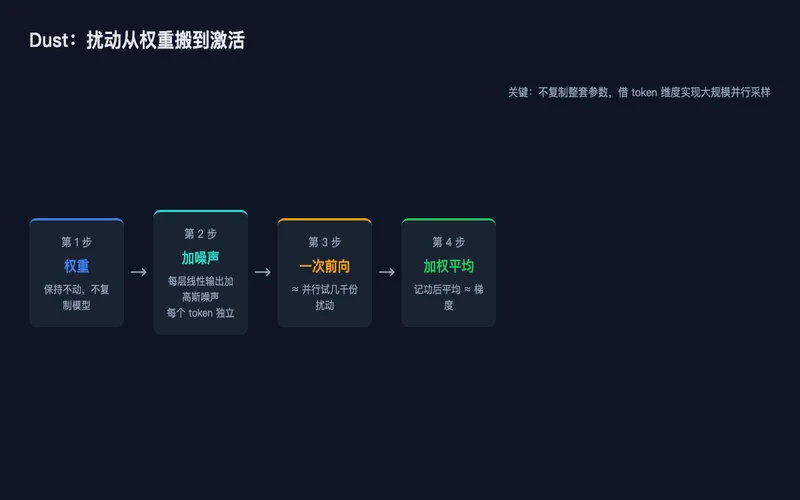
图2:扰动从权重搬到激活,借 token 维度实现大规模并行
一个反直觉的结果
零阶方法一向被认为"越大越不灵"。Dust 却报出相反的趋势:模型越大,种群效率反而越高——243M 参数的模型在大多数设置下,比它 120 倍小的小模型更好用。如果这能复现,等于把"过参数化"从负担重新解释成"更大的搜索空间、更好的几何结构"。
冷静的一面
但瓶颈也明摆着:贵。作者自己说 Dust 目前比反向传播贵几个数量级,实验最大只到 243M 参数、20M token,和工业界动辄千亿 token 的预训练不在同一个量级。第三方 SOTAAZ Lab 的复现还补了一刀:给反向传播换上合适的优化器、或在同样数据上多训几轮,反向传播就明显领先,而且便宜得多。
它真正提出的问题
Dust 的意义很可能不在"取代"二字。它把那个被 40 年默认答案盖住的问题重新摆上台面:当算力足够便宜,我们还需要处处可微吗? 对不可微模块(离散决策、黑箱仿真、硬件约束)来说,零阶是一条不用重写整个栈就能接入的旁路。它现在是昂贵的玩具,但玩具里藏着一条可能的新路线。
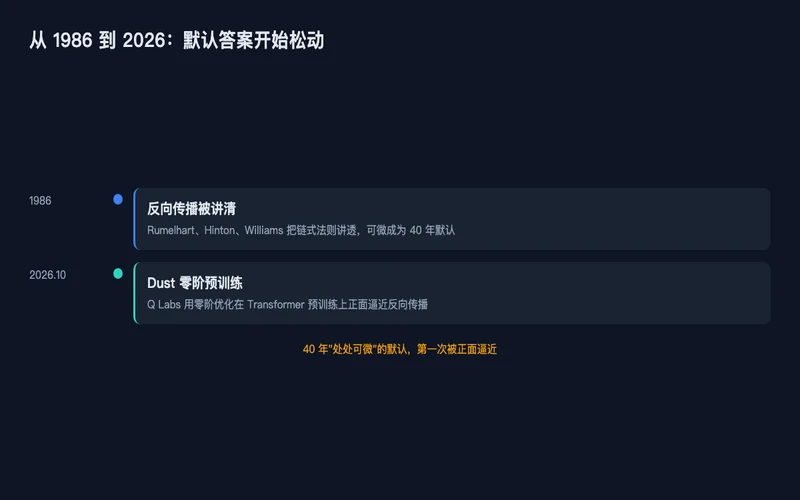
图3:从 1986 反向传播成为默认,到 2026 零阶优化第一次正面逼近
顺带一提:这和我们昨天聊的世界模型是同一条河
如果把"训练一个网络"换成"训练一个会预测后果的世界模型",你会发现同样的问题也在那里出现——世界模型要处理的是真实物理,而物理里到处是不可微的。昨天那篇世界模型讲的是"让 AI 先想后果",今天这篇讲的是"让 AI 换一种方式学习"。两者背后是同一个焦虑:当系统要走进真实、不可微的世界,纯梯度这条路够不够。