卷积神经网络:让计算机学会「看」的第一性原理
卷积神经网络(CNN)是图像识别的引擎。它不用逐像素硬记,而是用「局部感受 + 权重共享 + 层层抽象」三步,把一张照片变成"这是猫"的判断。本文讲清它到底在看什么。
你手机相册能自动把照片分成人、猫、文档,背后站着同一个角色:卷积神经网络(CNN)。它诞生于 1980 年代,2012 年靠 ImageNet 一战成名,至今仍是计算机视觉的底座。它到底凭什么"看懂"一张图?
第一步:用一个小窗口去"扫"整张图
传统做法把图片摊平成一长串像素喂给网络,结果图片稍微平移一点就认不出。CNN 换了个思路:用一个很小的卷积核(比如 3×3 的小方块)在图上滑动,每次只看局部。这个动作叫卷积——本质是拿核里的数字和图像局部做乘法再相加,得到一张"特征图"。同一个核扫完整张图,意味着它练出的识别能力可以出现在任何位置,这叫平移不变性。
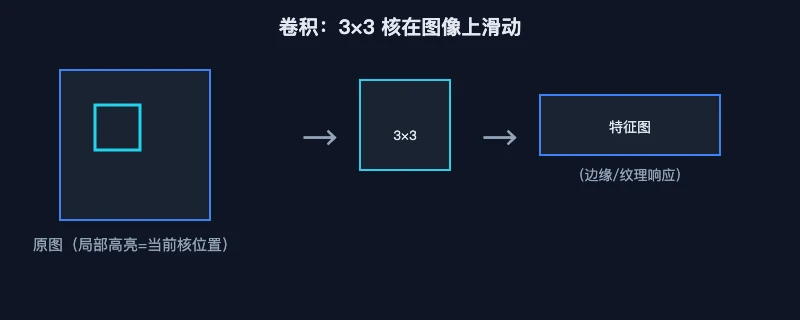
图1:卷积核像一把小刷子,扫过全图提取局部特征
第二步:共享权重,少记一大半
如果全图每个位置都配一套独立参数,模型会大得学不动。CNN 让同一个核在整个图上共用参数,这叫权重共享。它带来的好处很实在:参数量暴跌,模型不容易过拟合,也更能抓住"形状"而不是死记具体像素。配合池化(把相邻小区域压成一个值,只留最强响应),网络对微小位移、缩放不再敏感。
第三步:从边缘到语义,一层层"长高"
单层卷积只能抓简单模式。CNN 把多层叠起来:浅层学到的是边缘、角点、颜色块;中层把边缘拼成纹理、部件;深层把部件组合成"眼睛""轮子"这样的语义概念。最终这些高级特征被送进全连接层做分类判断。你以为是机器在"看",其实是它在逐层抽象——越低层越像滤镜,越高层越像概念。
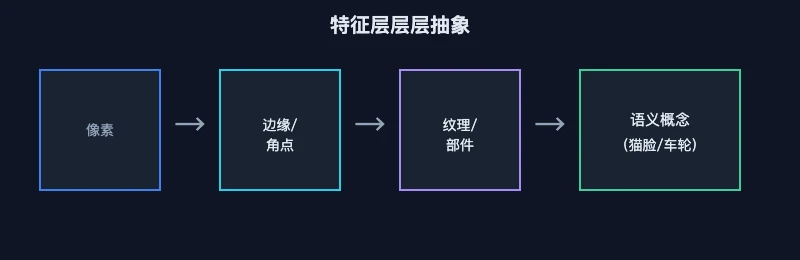
图2:越往深层,特征越接近"这是什么"而不是"哪里有像素"
为什么今天还在讲它
2026 年大模型大行其道,CNN 却没退场。它在医学影像、工业质检、卫星图分析这些"看图"任务上仍是最稳的选择之一,而且参数量远小于通用大模型、能在手机端跑。