新句子的概率不该是零:统计语言模型里的平滑
1969 年乔姆斯基说「句子的概率」这个概念毫无用处,理由很硬:没出现过的句子概率只能是零,可人天天在说新句子。这个反驳在数学上站不住,缺的那一步叫平滑。把计数表改成概率表、给未见组合留一点余量,是后来所有语言模型的第一块地基,也是理解困惑度、泛化和「模型到底学到了什么」的起点。
本节你将能
说清「为什么没见过的句子不该是零概率」,写出加一平滑的公式和几行代码,看懂困惑度在衡量什么、又不能衡量什么。读完之后,再遇到「大模型只是背语料」这类说法,你能指出它错在哪一层。
1969 年的那个反驳
乔姆斯基在 1969 年写下过一句很决断的话:the notion of "probability of a sentence" is an entirely useless one, under any known interpretation of this term。他的理由不复杂。一个概率模型只能从见过的语料里数东西,可人类每时每刻都在说前人没说过的句子;按计数,这些句子的概率就是零。零概率的句子不断出现,说明整套框架从根上不对。
这个推理有个漏洞:它默认概率必须等于「出现次数除以总次数」。PCFG 之外,早在 1969 年 Horning 就已经证明概率推断不必受 Gold 1967 那条形式语言可学习性定理的限制;而在工程上,人们处理未见组合的办法更朴素:给每个没数到的组合留一小份概率。这叫平滑(smoothing),Norvig 在 2011 年那篇文章里直接拿它回敬了乔姆斯基。
直觉模型:一张计数表,和一点点余量
假设语料里只有一句话「我 想 吃 面」,用二元语法(bigram)数相邻词对:「我→想」1 次,「想→吃」1 次,「吃→面」1 次。现在问「我→吃」的概率。按最大似然估计,答案是 0。可这句话在真实语料里完全可能出现,只是这次没抽到。
拉普拉斯加一平滑的做法是把每个词对都先记 1 次,再除以分母(前一词出现次数加词表大小 ):
分子加的 1 是「先假定它见过一次」,分母加的 是为了让所有可能后继的概率加起来仍然等于 1。这一步没有任何玄学,只是把「没见过」和「不可能」分开。
from collections import Counter, defaultdict

corpus = ["我", "想", "吃", "面"]
vocab = set(corpus)
V = len(vocab)

bigrams = Counter(zip(corpus, corpus[1:]))
unigrams = Counter(corpus)

def prob_bigram(prev, nxt, alpha=1.0):
    return (bigrams[(prev, nxt)] + alpha) / (unigrams[prev] + alpha * V)

print(prob_bigram("我", "想"))   # 见过:2 / (1 + 4) = 0.4
print(prob_bigram("我", "吃"))   # 没见过:1 / (1 + 4) = 0.2
print(sum(prob_bigram("我", w) for w in vocab))  # 1.0,概率仍然归一
加一平滑很糙,实际系统里更常用回退(backoff)、插值或 Kneser–Ney。但它们解决的是同一件事:把概率质量从见过的组合匀一点给没见过的组合。
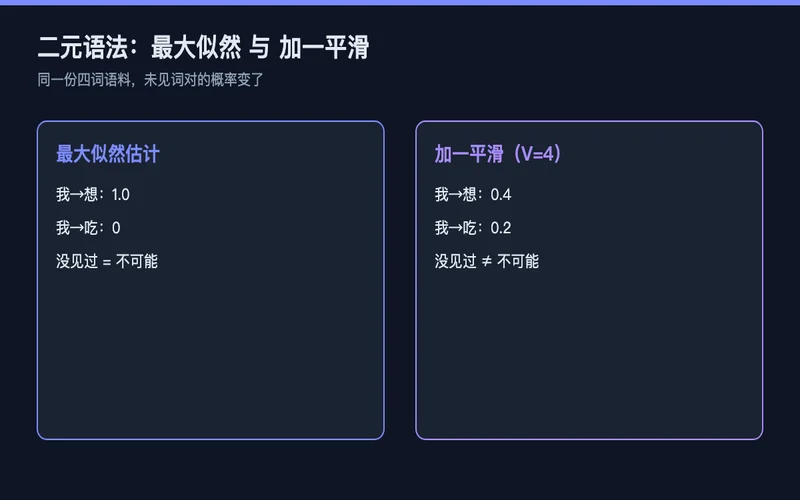
图1:二元语法计数表与加一平滑后的概率变化
核心要点
- 概率不等于频率。最大似然只是估计方法的一种,它对零样本的处理方式是设计选择,不是数学必然。
- 平滑的代价是偏见:你把一部分概率分给了从没出现的东西。词表越大,这份「余量」摊得越薄,所以大词表的模型普遍不用加一,而用回退或分层折扣。
- 评估语言模型常用困惑度(perplexity),它是每个词平均概率倒数的几何平均:。困惑度低说明模型对测试语料不意外,不说明它「懂」语言。
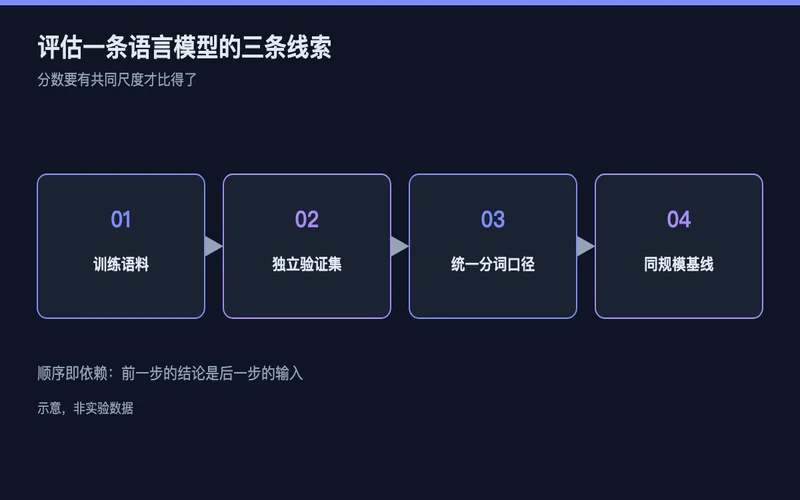
图2:从 n-gram 到现代语言模型的三条评估线索
它的边界在哪
平滑能救「零概率」,救不了「长距离依赖」。乔姆斯基举过一个例子:I never, ever, ever … fiddle 与 She never, ever, ever … fiddles,中间插多少个 ever,动词形式还得跟主语一致。固定窗口的 n-gram 记不住这件事。Norvig 的回应不是替 n-gram 辩护,而是说乔姆斯基拿一个 1950 年代的马尔可夫模型否决了全部概率模型。后来操作树结构、词类、语义和篇章的概率模型,早就不在这个框里了。
我自己觉得这场争论最有意思的地方不在谁赢。Norvig 一边列出 2011 年搜索引擎、语音识别、机器翻译里统计方法几乎 100% 的占比,一边承认工程成功只是「有东西在正常工作」的证据,不是科学证明。这句话放到 2026 年照样成立:模型跑通了,和我们知道它为什么跑通,仍然是两件事。
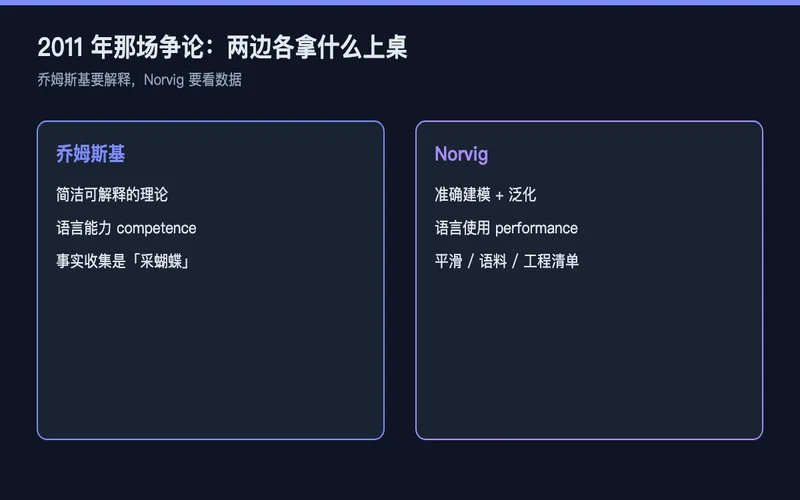
图3:2011 年那场争论里双方各自拿出的证据
核心信息来源
Peter Norvig, Chomsky and the Two Cultures of Statistical Learning(norvig.com/chomsky.html,文中内证指向 2011 年 MIT 150 周年 Brains, Minds and Machines 研讨会):提供乔姆斯基 1969/1957 原话、Gold 1967 与 Horning 1969 的可学习性讨论、smoothing 回应、Pereira 2001 与作者自算的 colorless green 概率比、2011 年各语言技术统计方法占比。文中 Laplacian smoothing 代码示例与困惑度公式:本文自算/自写,用于教学演示,不是论文原始数据。公式与代码中的数字(词表大小 4、概率 0.4 与 0.2)均为本文构造的小语料示例。