基因组坐标里的 0 和 1:一个数字错位,整段结论就变了
同一段 DNA,在 BED 里写作 100 到 200,在 VCF 里对应的是第 101 个碱基,在 GFF 里又是 101 到 200。三个文件、三套记账方式,混用一次就整体偏移一位。这篇把 0-based 半开区间与 1-based 闭区间这两套约定讲清楚,再把染色体命名和参考版本这两个更容易被忽略的坑一起堵上。
本节你将能
读完能一眼分清手上的文件用的是 0-based 还是 1-based,能自己把 BED 区间换算成 VCF 的 POS,也能判断两份注释文件能不能直接相减——后一件事做错,得到的往往不是偏移一位,而是几百个假阳性。
直觉模型:一段序列,两种数法
把基因组想成一排格子,第一个格子是 A,第二个是 C。问题只有一句话:第一个格子你叫它 0 号还是 1 号。
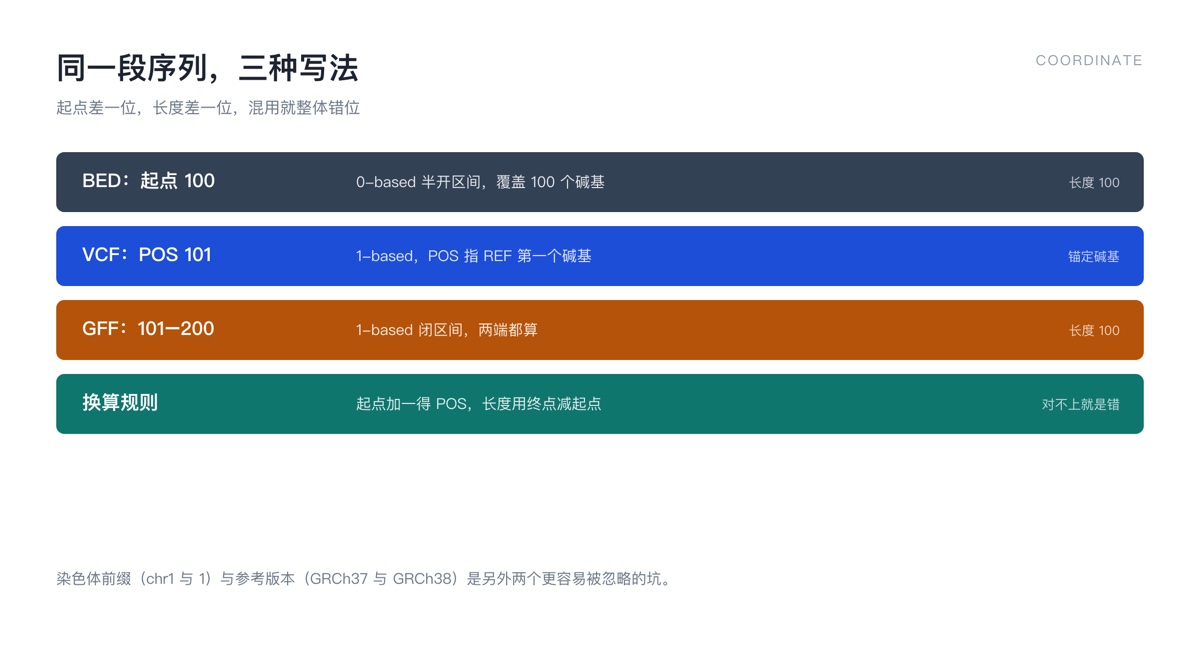
同一段序列的三种写法:BED 起点 100、VCF 的 POS 101、GFF 的 101–200。
叫 0 号的那一派,用「起点加长度」的方式描述区间:写作 100 到 200,意思是「从第 100 号格子开始,数到第 200 号格子之前停下」,实际覆盖 100 个格子,也就是 0-based 半开区间。叫 1 号的那一派,直接说「从第 101 个到第 200 个」,两端都算在内,也是 100 个格子,也就是 1-based 闭区间。
同一个区间,两种写法。前者方便算长度(终点减起点),后者方便和人对数(第几个就是第几个)。麻烦在于,这两套约定被不同工具分别继承下来,而且都活得好好的。
核心要点
- BED 是 0-based 半开。浏览器基因组数据的通用格式,起点从 0 数,终点不包含。chr1 的 100 到 200 覆盖 100 个碱基,对应 1-based 的 101 到 200。
- VCF 是 1-based,且 POS 指向 REF 的第一个碱基。POS 写 101,表示第 101 个碱基;REF 有多长,这段变异就覆盖多长。插入的写法是把锚定碱基一起写进去,所以一个「在第 101 个碱基后插入三个碱基」的事件,POS 仍然是 101。
- GFF 与 GTF 是 1-based 闭区间。起点终点都算,长度等于终点减起点加一。这类注释文件常出现在基因模型里,和 BED 混着用最容易错。
- SAM 与 BAM 的 POS 也是 1-based。但比对区间由 CIGAR 决定,不能只看 POS。POS 为 0 在 BAM 里是「未比对」的哨兵值,不是「第一个碱基」。
- 染色体命名有两套。一套带 chr 前缀(chr1、chrX、chrM),一套不带(1、X、MT)。看起来只是写法差异,实际会让工具把两条记录当成两条不同的染色体,注释直接对不上。
- 参考版本比坐标更致命。同一段序列在 GRCh37 和 GRCh38 里的坐标不同,有些区域整段重排。跨版本比较必须做坐标转换,转换失败的区间会被标成 unmapped,这部分不能默默丢掉。
案例锚点
拿一段真实的转换来走一遍。BED 里有一行:chr1 100 200。换成 VCF 描述同一段区间被删除,正确写法是 POS 等于 101,REF 写第 101 个碱基开始的 100 个碱基,ALT 写第 101 个碱基本身。
如果偷懒把 100 直接填进 POS,这条记录就落在第 100 个碱基上,整体左移一位。对单个碱基变异,这种错误只表现为位置偏一格,很多时候被下游悄悄吞掉;对插入缺失,错一位会让归一化算法把两条本该相同的事件判成不同事件,合并时漏掉重复,统计出来的变异数目虚高。
更隐蔽的一类错误发生在坐标转换之后。把 hg19 的区间直接搬到 hg38 上取序列,偏移可能从几个碱基到几十个碱基不等,取出来的参考碱基是错的,变异校验就会大面积失败——这时候人容易怀疑数据本身,而问题只是版本没换。
互动
三个问题,读完可以自测:第一,一份 BED 文件里 chr1 的 100 到 200,写成 VCF 的 POS 应该是多少?第二,一个 1-based 的区间起点 1000、终点 1500,长度是 500 还是 501?第三,注释文件里同时出现 chr1 和 1,你能确定它们是同一条染色体吗?
常见误区
- 以为「坐标」是唯一的。坐标只有在「参考版本加命名体系加数法」三件事都确定时才唯一。少说一件,这个数就没有意义。
- 以为转换只是加减一。0-based 与 1-based 之间确实只差一,但插入缺失的锚定碱基、区间的开闭、参考版本的重排,都不是加减一能解决的。
- 以为工具会帮你兜住。多数工具默认相信输入,格式错了不会报错,只会给出一个看起来合理的错误结果。
本节小结
记一句话:BED 从 0 数、终点不算;VCF 从 1 数、POS 是 REF 的第一个碱基;GFF 从 1 数、两端都算。染色体前缀和参考版本,在动手之前先确认,比事后排查便宜得多。
[关联推荐]
- 2 亿参数的模型,打败了用 2000 张卡训几个月的对手 — 基因组语言模型怎么把序列当语言读
- RNA 基础模型:把一段序列读成结构 — 从序列到结构的另一条路
- AI 翻遍 2.14 亿个蛋白 — 大规模数据集的坐标与索引问题