Km 小不代表结合紧:酶动力学里最容易被读反的三个数
Km 常被当成「亲和力」的同义词,其实它只有在特定条件下才接近解离常数;kcat 描述的是每分子酶每秒转几次,但拿它比酶之前必须先归一化酶量;真正衡量效率的是 kcat 与 Km 的比值,它决定低底物浓度下谁更快。这篇用一对数值反差极大的酶,把这三个数的读法摆正。
本节你将能
读完能说清 Km 到底是不是亲和力,能判断「Vmax 更大所以酶更强」这句话哪一步错了,也能用 kcat 除以 Km 把两个酶放进同一个尺度里比——并且知道这个比值在什么条件下会失灵。
直觉模型:一条曲线上的三个位置
把底物浓度横着放,反应速率竖着放,画出来的是一条先陡后平的曲线。曲线有三个有意义的点:最右边那条水平线的高度是 Vmax;曲线升到 Vmax 一半时对应的底物浓度是 Km;而 Vmax 除以酶的总浓度,得到 kcat。
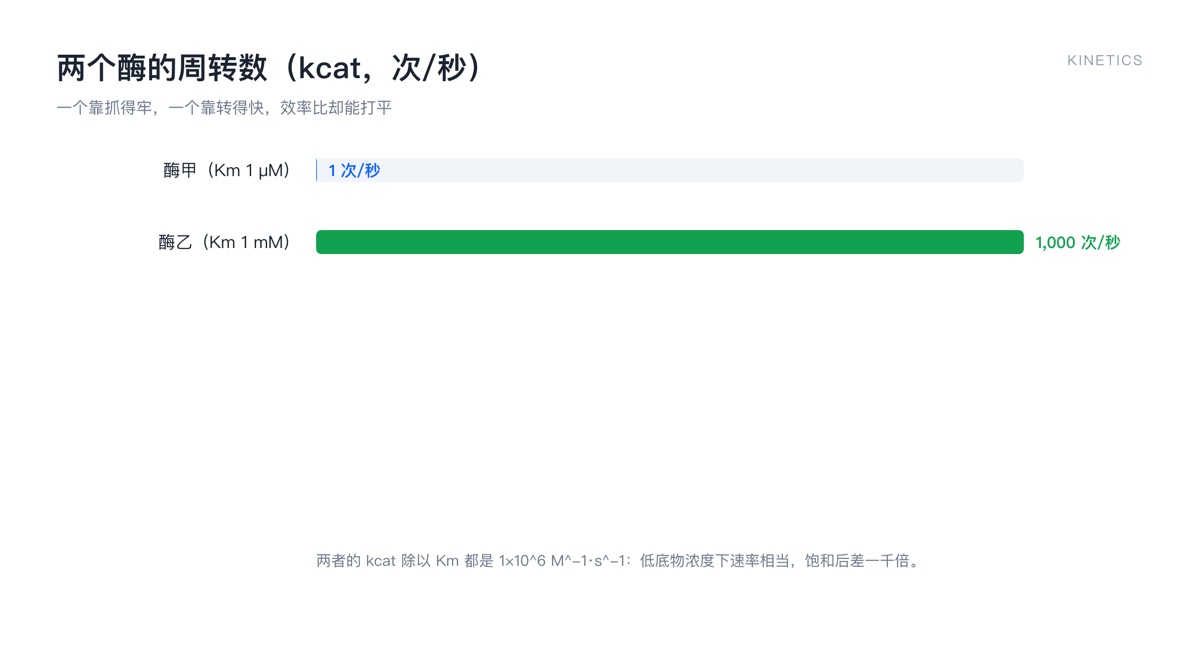
两个酶的周转数对比:kcat 相差 1000 倍,效率比却相同。
所以 Km 回答的是「要多浓的底物,才能把这个酶用到半速」,kcat 回答的是「酶被喂饱时,每分子每秒转几次」,Vmax 只是这两个数与酶量的乘积。三个数各管一段,混在一起比,就会得出相反的结论。
核心要点
- Km 不是解离常数。严格推导里 Km 等于「解离常数加转化项」,只有当底物解离远快于转化、也就是转化步骤很慢时,Km 才近似等于亲和力。酶越快,这个近似越不成立。
- Km 的单位是浓度,数值含义是半速点。写成 1 微摩尔或 1 毫摩尔,表达的是「底物要那么浓才到半速」,而不是「结合得多紧」。低 Km 说明它容易被喂饱,仅此而已。
- kcat 的单位是每秒,要点是归一化。Vmax 藏在酶量里,同一份速率数字,酶浓度差十倍结论就翻。比酶之前先算 kcat,或者至少让酶量一致。
- 比效率看 kcat 除以 Km。这个比值单位是每摩尔每秒,物理意义是「低底物浓度下,酶遇到底物的有效率」,上限受扩散限制,大约在 10 的 8 到 9 次方量级。
- 离开底物浓度谈优劣没有意义。同一个 kcat 除以 Km 的两个酶,在极低底物浓度下几乎一样快,在饱和浓度下可能差上千倍——因为一个靠「抓得牢」,一个靠「转得快」。
- 拟合法别用双倒数图。双倒数会把低浓度点的误差放大,算出好看的直线和错误参数。现在默认用非线性拟合直接配米氏方程。
案例锚点
看一对刻意设计的酶。酶甲:Km 1 微摩尔,kcat 每秒 1 次。酶乙:Km 1 毫摩尔,kcat 每秒 1000 次。算一下比值,甲是 1 除以 10 的负 6 次方,乙是 1000 除以 10 的负 3 次方,结果都是每摩尔每秒 10 的 6 次方——效率完全打平。
但两条曲线的形状完全不同。底物只有 0.1 微摩尔时,甲已经跑到半速的百分之九,乙还不到万分之一个 Vmax;由于乙的 Vmax 是甲的一千倍,两者的绝对速率此时几乎相等。底物升到毫摩尔级,乙完全饱和、甲早就贴着上限,乙的速率是甲的一千倍。
所以「哪个酶更好」取决于你处在什么底物浓度。细胞内多数代谢物的浓度远低于 Km,这种场景里 kcat 除以 Km 才是主角;工业反应器里底物堆得很高,kcat 和 Vmax 才是主角。同一组数字,换个场景结论就反过来。
互动
三个问题:一个酶报告 Km 是 10 微摩尔,你能说它亲和力强吗?两个实验室给出的 Vmax 差五倍,能不能直接判断谁的酶更强?如果两个酶的 kcat 除以 Km 相同,在底物只有 Km 的百分之一时,谁的速率更高?
常见误区
- 把 Km 当亲和力的读数。这是最常见的一处。亲和力是解离常数,Km 是动力学参数,只有在特定极限下两者数值接近。
- 拿 Vmax 比酶,却不看酶量。Vmax 随酶浓度线性变化,同一个酶稀释一半,Vmax 就掉一半。比较之前先归一化。
- 用「Km 越小越好」评价工业酶。低 Km 意味着容易饱和,但这类酶往往 kcat 不高;高底物浓度的工艺里,这条经验会选错酶。
- 忽略测定条件。pH、温度、缓冲液、离子强度都会改变 Km 与 kcat,跨文献比较时这些条件往往不一致。
本节小结
记三句话:Km 是半速点,单位是浓度,不是亲和力;kcat 是每分子每秒的周转数,比之前先归一化;要比效率就用 kcat 除以 Km,并且记住这个比值只在低底物浓度下说话。
[关联推荐]
- 让 AI 用大白话写蛋白 — 设计酶之前,先得把序列和功能对上
- AI 翻遍 2.14 亿个蛋白 — 从结构库反推功能的路子
- 长得慢的细菌,为什么更难被杀 — 代谢速率与药效的另一种关联