重试是最危险的动作:为什么每个写接口都需要一把幂等钥匙
网络超时的时候,客户端只知道「没收到回应」,不知道「对方到底执行了没有」。这时候重试一次,就可能变成执行两次。解法不是不重试,而是让重复执行无害:给请求配一把幂等钥匙,服务端按键去重,配合指数退避与副作用拆分。这篇把至少一次、至多一次、恰好一次这三种语义讲清楚,并给出可落地的键设计。
本节你将能
读完能判断一个接口能不能安全重试,能设计出一把可用的幂等键,能说清为什么「恰好一次」在工程上通常是「至少一次加去重」实现的,也能在扣款、发货、发通知这类有副作用的场景里,把该拆开的步骤拆开。
直觉模型:客户端永远在猜
一次请求走网络,可能出现三种结局:对方收到并成功、对方收到但失败、对方根本没收到。客户端能观测到的只有「收到回应」与「超时」两种。超时把后两种混在一起,于是客户端必须做一个决定:重试,或者放弃。
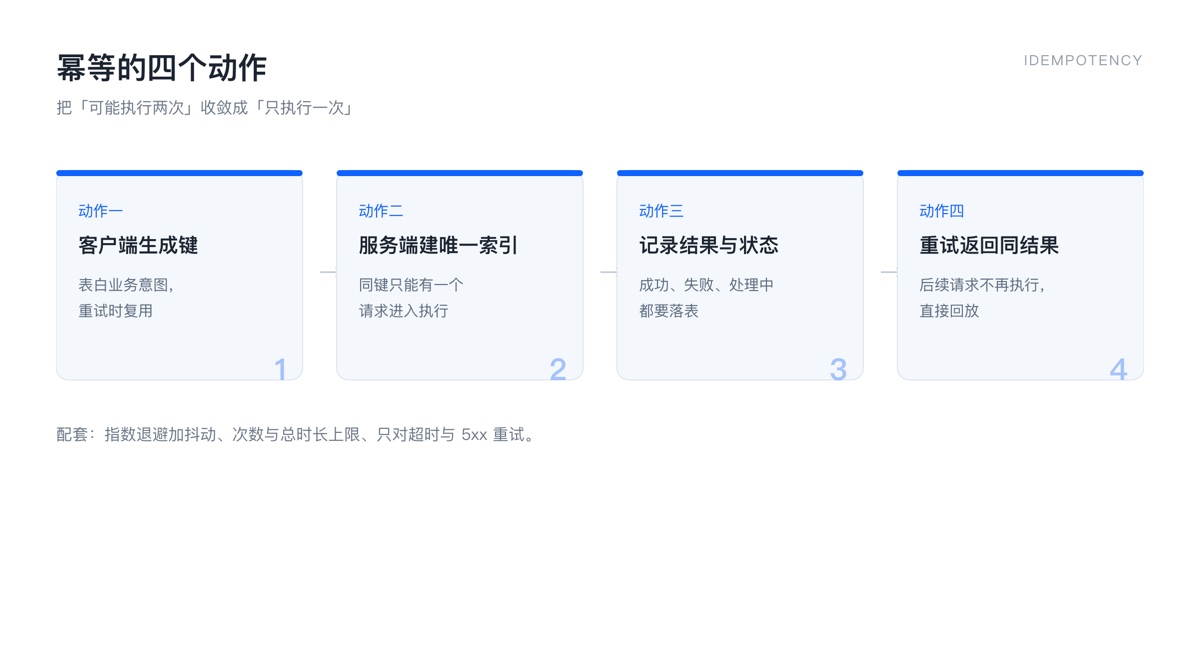
幂等的四个动作:客户端生成键、服务端唯一索引、记录状态、重试返回同结果。
重试的风险不在于「再发一次」,而在于「上一次可能已经生效」。如果接口的动作是「扣 100 元」,第二次执行就是扣 200 元;如果动作是「把状态设为已发货」,第二次执行没有额外影响——这就是幂等与不幂等的分界。
核心要点
- 三种投递语义要分清。至多一次:可能丢,但不会重复;至少一次:不会丢,但可能重复;恰好一次:既要可靠又不重复,实现成本最高。
- 工程上的通行做法是「至少一次加幂等」。让重试自由发生,用去重把重复挡在业务之前,最终效果接近恰好一次。这比在设计阶段追求完美的恰好一次要现实得多。
- 幂等键由客户端生成。每次业务意图分配一个唯一键(通常是 UUID),重试时复用同一个键;服务端以键为唯一索引,第一次执行后把结果与状态记下来,后续同键请求直接返回同一结果。
- 幂等表要防并发。两个同键请求同时到达时,唯一索引或行锁只能让一个进入执行,另一个要么等待、要么返回「处理中」。没有这一步,去重只在串行场景有效。
- 重试要退避、要抖动、要有上限。指数退避避免把下游压垮,抖动避免大量客户端同时重试形成尖峰,次数与总时长上限避免请求永远挂着。
- 只对可重试的错误重试。超时、连接失败、限流与 5xx 可以重试;参数错误、权限错误这类 4xx 重试多少次结果都一样,只会放大负载。
- 副作用要拆开。扣款成功但通知失败时,不该回滚扣款再重试整笔;把通知放进待发表,用补偿任务重发,把「钱」和「消息」分开对待。
案例锚点
一个常见场景:用户点了一次「提交订单」,前端因为网络抖动重发了一次请求。服务端两次都收到,于是创建了两笔订单、扣了两次款。事后排查时,日志里两条请求长得几乎一样,唯一区别是时间戳差 800 毫秒。
修法分三步。第一步,前端在进入提交页时生成一个订单意图键,把键随请求一起发;重发时复用同一个键。第二步,服务端用这个键做唯一索引,第一次请求写入后开始执行,第二次请求要么撞索引被拒、要么查到已有记录直接返回第一次的结果。第三步,把「扣款」与「发通知」拆开:扣款在事务内完成,通知写进待发表,由后台任务发送,发送失败只重发消息,不回滚资金。
改完之后的行为是这样的:网络再抖三次,用户也只会看到一条订单、一次扣款,第二、三次请求拿到同一份结果。重试从「危险动作」变成了「免费动作」。
互动
三个问题:你现在负责的写接口,如果同一个请求被发两次,会发生什么?幂等键是用请求体哈希算出来的吗(如果是,它多半不能用,因为里面通常带时间戳)?下游超时后,你的客户端会立刻重试、还是退避之后再试?
常见误区
- 以为「加了重试就变可靠」。重试提高的是送达率,不是正确性。没有幂等,重试只是把偶发的重复变成常态的重复。
- 用请求体哈希当幂等键。请求体里常带时间戳、随机数或自增序号,哈希每次都不同,去重形同虚设。键要代表「业务意图」,不是「这一次调用」。
- 把至少一次当成恰好一次。消息队列承诺的通常是最少送达一次,重复是正常现象,消费端必须自己去重。
- 无上限重试。下游故障时,所有客户端同时重试会形成放大效应,把小故障变成雪崩。退避加抖动是必需项,不是优化项。
- 忘记幂等记录的生命周期。幂等表需要保留窗口与清理策略:太短会漏掉迟到的重试,太长会拖累写入。窗口应大于「最长可能的业务重试周期」。
本节小结
记住三句话:网络超时意味着「不知道有没有执行」,所以重试必须有幂等兜底;幂等键代表业务意图,由客户端生成,服务端用唯一索引加状态记录去重;重试要退避加抖动、有上限、只对可重试错误,副作用要拆开而不是整笔回滚。
[关联推荐]
- MCP 的信任模型 — 工具调用同样要回答「重复执行会怎样」
- 工具调用为什么会退化 — 调用链路变长之后,失败与重试的处理
- 一次右键点选就能执行脚本 — 副作用与权限边界的极端案例