17 年月球数据,训成了一个开源模型
NASA 与 IBM Research 发布月球科学基础模型并开源,训练数据约 200 万张图像切片,微调后用于撞击坑绘图、年轻火山地貌识别和极区水冰稳定性估算。
NASA 和 IBM Research 在 2026 年 9 月发布了一个月球科学基础模型,并且开源。它是首批专门为月球科学构建的开放模型之一,训练数据来自 17 年积累的大约 200 万张图像切片。
这类"基础模型"的做法是:先在大量无标注数据上做预训练,得到一个对领域数据有通用理解能力的模型,然后用少量标注数据微调到具体任务。对月球科学来说,这个思路解决了一个实际困难:标注需要专家,而专家时间有限。
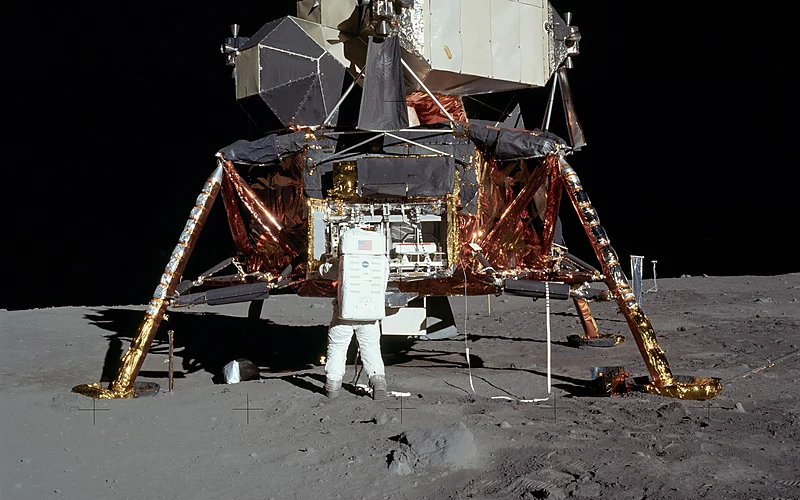
图1:阿波罗 11 号登月舱(NASA,公有领域)(图片来源:Wikimedia Commons)
它能做什么
研究者用少量标注数据微调后,模型完成了三类任务:
- 绘制撞击坑:自动识别和圈定月表撞击坑,这是估算表面年龄的基础工作
- 识别年轻火山地貌:找出相对年轻的火山特征,帮助重建月球热历史
- 估算极区水冰稳定性:判断哪些位置的极区冰能够长期稳定存在
第三项对未来着陆任务有直接价值。极区永久阴影区的水冰是载人任务的重要资源,知道哪里稳定意味着知道该往哪落。
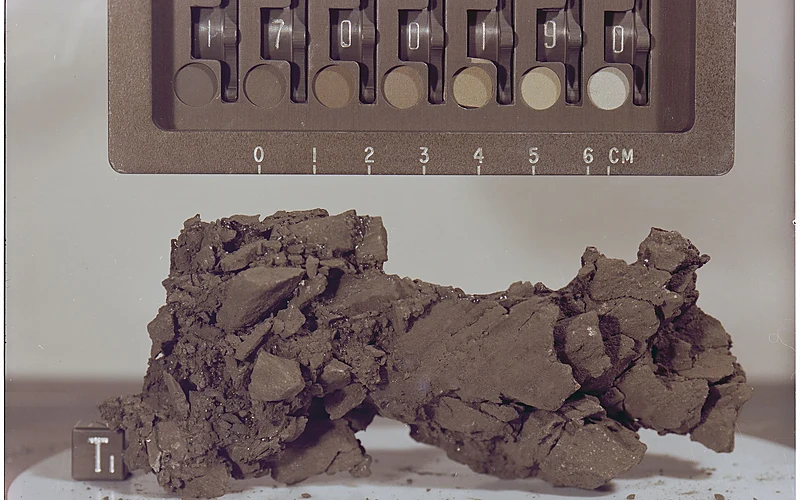
图2:月球样品 70019(NASA,公有领域)(图片来源:Wikimedia Commons)
为什么用开放模型
开放发布的实际意义在于可复现。行星科学的数据主要由公共资金采集,如果分析工具封闭,其它研究者无法验证结果,也无法在此基础上改进。开源让不同团队能在同一个起点上比较方法。
同一时期开源 AI 领域的另一组数据也值得一提:开放权重模型在 token 用量中的占比从 2025 年 12 月的 7% 上升到 2026 年 8 月的 56%。企业和开发者在生产环境中采用开放模型的速度超出很多人预期,成本和数据控制是两个主要驱动力。
科学基础模型这条路走得通吗
这是需要观察的部分。地球观测、材料、天文等领域都在尝试训练各自的专用模型,但效果参差。关键在于预训练数据是否足够"像"目标任务的数据,以及标注能否覆盖任务的多样性。
月球这个案例相对有利:数据来源统一(主要是轨道器影像),任务定义清晰(坑、火山、冰),历史上已有大量人工标注可作对照。条件不那么整齐的领域,复制这个模式的难度会高很多。
关联推荐
- 小米把训练过程一起开源了:75 万条轨迹,7000 个环境 — 开源模型生态的另一面
- 一颗不到百万岁的行星,把行星形成模型问住了 — 行星科学的前沿问题
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…