给细胞做一门通用语言:1.12 亿个细胞训出的基础模型
单细胞数据已积累到数亿个细胞,跨实验室、跨物种的统一理解超出人力。斯坦福与 CZI 团队背靠背发表 UCE 与 TranscriptFormer,一个建立统一坐标,一个学习基因协同的通用规律。
每个细胞携带同一套基因组,却只打开其中一部分。胰腺 β 细胞开启胰岛素相关基因,B 细胞开启抗体基因,正是「打开哪些基因」决定了细胞的身份和状态。过去十几年,单细胞测序积累了数亿个细胞的表达数据,但把这些来自不同实验室、不同组织、不同物种的数据放到一起理解,已经超出了人力所及。
两个模型,两件事
2026 年 9 月,斯坦福大学 Stephen Quake 与 Jure Leskovec 团队联合CZI在《自然》和《科学》上背靠背发表两项成果,分工很清晰。
第一个是通用细胞嵌入(UCE)。它做的事情是建立坐标系:把各种来源的细胞映射进同一个数学空间,在这个空间里「相似」和「不同」可以直接度量。原本拼不到一起的图谱因此有了统一的底图。
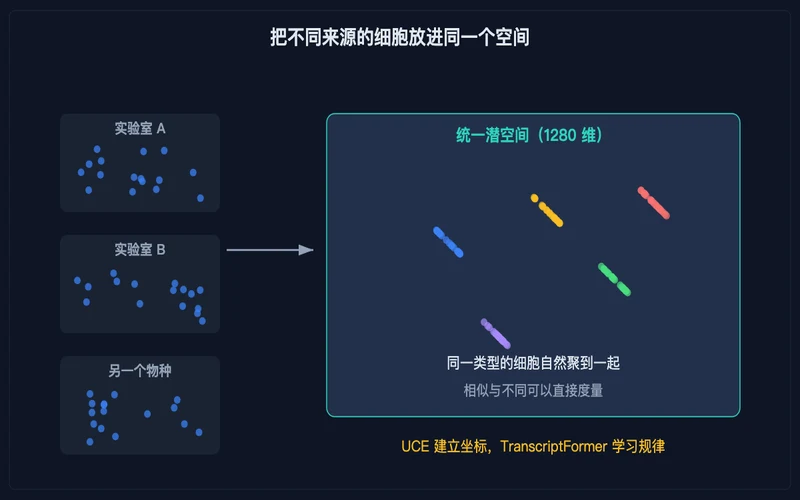
图示:来自不同实验室与物种的细胞被映射进同一个潜空间,同类型自然聚拢
第二个是 TranscriptFormer,一个生成式细胞图谱模型。它的训练方式类似语言模型,只不过预测的不是缺失的词,而是缺失的基因表达值。训练集覆盖 12 个物种、1.12 亿个细胞,跨越约 15.3 亿年的进化距离,从单细胞酵母一直延伸到人类,最大跨物种进化距离 6.85 亿年。所有细胞被映射到一个 1280 维的潜空间。
跨物种这件事成立吗
物种之间差异巨大,凭什么放进同一个空间?模型给出的答案是:不同物种的细胞遵循相似的基因协同规则。哪些基因倾向于一起开启、哪些倾向于互相抑制,这套规律在进化中被保留下来,模型学到的正是这一层,而不是某个物种的表面特征。
因此它展现出几项能力:对训练中没见过的物种完成细胞类型鉴定;零样本区分人类的健康细胞与病变细胞;还能生成当前自然界并不存在的功能细胞状态,为细胞治疗和再生医学的设计提供搜索空间。
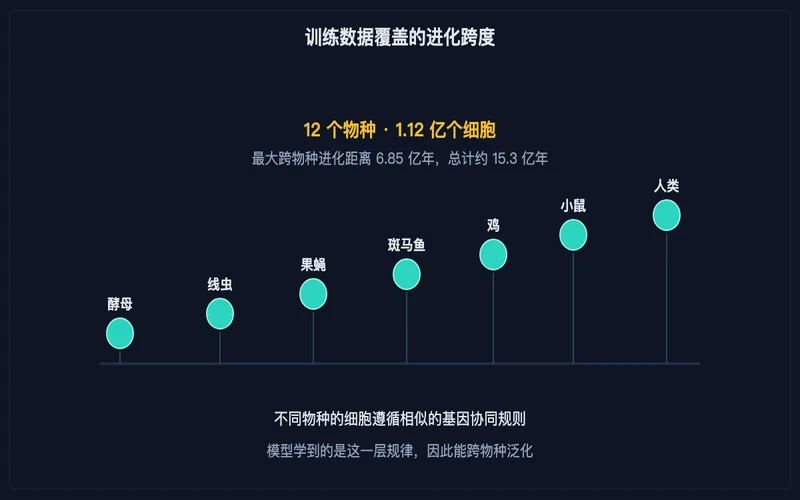
图示:训练数据覆盖的物种跨度,从单细胞酵母延伸到人类
接下来要看什么
两项成果的意义在于把细胞生物学从「每个实验室各自建图谱」推进到「共用一张底图」。研究团队把这一进展描述为一个新领域的开端。
需要保持清醒的是,模型的输出仍然是预测。跨物种推断在进化距离较远时可靠性如何,生成的虚拟细胞状态在真实实验里能否被诱导出来,这些都需要 Wet lab 的验证。工具已经就位,检验才刚开始。
关联推荐
- VirTues:给「虚拟组织」预训练一个基础模型:了解虚拟组织的预训练模型怎么搭
- 基因测序简史:从九千五百万降到五百美元:回顾测序成本从九千五百万降到五百美元
- 1494 个大脑,630 万份表达谱:一张前额叶皮层的终生地图:看大规模脑表达图谱是怎么建起来的
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…