把论文变成会干活的智能体
2026 年 9 月 Nature 上的 Paper2Agent,把论文及其代码库自动封装成 MCP 服务器:工具、资源、操作说明三层,每个工具都要用论文自己的示例数据复现原文结果才算合格。AlphaGenome 智能体 45 分钟构建 22 个工具,100 篇计算生物学论文有 74 篇转化成功,300 道基准题准确率 91.2%,单次查询 0.20 美元、1.6 分钟。这篇拆清它的六步流程、验证机制、实测数字和 26% 论文转不动的边界。
2026 年 9 月 16 日,Nature 上线了一篇标题很不「Nature」的论文:《把研究论文重新构想为可交互、可靠的 AI 智能体》。斯坦福大学 Jiacheng Miao、James Zou 团队做了件听起来简单、实际很难的事——给一篇论文配一位虚拟通讯作者:你不用读代码、不用配环境,直接问它,它就把论文里的方法跑给你看。
一、论文最贵的一段,是「你得自己把它跑起来」
一篇计算方法论文的价值,往往不在结论,而在它能不能用在你自己的数据上。但从「读懂」到「跑通」之间隔着一整条工程链路:找到代码仓库、装依赖、配环境、看懂 API 层级、搞清楚哪个输入该填在哪、输出又是什么格式。
论文拿 AlphaGenome 举例。这个基因组尺度的基础模型能力很强,但使用者要安装环境、用 API 密钥创建客户端对象、构造变异输入对象、选择需要的输出模态,还得理解参数含义。对不熟悉这套程序抽象的生物学研究者来说,光是第一步就足以劝退。更普遍的问题是:成果被技术门槛隔离,代码公开了,却没真正被复用。
最直觉的解法是把通用编程智能体(比如 Claude Code)直接指向仓库,让它现场写、现场跑。论文实测这条路并不可靠:智能体每回答一个问题就重新生成一遍代码,结果会漂移;更麻烦的是,它可能写出能跑但算错的代码——没有报错,数字却是错的。拿到代码,并不等于能可靠地复现研究。
二、核心不是「读论文」,是把论文变成 MCP 服务器
Paper2Agent 的做法是换一种知识表示:不把论文当成给大模型检索的文本,而是把正文、补充材料、数据集、代码、可执行示例和分析流程,整体转成一个标准的 MCP 服务器。MCP(Model Context Protocol)是让大模型和智能体框架直接访问结构化工具与 API 的协议,相当于给论文装了一个统一插座,任何支持 MCP 的客户端都能插上就用。
一台服务器里有三类东西,分工非常清楚:
| 组成 | 装的是什么 | 例子 |
|---|---|---|
| 工具 tools | 封装论文方法贡献的可执行函数,带预先配好的运行环境、带类型和参数注释 | score_variant_effect() 接收遗传变异,预测并可视化它对基因表达、剪接、染色质可及性的影响 |
| 资源 resources | 静态材料:正文、代码库、补充表格、数据集与图片链接,标准化以便检索引用 | AlphaGenome 资源里包含训练数据的链接;回答能指回原文段落或代码位置 |
| 提示 prompts | 从论文和代码库里推断出的多步骤工作流指令,规定工具调用的**先后顺序** | Scanpy 提示把质控 → 归一化 → 特征选择 → 降维 → 建图 → 聚类 → 细胞类型注释编码成固定流程 |
三类里最容易被忽略、也最值钱的是提示。很多关键知识不是用文字表达的,而是用顺序表达的:单细胞分析必须先质控再归一化,顺序错了结果就废。但方法部分往往默认你懂行,不会把「必须按这个顺序」写成一条清单。Paper2Agent 能把这段顺序从论文和代码库里读出来,直接写成指令,不需要人工整理。用户只要给出数据路径,剩下的流程智能体自己走完。
每个工具还保留指向原始代码的引用,执行过程可追溯。服务器可以部署到 Hugging Face Spaces 等远程平台,使用者本地什么都不用装,打开对话框就行。
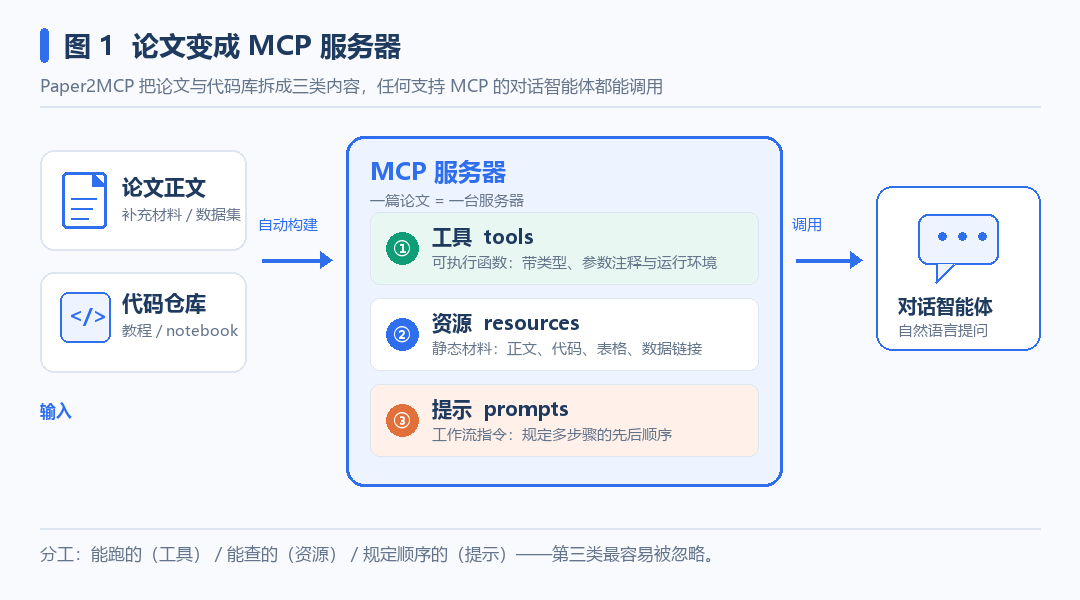
图 1:一篇论文连同代码库,被拆成工具、资源、提示三层,打包成可被对话智能体调用的 MCP 服务器
三、六步流水线:从仓库到能用的智能体
实现上,Paper2Agent 是一组协作的智能体(在论文里基于 Claude Code 实现)。它把转换过程拆成六步,全程几乎不需要人介入:
| 步骤 | 做什么 |
|---|---|
| 1 定位 | 找到并下载论文关联的代码仓库 |
| 2 配环境 | 环境智能体准备一个干净、隔离、记录了依赖版本的软件环境 |
| 3 挖示例 | 提取智能体通读论文与仓库,翻出教程、notebook 和示例,识别核心方法 |
| 4 原样跑通 | 把教程完整跑一遍,记录每一步的输入与输出,作为后面的「标准答案」 |
| 5 拆分+测试 | 把跑通的代码拆成带类型、带注释的可复用函数,逐个写测试、修到通过 |
| 6 打包部署 | 通过验证的工具和环境打包成 MCP Python 文件,部署后接上对话智能体 |
注意第 4 步:它先让原论文的流程在自己手里跑通一次,把真实输出存下来。后面所有「学会没学会」的判断,都有一个来自论文自己的参照物,而不是模型自己说了算。
四、真正让它可信的,是每个工具都要「考一次试」
一个函数算不算学会了,不看它写得多漂亮,只看一件事:能不能用论文自己的示例数据,复现出论文自己的结果。测试会查三项——预期文件有没有生成、数值是否落在容差范围内(约 3%)、图是否与参考图一致(用图像相似度比对)。对不上就修,最多试六次;六次还不行,这个函数直接被剔除,不会进入最终交付的那套工具。
通过验证之后,工具与环境被固定下来。对话智能体此后只能调用它们,不再临场编写分析代码。这正是它比「直接把仓库丢给 Claude Code」稳的原因:把随机的代码生成,提前收敛成一次性的、被测试锁住的工具构建。
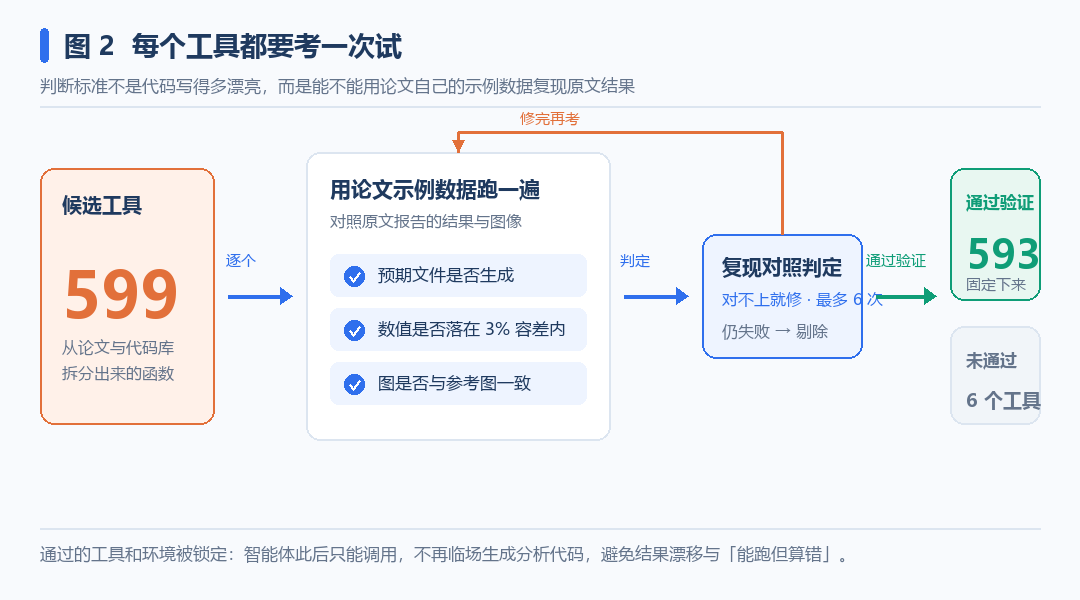
图 2:候选工具逐个拿论文示例数据做复现检验,通过才保留,反复失败的直接剔除
换个角度看,这一步把「可复现性」从论文作者的一句承诺,变成了构建时的一道自动门禁:过不了原文结果对照的工具,连交付的资格都没有。
五、数字说话:更快,也更准
第一个案例是 AlphaGenome。在一台个人笔记本上、无人干预的情况下,Paper2Agent 约用 45 分钟、14 美元生成了 22 个 MCP 工具,全部通过自动验证。这是一次性构建成本,工具之后可反复复用。
| 题目类型(5 次独立运行) | Paper2Agent | Claude + Repo | Biomni |
|---|---|---|---|
| 15 道教程衍生题 | 98.7 ± 1.3% | 82.7 ± 3.4% | 37.3 ± 4.0% |
| 15 道全新查询 | 100% | 78.7 ± 4.4% | 56.0 ± 3.4% |
| 30 道开放式研究题 | 82.7 ± 2.4% | 56.7 ± 2.3% | 72.2 ± 2.2% |
效率上,以运行时间中位数衡量,教程题比 Claude + Repo / Biomni 分别快 1.9 倍和 3.1 倍,新查询快 2.9 倍和 3.8 倍。换成更新的模型、改写提问措辞后,优势依然存在。评估时 Paper2Agent 生成的智能体不能访问论文正文和原始仓库,只能靠自己的 MCP。
规模化评估更能说明问题。作者端到端处理了三组论文,全程不做人工清理、不改代码:
| 指标 | 结果 |
|---|---|
| 100 篇计算生物学论文 | 74 篇成功转化;599 个候选工具中 593 个通过验证 |
| 300 道教程衍生题 | 91.2 ± 1.6%,对照 Claude Code 直读仓库 80.3 ± 2.3%(Sonnet 4)、86.3 ± 1.1%(Sonnet 4.6),P < 0.0001 |
| 单次查询成本 / 耗时 | 0.20 美元 / 1.6 分钟,对照 0.38 美元 / 4.3 分钟 |
| 26 篇数据与发现类论文 | 只有结构化资源层时,100 个综合问题 89.0 ± 3.1%;成本约基线 1/34,速度约 15 倍 |
| 10 篇非生物计算论文 | 42 项执行型任务准确率 98.1 ± 0.8%(涵盖 AI、统计、计量经济、博弈论、天体物理) |
| 打乱论文与问题配对 | 100% 正确拒绝超出范围的查询,没有靠背答案走捷径 |
两个细节值得留意:一是没有可执行工具的论文,光靠结构化资源层也明显赢过带浏览器能力的基线;二是作者专门做了消融实验,说明自动验证和多智能体设计确实对性能有贡献,不是堆模型堆出来的。
六、不止复现:几个智能体一起找基因
因为 MCP 是模块化的,同一个对话智能体可以同时连上多篇论文的服务器。论文里最有意思的一段,是让三个论文智能体协作,为银屑病相关位点 rs887314 优先筛选因果基因:AlphaGenome 提供方法,MPRA 偶联 scCRISPRi 研究和 CD4+ T 细胞 Perturb-seq 研究提供实验数据。
AlphaGenome 先预测,在 CD4+ T 细胞中 GPR137 是该位点受影响最强的基因(RNA-seq 分位数得分 0.997)。为验证这个预测,AI 共同科学家交叉查了另外两篇论文的补充表格和差异表达汇总统计,提出 10 种候选验证策略,由人类研究者选定「表达变化特征的相关性分析」:看顺式调控元件(CRE)扰动带来的下游变化,是否与某个基因敲低带来的变化一致。
对排名最高的 5 个候选基因、在 Rest / Stim8hr / Stim48hr 三种培养条件下比对,只有 GPR137 敲低在刺激条件下与 CRE 扰动特征显著一致:Stim8hr 的 Spearman 相关系数 0.613(P = 3.79 × 10⁻³),Stim48hr 为 0.630(P = 4.71 × 10⁻³),FDR 均小于 0.05;静息条件下只有 0.29(P = 0.21)不显著。于是作者把它的作用解释为依赖细胞激活状态。这种跨筛选、跨模态的整合策略,并不是那两篇来源论文提出来的。
但同一个框架也会给出和原文不一样的判断,这恰好说明了它的定位。分析 LDL 胆固醇相关变异 chr1:109274968:G>T 时,智能体把 SORT1 排在首位(肝组织预测表达影响分位数得分 0.99983,且 sortilin 与 LDL / VLDL 分泌直接相关),而原 AlphaGenome 论文更强调 CELSR2 和 PSRC1。后两者的分位数得分其实同样高达 0.99998,也都有显著 eQTL 关联。原文明确说:这反映了一个变异牵连多个邻近基因时,归因本身的固有困难。
论文智能体可以生成假设、提出验证策略、规模化执行分析,但方向和证据评价仍由研究者负责。计算预测不是生物学因果的证明——它是助手,不是权威。
七、边界:26% 的论文转不动
100 篇计算生物学论文里有 26 篇没成功。失败原因很朴素:缺可执行代码、缺数据或模型文件、环境与依赖装不上、脚本无法泛化。作者的「执行—诊断—修复」迭代能纠正不少原本就存在的运行错误,但补不了根本缺失的材料。
反过来,这倒给出了一个有意思的判据:一篇论文能否被顺利智能体化,本身可能成为可复现性的实操指标。作者预见未来会出现类似「数据与代码可用性声明」的智能体可用性(agent availability)栏目,说明论文是否、以及如何被实现为可交互智能体;相应的智能体材料需要像代码仓库和示例 notebook 一样,随论文一起发布和维护。
还有几笔现实的账:上游代码与依赖一旦演化,论文智能体就得跟着维护;把研究代码暴露成可执行智能体,还会牵出安全、知识产权与贡献归属问题。评估层面也有局限——在开放式科学任务里,多个答案可能都站得住,「与单一参考答案的一致程度」更多是在衡量执行是否忠实,不能直接等同于分析是否有效。
八、想试的话,怎么开始
项目已在 GitHub 开源,MIT 许可:github.com/jmiao24/Paper2Agent,配套网页入口 paper2agent.ai。值得注意的是,现在的形态已经不是传统命令行工具,而是一个装进编程智能体里的 skill,可跑在 Claude Code、Codex 或 Gemini CLI 上:
/paper2agent Convert https://github.com/scverse/scanpy into tested MCP tools in Scanpy_Agent.
Focus on the "Preprocessing and clustering" tutorial.
转换完成后会交付一个 ZIP(含 USAGE.md,写明测试过的解释器、入口、环境变量),解压后让智能体按说明配置连接即可。接远程服务器用一条命令,再用 claude mcp list 确认连上:
claude mcp add --transport http <MCP_NAME> <MCP_ENDPOINT_URL>
claude mcp list
不想自己转换,也可以直接连作者托管好的三个现成 MCP 服务器:AlphaGenome、Scanpy、TISSUE(都在 huggingface.co 的 Paper2Agent 空间下,端点形如 Paper2Agent-scanpy-mcp.hf.space)。论文 DOI:10.1038/s41586-026-11044-y。
一句话总结:知识传播的终点不该只是「可读」,还应该是「可调用」。当一篇论文能回答问题、能跑流程、能被别的论文智能体连上时,知识就从文献变成了工具。对做知识社区的人来说,这同样是个提醒——一个知识点如果只能被读到,它只完成了一半。
参考资料:Miao J, Davis JR, Zhang Y, Pritchard JK, Zou J. Reimagining research papers as interactive and reliable AI agents. Nature, 2026. doi:10.1038/s41586-026-11044-y;项目仓库 github.com/jmiao24/Paper2Agent。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…