把结构塞进预训练:11 月 5 日的 RNA 基础模型做了什么
中科大团队 11 月 5 日在 Nature 发表开源 RNA 序列基础模型 structRFM,用约 2100 万条「序列—二级结构」配对数据同时学序列上下文与结构依赖,输入一段序列就能给出三个层级的特征,供结构预测和功能推断使用。数据、权重、代码全部开放。通稿说性能达国际前沿水平,没给具体分数。这点值得单独说。
RNA 和蛋白质不一样,它的功能很大程度写在折叠上。同一串 A/C/G/U,配对方式变了,二级结构就变了,进而影响它跟谁结合、在细胞里干什么。只把 RNA 当一串字母训模型,等于故意不看一半信息。11 月 5 日发表在 Nature 的 structRFM,做的就是补上这一半。
团队来自中国科学技术大学,周少华教授与特任研究员熊鹏为共同通讯作者,博士生朱河勤是第一作者。他们先构建了约 2100 万条经计算注释的「序列—二级结构」配对数据,再设计算法让模型在同一个预训练过程里同时学序列上下文和结构依赖。训完之后输入只需要序列,模型能输出序列级、核苷酸级、核苷酸对级三种特征。
为什么是「核苷酸对级」
二级结构本质上是一张配对表:第 i 位和第 j 位配不配对。所以只给每个位置一个向量不够,得给位置两两之间也能表达关系。RNA 基础模型里这一层特征最直接对应的就是结构预测任务。官方通稿列出的下游任务包括零样本同源性分类、二级结构预测、把特征接进三级结构预测模型后改善三维结构及其对应二级结构的预测,以及剪接位点预测、内部核糖体进入位点(IRES)识别、非编码 RNA 分类。
两个细节我觉得比任务清单更有信息量。一是模型在新发布的 RNA 家族上仍保持了二级结构预测表现——对新家族,而不是对训练时见过的家族;二是用分段策略把分类任务扩展到长链非编码 RNA。前者是泛化的证据,后者是工程上的老实办法:序列太长,切段处理。
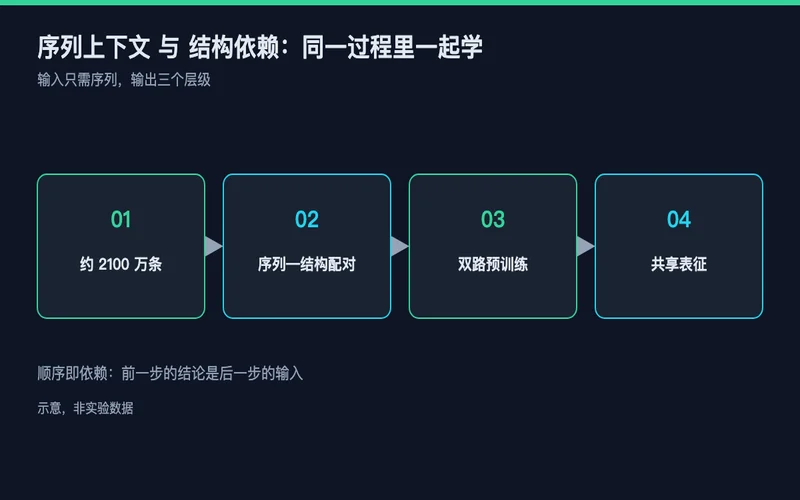
图1:序列上下文与结构依赖双路预训练的示意
消融实验说了什么,通稿没说什么
报道提到消融实验验证了「结构信息的引入」和「掩码策略」各自对性能提升有作用。这句话其实是在回答一个很具体的质疑:把结构标签一起喂进去,涨点到底是结构带来的,还是掩码方式变了带来的。拆开验证,才算把功劳分清楚。
得说清楚来源边界。中科院、新华社和中国科学报的报道都用了「多项任务达到国际前沿水平」这样的表述,没有列出具体数值、基线模型或测试集。本文不复现分数,也不替它推算提升幅度。想要数字,得去看论文正文和补充材料。另外「约 2100 万条经计算注释」——是计算注释,不是实验测定的结构,这一点在评价泛化能力时不能略过。
真正让人愿意跟进的是开放程度:完整配对数据、模型权重和源代码都已开放。国内生物大模型里,把三样一次性放齐的并不算多。复现这件事能不能做,不看新闻稿,看仓库。
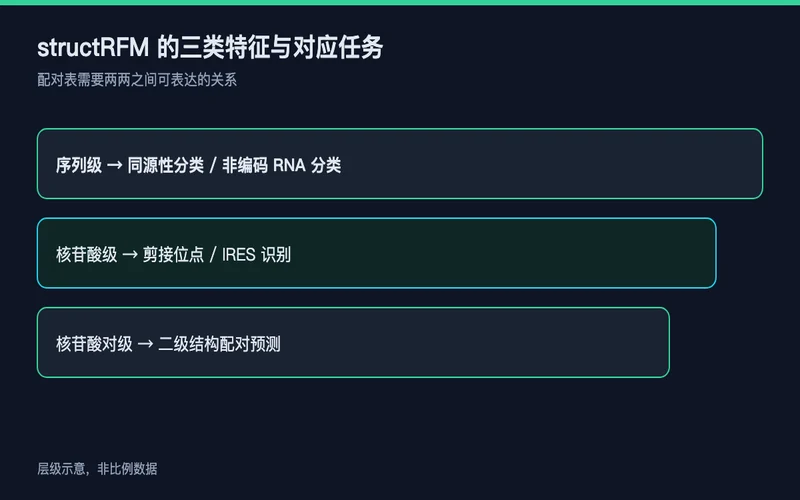
图2:structRFM 输出的三类特征与下游任务
核心信息来源
中国科学报 / 中国科学院网站 2026-11-06、新华社 / 央视网 2026-11-05:提供 2026-11-05 发表于 Nature、团队与作者姓名、约 2100 万条配对数据、三层特征、下游任务清单、新 RNA 家族表现、分段策略、消融结论、数据权重代码开放、DOI 10.1038/s41586-026-11210-2。Nature 论文页(doi.org/10.1038/s41586-026-11210-2):论文与补充材料入口,本文未取得具体分数。文中对「计算注释 vs 实验结构」的区分与「看仓库不看新闻稿」的判断:本文自述,不是官方口径。
关联推荐
- AI 开始读 30 亿字母「天书」:基因组语言模型 GPN-Star — 基因组序列上的另一套预训练思路
- AI 用大白话「写」出能用的蛋白 — 从读序列到写功能,条件生成怎么接上实验
- 为什么 AI 医疗评测不能只看榜单 — 没有基线和测试集的性能描述该怎么读
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…