AI 开始读 30 亿字母"天书":基因组语言模型 GPN-Star
2026 年 9 月,UC Berkeley 的 GPN-Star 把 A/C/G/T 当"字母"学全基因组的"语法",用多物种比对训练,预测致病变异更快更准,训练从数月压到几天,成为"虚拟细胞"的基础设施。
人类基因组大概有 30 亿个碱基对,写成字母就是 A、C、G、T 四个符号排成的长串。对生物学家来说,这不是密码,是一本用四种字母写成的、没人给过词典的天书。过去找里面的"错字"(致病变异),基本靠统计哪个位置在病人里出现得反常多。
2026 年 9 月,UC Berkeley 的团队放出 GPN-Star,思路很直白:既然语言模型能学会英语的语法,那它能不能学会基因组的"语法"?他们把 A/C/G/T 当成词表,拿人、鼠、鸡、果蝇、线虫、拟南芥等多个物种的基因组一起训练——让模型先搞懂"正常的基因序列长什么样",再来判断哪个位置被改了之后"读起来别扭",从而推测它是不是致病变异。
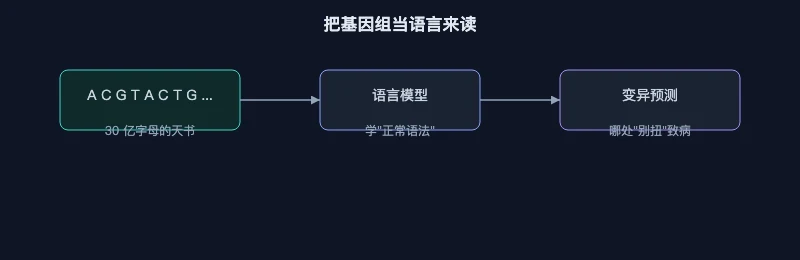
图1:基因组语言模型的工作流,和读英文找语病异曲同工
最实在的好处是速度。过去训练这类模型动辄几个月,GPN-Star 把周期压到了几天。它不光快,还更准——因为拿多个物种一起比,模型能区分"这个位置在所有物种里都保守,所以突变多半要命"和"这个位置本来就随心所欲,突变无所谓"。这种跨物种的"共同语法",是人类单一基因组给不了的视角。
研究者把它定位成"虚拟细胞"的基础设施:不是直接告诉你答案,而是给你一个能快速扫一遍 30 亿字母、标出可疑之处的引擎。它当然会出错,语言模型写诗也会胡说,但作为第一遍筛查工具,比人肉翻文献快了不知几个数量级。等那天"读基因"像"查单词"一样便宜,精准医疗的门槛会低一大截。
[关联推荐]
- 90 亿种单字母变异,一次性算完:AlphaGenome Atlas 上线 — 同样是 AI 读基因组的工具
- 基因测序简史:从九千五百万降到五百美元 — 为什么读基因越来越便宜
- 转座子:基因组里那些会「跳」的序列 — 基因组里不止 A/C/G/T 的静态信息
- 单细胞测序与脑图谱:从读序列到读细胞 — 测序技术的另一条延伸
来源:Nature:GPN-Star 基因组语言模型(UC Berkeley,2026-09-09,DOI 10.1038/s41586-026-11005-5)
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…