别神话大模型:一个 10 年前的老模型,皮肤癌诊断把 2026 最强 AI 比了下去
皮肤科研究者用 200 张活检样本比测两个前沿大模型与一个仅微调 20 分钟的十年前 CNN,旧模型六选一答对 62%,大模型仅 42%,其中一个把早期黑色素瘤高置信误判为基底细胞癌。越大越准的神话,碎了。
这些年我们听惯了一句话:模型越大越准,新模型一定吊打旧模型。一位皮肤科研究者偏要做个"不识趣"的实验——他拿出两个 2026 年的前沿大模型,和一个在十年前架构上只微调了 20 分钟的CNN(卷积神经网络),让它们在同一批 200 张皮肤活检样本上做六选一诊断。
结果很扎心。那个老 CNN 答对了 62%,两个大模型分别只有 42% 左右。更刺眼的是,其中一个大模型把一张早期黑色素瘤,以高置信度判成了良性的基底细胞癌——这恰恰是最危险的一类误判:不是"没把握",而是"很自信地错"。
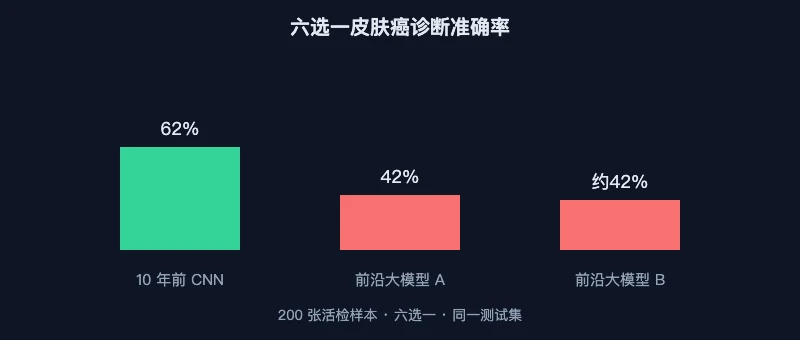
图1:旧 CNN 在独立活检集上反而更稳
为什么"大的"会输给"老的"
这不是说大模型不行,而是说任务和模型体量之间没有自动等号。皮肤镜图像是高度标准的"看图分类"问题,CNN 这种为图像量身定做的结构,参数量小、见过足够多的同类切片就能做稳;而通用大模型被训练去"什么都会说",在严格医学判别上反而容易被表面纹理或分布偏移带偏。
更关键的变量是数据分布。很多公开榜单的高分,来自模型在和训练集高度同源的数据上"背题"。一旦换到真实临床活检这种分布略有不同的样本,没见过的模式就露馅。那个被高置信误判的早期黑色素瘤,正是分布偏移下的典型翻车。
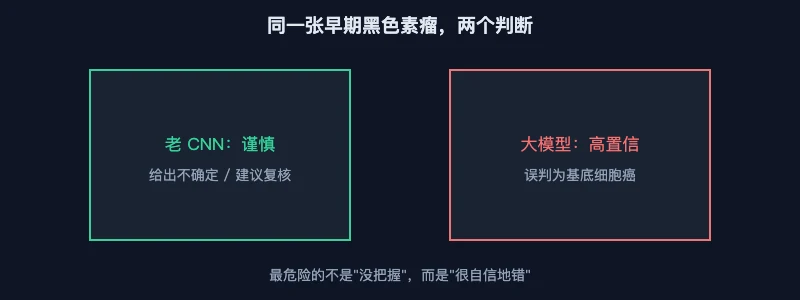
图2:同一病例,错误置信度决定风险高低
对普通人的提醒
这项研究不否定 AI 辅助诊断的价值,但它戳破了一个营销泡泡:别因为某个工具挂着"大模型"三个字就无条件信任。真正靠谱的医学 AI,要在独立、贴近真实的验证集上反复考,并把"我不确定"当作一种输出,而不是永远给你一个斩钉截铁的答案。
关联推荐
- 欧洲的万亿参数答案:Mistral Large 4 用"开放权重"打主权牌 — 看 2026 大模型格局另一面
- 大脑只用了 10%?一条百年谣言的考据与证伪 — 同理:别被"听起来很猛"的说法带节奏
- "AI 发现 79 个内核漏洞"审计之后:10 个是真的 — 另一场"大模型神话"的实地核查
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…