为什么 AI 医疗榜单第一,到了真实病人身上就翻车
从"10 年前老 CNN 在皮肤癌诊断上赢了前沿大模型"引申:大模型在公开榜单高分,却在 200 张独立活检集翻车,根因多为训练集污染与分布偏移。科学评测的铁律——独立验证集、盲测、报告置信误判。
今天头牌那篇"老 CNN 胜大模型"的研究,真正值得记住的不是谁输谁赢,而是一个被反复验证、却总被忽略的常识:榜单第一,不等于真实世界第一。一个模型在公开排行榜上风光无限,换个分布略不同的真实样本集,分数可能断崖式下跌。
根因通常两个。其一是分布偏移:训练集和测试集其实来自同一来源、同一批设备、同一家医院,模型只是"背熟了这道题"。其二是数据污染:测试样本不小心混进了训练数据。两者都让"高分"变成自我安慰。
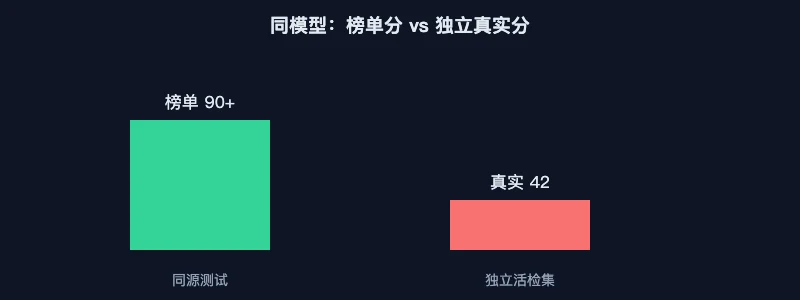
图1:同一个模型,两场考试的分数可以差出天际
三条铁律
医学 AI(其实所有 AI)评测,有几条绕不开的规矩。第一,用独立验证集——数据来源、设备、人群都要和训练集拉开差距。第二,盲测——模型在评估时看不到答案,也不能拿训练见过的样本充数。第三,报告置信误判——不仅要说"准不准",还要说"错了的时候错得多离谱、是不是高置信地错",后者在医疗里要命。
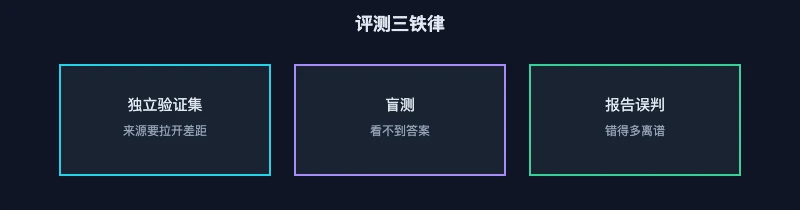
图2:三条规矩,缺一条都不算数
这对普通人意味着什么
下次看到"某 AI 诊断准确率超过医生"的新闻,先别急着转发。问一句:它在什么数据上测的?是不是独立的?有没有说清楚它误诊的情形?真正靠谱的医疗 AI,会把"我不确定"当作一种输出,而不是永远给你一个斩钉截铁的答案——这也正是那篇老 CNN 研究最朴素的提醒。
关联推荐
- 视网膜 AI 提前算出子痫风险:1267 次怀孕做出来的准确率 — 看一次"样本量 + 真实分布"如何撑起可信度
- "AI 发现 79 个内核漏洞"审计之后:10 个是真的 — 另一场对 AI 高调声明的实地核查
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…