90 亿种单字母变异,一次性算完:AlphaGenome Atlas 上线
DeepMind 把序列到功能模型对全基因组约 90 亿种单核苷酸变异的预测预先算好,打包成约 1 PB 的图谱发布,同时给出 AVI 评分。非编码区从“逐个查”进入“先全量筛”的阶段。
人类基因组约 30 亿个碱基,每个位置可以变成另外三种之一,组合总数约 90 亿。要逐个用实验判断这些变化是否影响健康,是个不可能完成的任务。正是在这里,计算模型有了用武之地。
2026 年 9 月 8 日,Google DeepMind 发布了 AlphaGenome Atlas。它不是新的测序数据,而是一整套预计算的预测结果:对 hg38 参考基因组上所有可能的单核苷酸变异,给出分子层面的效应估计。
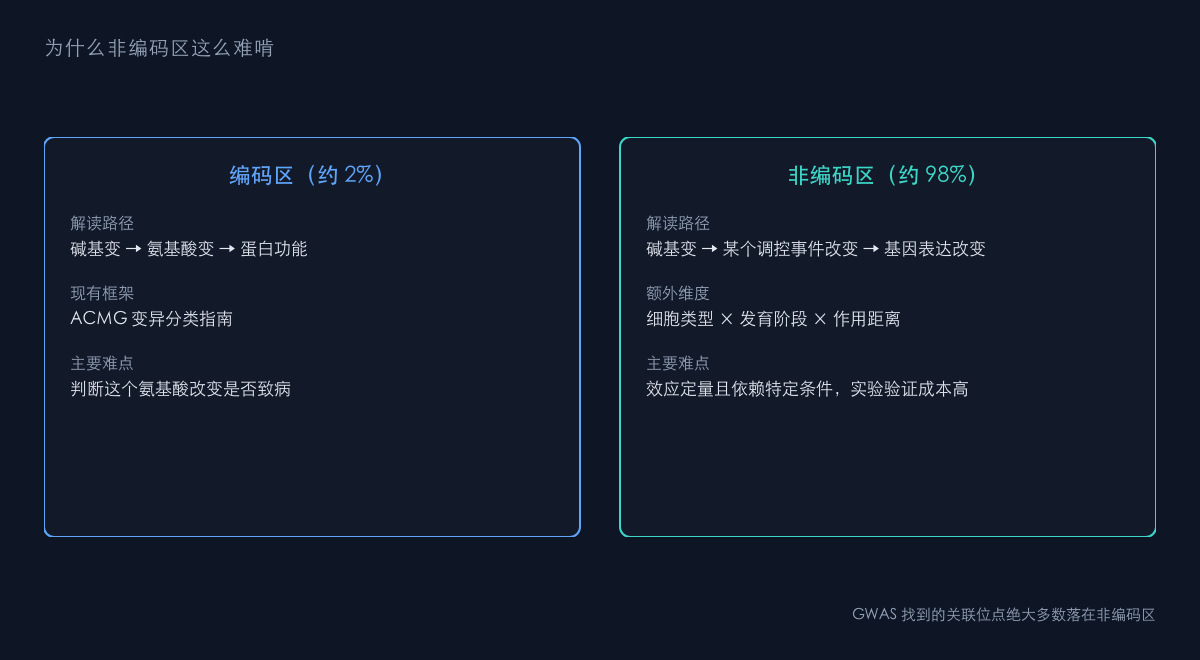
图1:绝大多数变异落在非编码区,而那里恰恰最难解读
图谱里装了什么
底层模型是 AlphaGenome——一个序列到功能的模型,2025 年 6 月首次公布,相关论文 2026 年 1 月发表在《自然》。它能处理长达一百万碱基对的输入,预测变异对基因表达、RNA 剪接、染色质开放性等过程的影响。
Atlas 做的是把这套预测在基因组尺度上提前跑完,也就是体外饱和诱变(in silico saturation mutagenesis)。除了单核苷酸变异,团队还评估了 gnomAD、UK Biobank、All of Us 等群体数据中观测到的一亿多个插入与缺失。
每个变异平均带 27,000 个实验特异性的标量预测,覆盖数百种人和小鼠的细胞类型与组织。整个数据集约 1 PB,规模是 2022 年扩容后的 AlphaFold 数据库的三十多倍。
配套发布的还有 AlphaGenome Variant Impact(AVI)评分。它把 AlphaGenome 的预测与此前的 AlphaMissense 蛋白模型、保守性特征、功能丧失特征合并成单一数字,用于跨编码区和非编码区统一排序。每个 AVI 分数附带特征归因,能指出这个变异的影响主要来自剪接改变还是表达量改变。
图谱还收录了 2,601 个重现性 DNA 序列基序,以及它们在不同细胞类型中的定位——可以把它理解为基因组调控“词汇表”。
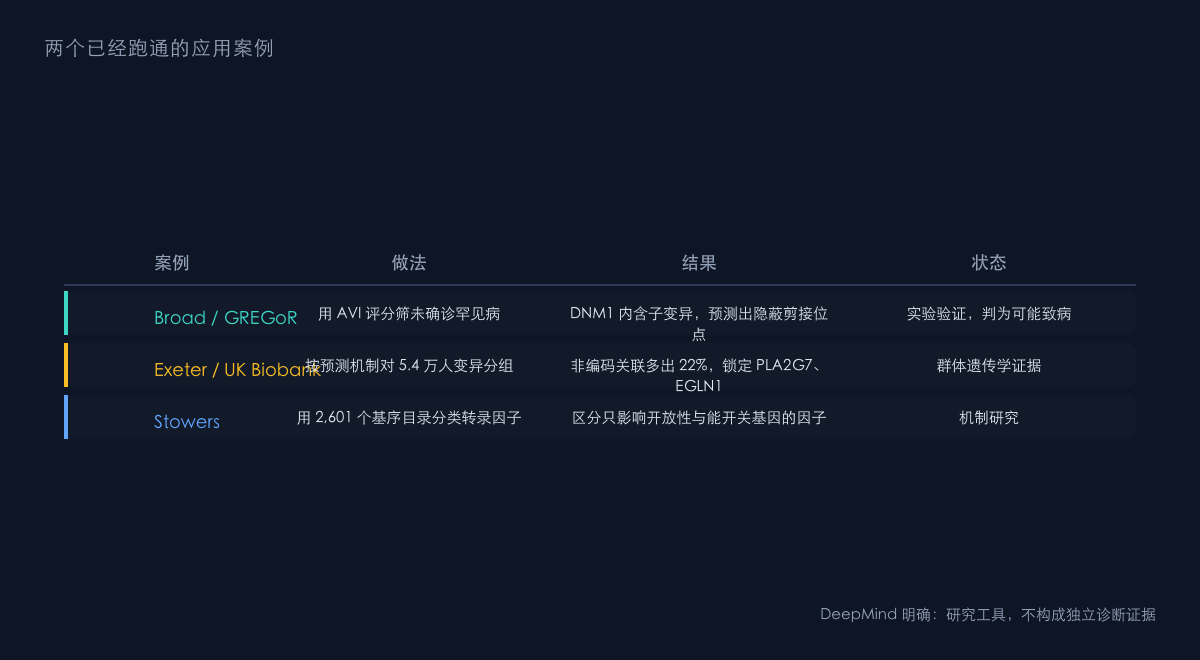
图2:从罕见病诊断到群体遗传关联,两条不同的使用路径
已经有人用它解决了实际问题
博德研究所的 Laura Covill 与 Anne O'Donnell-Luria 联手 GREGoR 联盟,把 AVI 评分用在未确诊的罕见病病例上。其中一个案例锁定了 DNM1 基因深处的一个内含子变异——这个基因与癫痫性脑病强相关。AlphaGenome 预测该变异会产生一个脑特异性的隐蔽剪接位点,使蛋白延长 13 个氨基酸。后续实验筛选验证了这个预测,并找到了邻近的同类变异,支持该变异被归类为“可能致病”。
埃克塞特大学的 Gareth Hawkes 把 Atlas 用在超过 5.4 万名 UK Biobank 参与者的全基因组数据上。按预测的分子机制对罕见变异分组之后,他发现了比以往多 22% 的非编码区与循环蛋白水平的关联,锁定了影响 PLA2G7(与衰老相关)和 EGLN1(细胞氧感受器)的调控变异。再聚焦到 Atlas 预测影响最大的 1% 非编码变异,他找到了 19 个与体重指数相关的基因组区域。
加州大学圣迭戈分校的遗传学家 Jonathan Sebat 描述的是工作流程层面的变化:实验室自己的流程可以大幅简化,因为基本上不需要再自己算,直接查就行。
边界在哪
DeepMind 在论文里写得很明确:Atlas 和 AVI 是研究工具,预测的是分子效应,只能作为通往临床诊断的证据链的一环,不能单独作为充分证据。AlphaGenome 没有经过临床验证或批准。
模型的训练数据也有缺口,包括缺失部分细胞类型和非多聚腺苷酸化 RNA。团队把这版 Atlas 定位为基线,精度会随底层模型改进而提升。IEEE Spectrum 的报道还提到一个现实约束:AlphaGenome 模型本身很慢、算力需求高,这也正是预计算图谱对多数实验室有实用价值的原因。
访问方式上,网页门户、AlphaGenome API 以及 Google Antigravity 里的技能对非商业研究免费开放,商业版本计划通过 Google Cloud 提供。AVI 分数的静态下载采用宽松许可,商业和学术都可用。
来源
Google DeepMind: AlphaGenome Atlas (2026-09-08);《自然》同期报道
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…