删掉不到 0.05% 的权重,就能顶一次全量微调
arXiv 2611.10866 提出 Deletion Tuning:在 Transformer 的 gate 投影上学一个二值掩码,把不到 0.05% 的权重置零,其余一律不动,在可验证奖励强化学习、监督微调、同策略蒸馏三种后训练上都追平全量微调。掩码比全量检查点小几百到几千倍,且旧任务遗忘明显更少。
微调的直觉是「多改一点,学得更透」。这篇论文把这个直觉翻过来:把预训练模型的一小撮权重直接置零,别的都不碰,效果和全量微调打平。
方法本身简单到有点意外。在 Transformer 每个块的 gate 投影上,学一个二值掩码——某个位置是 1 就保留原权重,是 0 就置零。训练完只存这个掩码,不存权重。掩码是二值的,所以字典序压缩之后体积比对应的全量微调检查点小几百到几千倍。论文说这个规模下,可验证奖励的强化学习、监督微调、同策略蒸馏三种后训练,Deletion Tuning 都能追平全量微调。
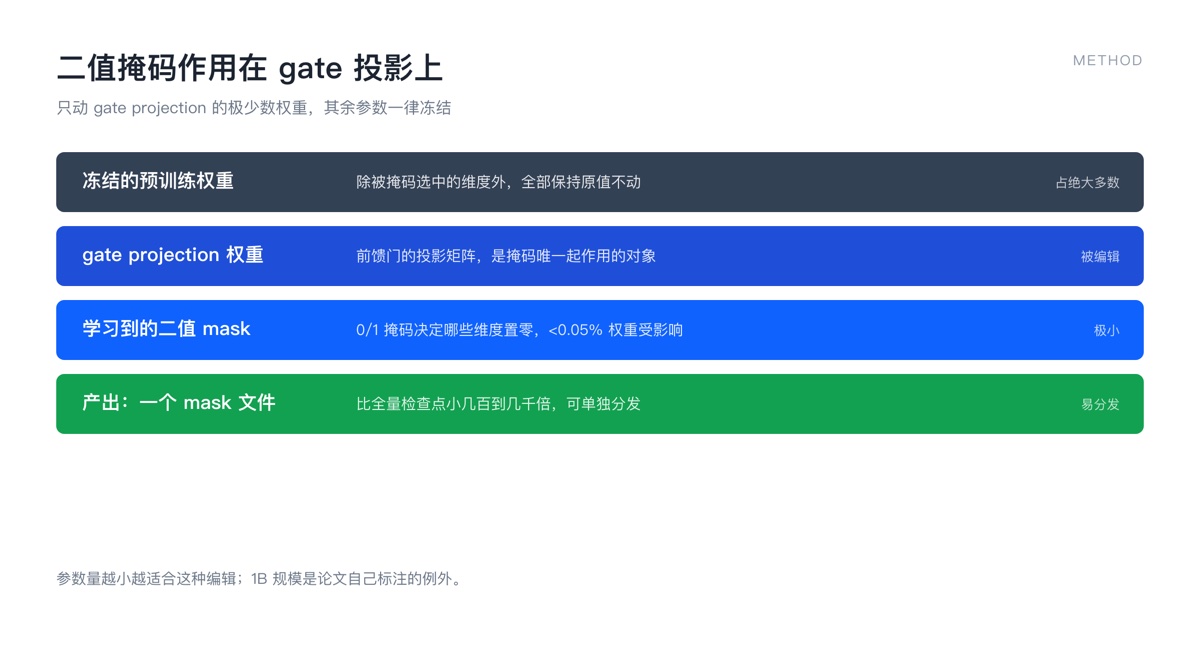
二值掩码只作用在 gate 投影上。
第二个结论更有意思:它忘得少。在强化学习之后,模型在原任务上的准确率基本停在底座水平;全量微调、LoRA 和随机稀疏微调最多掉 5.4 个百分点。对持续学习来说这几乎是刚需——企业场景里没人愿意为了学会一个新流程,把旧流程的手感弄丢。
为什么置零有用?论文给的解释不是「删掉冗余」,而是几何:用稳定秩(stable rank)、谱漂移(spectrum drift)和主权重重叠三个量,比较不同方法学到的权重变化。Deletion Tuning 的变化在三个度量上都最接近全量微调,而 LoRA 和随机稀疏微调偏离得更远。换句话说,全量微调真正起作用的部分,可能就是在少量方向上把权重关掉,而不是在所有方向上小幅挪动。
保留意见也得写。报道提到在 1B 规模上这个结论不完全成立,论文标题里的「at scale」本身就是限定;二值掩码的搜索是离散优化,训练稳定性依赖实现细节;置零是不可逆的,一旦选错位置没有退路。把它当成「便宜版全量微调」可以,当成通用替代品还早。
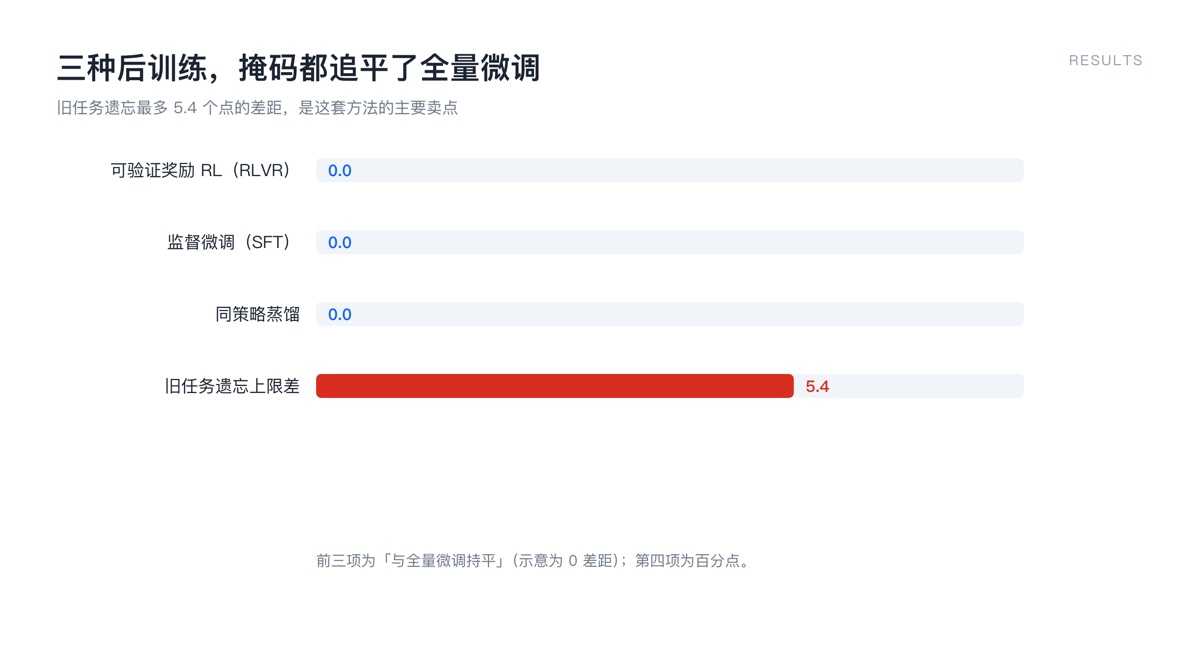
三种后训练方式下,掩码与全量微调的差距。
对工程团队的实际意义:如果你在做多任务连续微调,又不想每次都存一份全量检查点,这条路线值得试。先在小模型上验证掩码的稳定性,再放大。
[关联推荐]
- 本地 LLM 微调实战:用 0.6B 参数模型实现 92% 分类准确率 — 微调的工程视角
- 小米把训练过程一起开源了:75 万条轨迹,7000 个环境 — 后训练数据长什么样
来源:《The Surprising Effectiveness of Deleting Weights in LLM Post-Training》,arXiv:2611.10866(2026-11-07,NeurIPS 2026);Traictory 报道(含 1B 规模的例外)。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…