Qwen4-Max:2.4 万亿参数、原生视觉,单任务成本砍到 1.67 美元
阿里 11 月 16 日发布 Qwen4-Max,总参数 2.4 万亿,原生支持图像与视频理解,上下文 100 万 token。输入 1.5 美元、输出 4.5 美元每百万 token,隐式缓存命中 0.075 美元。官方称在自家 Work360 上单任务成本从 4.43 美元降到 1.67 美元,token 用量少 24% 至 35%。
先把几个数摆清楚。2.4 万亿是总参数,MoE 结构下每次推理只激活其中一部分;上下文 100 万 token;原生视觉意味着图像和视频不需要外挂编码器再喂进去。定价上,输入 1.5 美元、输出 4.5 美元每百万 token,隐式缓存命中的输入只要 0.075 美元,是常规价的 5%。官方说每一项都低于上一代 Qwen3.8-Max。
发布稿里最能打的一个数字不是跑分,是成本:在 Work360 这套自建评测上,平均单任务成本从 4.43 美元降到 1.67 美元,降 62%。拆开看,一半来自单价下调,一半来自「少说废话」——同样任务 token 用量少 24% 到 35%,Terminal-Bench 4.0 上少 48% 到 49%。任务越复杂,token 节省带来的成本差越明显,这也是为什么它敢宣传「单任务成本」而不是「每百万 token 价格」。
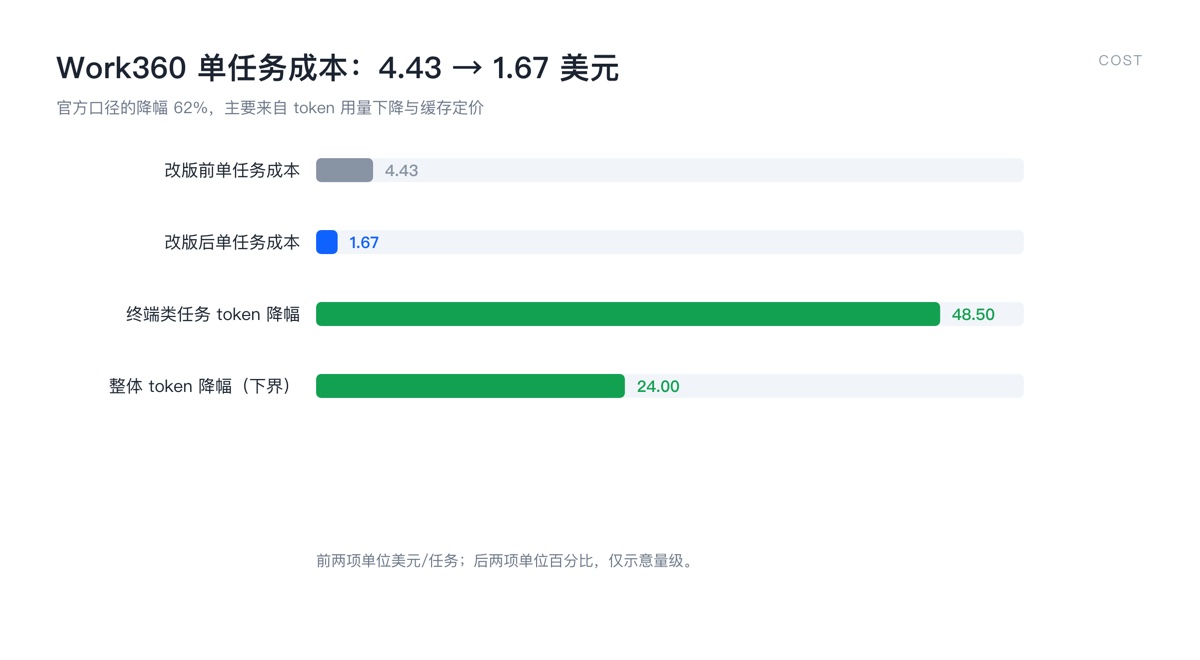
Work360 单任务成本的官方口径变化。
能力面上,官方给的位置是 Code Arena 第 6 名,另外在 Agents' Last Exam、Vals Index、JobBench、Chartography 上有分数。这些名字里,Code Arena 是公开的实战编程榜,可信度相对高;其余几项有的是第三方、有的是自家或合作方设计的基准,看的时候得分开对待。
这里必须泼一点冷水,理由和本批知识点一致:Work360 是私有基准,题库不公开,成本结论无法外部复核。62% 的降幅很可能是真的,但它回答的是「在阿里的题库上更省」。如果你手里的活是长文档抽取、批量结构化,token 节省比例会不一样——尤其是输出被截断、需要重试的时候,单价优势会被重试次数吃掉。
真正值得关注的是 100 万上下文与原生视觉的组合。上一代模型处理长上下文,常见做法是把图先转成文字描述再塞进去,中间丢信息;原生多模态加长窗口,可以直接把整本手册、整段视频丢进去。代价是首字延迟和显存,MoE 与缓存定价就是为这个代价准备的补丁。
采购建议很朴素:拿你自己的 20 个真实任务跑一遍,记录 token 数、重试率、人工返工时间,算总成本。别用别家的单任务成本做预算,那个数字里有一半是题库的形状。
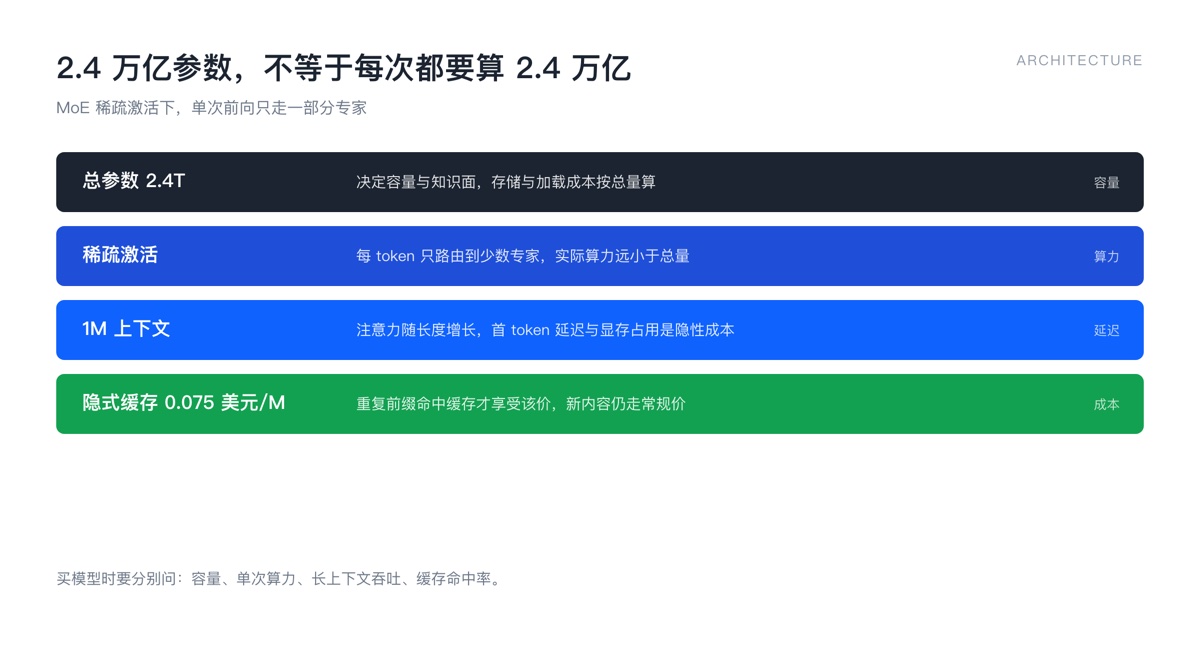
总参数与单次激活算力不是一回事。
还有一个隐藏成本要提前算。100 万上下文的请求,首 token 延迟往往在秒级起步,交互式场景里体验会明显变差;并发一高,显存占用按上下文长度线性上涨,服务端要么排队要么加机器。缓存定价能压住重复前缀的开销,压不住你每次都要读一遍的新内容。真要做长文档流水线,先测吞吐,再谈单价。
[关联推荐]
- OpenAI 静默缩减 Codex 上下文:372K 到 272K 的成本权衡 — 长上下文的账怎么算
- Agentic ESOpt:用进化策略替代 RL,微调长周期 Agent 只要推理级显存 — 同一条「省算力」路线
来源:Alibaba Cloud 新闻稿(2026-11-16);QwenCloud 模型与定价页;Sulat 报道(token 降幅与单任务成本)。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…