27B 的模型在仿真里学会开机器人,搬到真机上成功率 60%
一篇新论文报告,一个开源 270 亿参数推理模型在纯仿真环境里用强化学习后训练,就能直接操控真实机器人,全程不需要人类示范。仿真基准 LIBERO 上成功率从 1.6% 拉到 74.4%,真实双臂机器人实测成功率 60%;在换了任务但场景熟悉的条件下,对照的视觉语言动作模型只有 0.75%,它做到 57.4%。
机器人领域一直有个尴尬的数字:仿真里跑得很好,真机上什么都做不了。原因不难理解,仿真与现实的差距体现在每一处细节——摩擦系数、传感器噪声、光照、物体材质,甚至相机轻微的位移。传统做法是用人类示范数据去微调,代价是采集成百上千条操作轨迹。
这篇的思路相反:不用示范,只在仿真里做强化学习。具体做法是给一个 270 亿参数的开源推理模型配一套后训练引擎,让它在大量仿真机器人任务上按强化学习的方式学习操作——直接观察环境、以思维链方式推理、自行输出末端执行器的下一个姿态,不依赖专用硬件接口或动作约束框架。
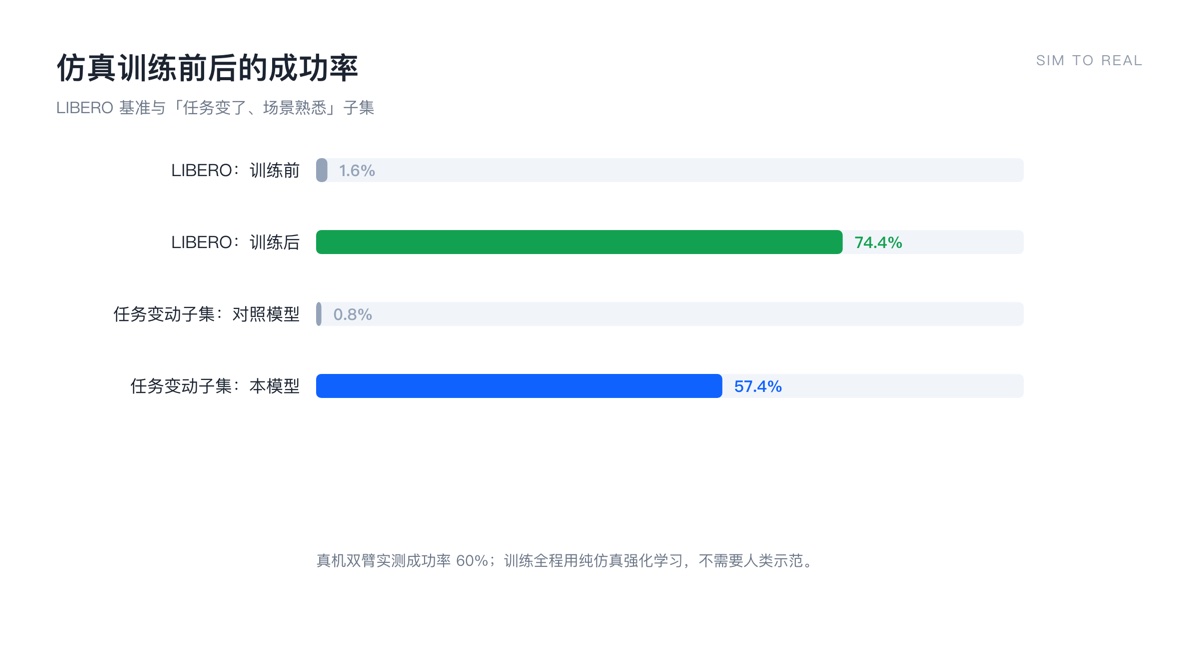
仿真训练前后的成功率:LIBERO 1.6% 到 74.4%,任务变动子集 0.75% 与 57.4%。
数字是这篇最有说服力的部分。在 LIBERO 基准上,训练把成功率从 1.6% 提到 74.4%,接近前沿模型在最大推理投入下的水平;在真实的双臂机器人上,直接测试成功率 60%,而未训练的基础模型完全做不完任何一个任务。
更能说明泛化能力的是那组对照。研究者构造了一个「任务变了但场景熟悉」的子集,另一个基于示范数据微调的视觉语言动作模型在这里只有 0.75%,而它在 57.4%。差别在于前者学到的是「怎么在环境里完成任务」的一般能力,后者学到的是「这条轨迹怎么走」的映射——任务一变,映射就失效。
还有一个细节值得注意:模型在仿真里学到的技能可以迁移到未见过的机器人本体。这意味着学到的不是某台机器的关节角度,而是与环境交互的策略表征。同时它在九项覆盖推理、编程与视觉理解的通用评测上保持了原有水平,说明后训练没有把基座能力换掉。
这组结果需要谨慎读。第一,60% 是特定任务集上的实测,不等于通用操作能力;第二,仿真到真机的成功往往依赖仿真环境的保真度与随机化设计,换一套仿真平台结论可能变;第三,只靠一个模型的推理能力去驱动低层控制,实时性与安全性还没有被充分评估——真机上的 40% 失败是怎么失败的,比成功的 60% 更值得看。
方向上,这条路线把「数据」的位置挪了一下:以前瓶颈在示范数据的量与多样性,现在瓶颈在仿真环境的覆盖度与后训练算力。对做具身智能的团队,这意味着投入结构会变——从雇人采集轨迹,转向搭仿真、做域随机化、以及把推理模型与控制回路的接口打磨好。
[关联推荐]
- SWE-bench:代码 Agent 到底有多能改代码 — 「推理模型加环境」的另一条应用线
- 工具调用为什么会退化 — 长链路推理在真实环境里的稳定性问题
- 让 AI 用大白话写蛋白 — 生成与验证分离的另一种设计
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…