AI 在军棋上赢过顶级人类:它学会了虚张声势
象棋和围棋早已被 AI 攻克,但那些棋盘上每一步都摆在明处,所有棋子的位置双方都看得到。这类完全信息环境里的胜利,不等于 AI 也能应付那些藏着牌的局面。由 MIT、卡内基梅隆(CMU)、纽约大学(NYU)和斯坦福(Stanford)合作研发的 Ataraxos,把目标放在了 Stratego 上。
象棋和围棋早已被 AI 攻克,但那些棋盘上每一步都摆在明处,所有棋子的位置双方都看得到。这类完全信息环境里的胜利,不等于 AI 也能应付那些藏着牌的局面。由 MIT、卡内基梅隆(CMU)、纽约大学(NYU)和斯坦福(Stanford)合作研发的 Ataraxos,把目标放在了 Stratego 上。
Stratego 是一种双方都看不到对方棋子的棋类。你不知道对面哪个子能炸、哪个是炸弹、哪个是将领,只能靠每一步的试探去推断。它要求玩家一边隐瞒自己的布局,一边虚张声势,还要为几十步之后做规划。
Ataraxos 击败了精英级人类玩家。关键不在于它算得更深,而在于它学会了处理不知道这件事:在信息不对称的局面里建模不确定性,主动放出假信号,再根据对手的反应修正判断。
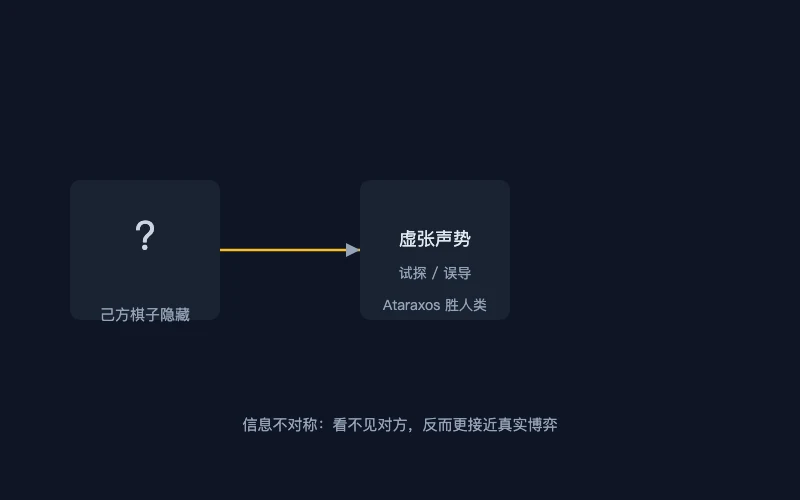
图1:Ataraxos 在双方互不可见棋子布置的 Stratego 对局中作战
为什么这比再拿一个棋类冠军更值得写?因为隐藏信息与欺骗几乎出现在所有真实的复杂互动里。谈判桌上双方都不会亮出底牌,网络攻防里防守方看不到对手的完整意图,多个智能体在市场中互相试探。能在这种不完整数据里做决策、还能识别对方是否在诈唬的模型,适用性明显宽于只会下某一类明棋的系统。
背景要补一句:AI 在完全信息棋类战胜人类已是旧闻。真正的硬骨头是隐藏信息加欺骗,这关此前一直没被干净地啃下来。Ataraxos 的意义,是把学会虚张声势从人类专属的标签上撕下一块。
当然,棋盘终究是简化过的世界。真实谈判或网络对抗里的信息结构远比一枚棋子复杂,规则也不会写在说明书上。论文给出的,是一种在不确定中决策的范式,而不是一套能直接搬进战情室的系统。
研究者把它定位为迈向更通用决策智能的一步。比起某个具体分数,更值得记下的是这个方向:让模型习惯看不全,并为此调整自己的策略。
关联推荐
- Right to Local Intelligence:一场关于本地 AI 权利的宣言运动 — 当模型学会在本地自主决策,谁该为它的判断负责。
- 从读基因到写生命:合成生物学用 30 年把测序仪变成了打字机 — 另一条从读懂到动手的技术曲线。
参考来源:Engineers Ireland / 多家媒体对 Ataraxos 的报道;参见 andrewhansen.au 2026-10 Machine Learning Breakthroughs。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…