AlphaGenome 2:把「哪个细胞」写进模型,变异召回率翻倍
11 月 11 日,Google DeepMind 发布 AlphaGenome 2。上一代在组织层面预测变异影响,这一代改成条件模型:每次只预测一个细胞类型或细胞状态,训练数据覆盖 68 种组织、逾 1.07 亿个单细胞。在 28 种原代免疫细胞的数据集上,识别因果变异的比例从 16% 提到 30%,方向性效应从 23% 提到 43%。
人类基因组里只有约 2% 直接编码蛋白,剩下绝大部分是非编码区,负责「什么时候、在哪个细胞、表达多少」。致病突变大多落在这片区域,但同一个变异在不同细胞里的效果可能完全相反,这让「这段序列有没有害」变成一个必须带上下文才能回答的问题。
上一代 AlphaGenome 给出的答案是组织层面的:把一大块组织的信号平均起来预测。问题在于一块组织里混着几十种细胞,平均值会把少数关键细胞的特征抹平——某个变异只在内皮细胞里升高表达、在上皮细胞里降低,平均下来可能看不出变化。
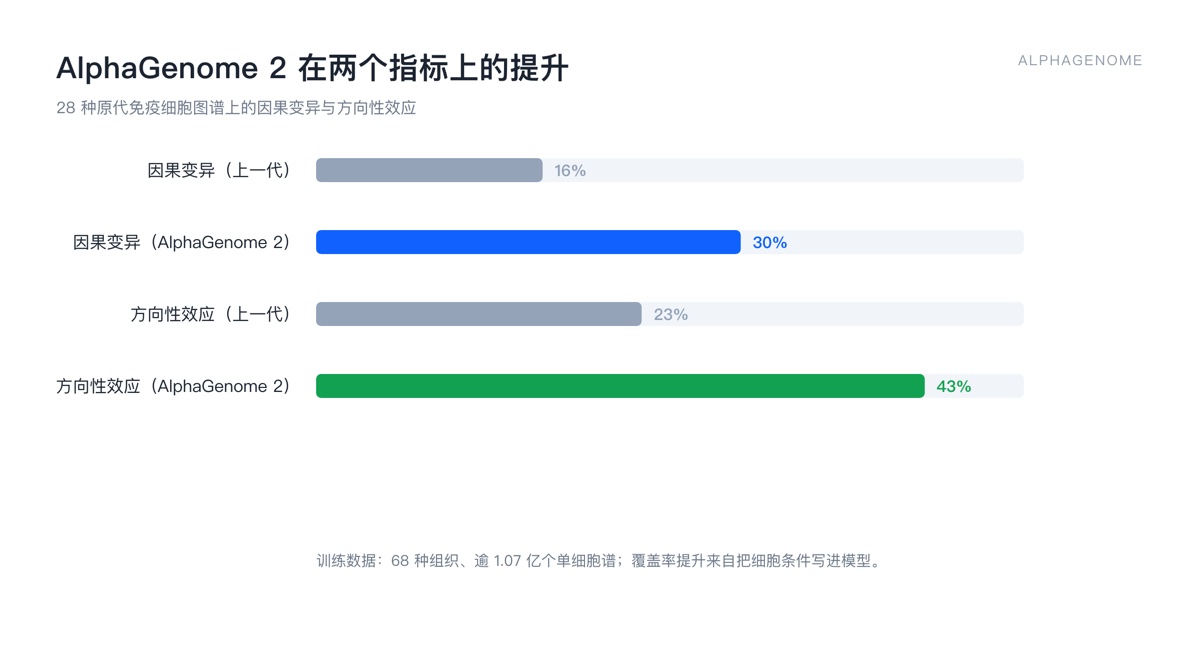
AlphaGenome 2 的提升:因果变异 16% 到 30%,方向性效应 23% 到 43%。
AlphaGenome 2 的改法是把「条件」写进模型。它不再是并行地对所有组织一次输出,而是变成条件模型:给定一个组织、细胞类型或细胞状态,只预测这一种条件下的效应。训练数据同时包含批量与单细胞数据,覆盖 68 种组织、逾 1.07 亿个单细胞谱。
指标上的提升集中在「召回」而不是「平均准确」。在一个包含 28 种原代免疫细胞类型的单细胞图谱数据集上,新模型识别出的因果变异比例从 16% 提到 30%,方向性基因效应从 23% 提到 43%——接近翻倍。这类指标的意义是:过去被平均值掩掉的那部分真信号,现在能被捞出来。
更实用的一点是它对新状态的处理方式。研究者不需要重训模型,只要上传自己实验的单细胞测序数据,就能把模型适配到没见过的细胞状态,比如疾病进展的不同阶段、用药前后、早期发育。报道里提到,用几十个细胞的数据就能得到一个可用的条件输入。
配套放出的资源规模不小:覆盖约 640 种真实人类细胞类型的调控图谱,以及近 682 万个变异在 510 种细胞状态下的预计算影响分数。上一代的 Atlas 已经把人类基因组里约 90 亿种可能的单字母变化全部预计算过一遍,数据量以 PB 计;这一代把细胞维度加了进去。API 对非商业研究免费开放,商业用途走 Google Cloud 的私有预览。
这项工作的边界也要说清楚。第一,预测的是分子层面的调控效应,不是表型或疾病风险,从「这个变异改变某细胞里某基因的表达」到「这个人会不会生病」中间还有很多步。第二,模型对训练里没覆盖的细胞状态靠条件输入外推,外推的可靠性需要用湿实验验证。第三,预计算分数是「优先级工具」,用来决定先做哪个实验,不能替代实验。
把它放进更大的趋势里看:基因组模型这两年走的路线和语言模型很像——先在海量序列上预训练,再用条件控制把「通用表征」落到具体场景。区别在于生物学的验证成本极高,一个假阳性可能烧掉几个月的实验,所以这类模型的评价标准,最终不会由 benchmark 决定,而由「省下了多少无效实验」决定。
[关联推荐]
- 2 亿参数的模型,打败了用 2000 张卡训几个月的对手 — 上一代基因组模型靠归纳偏置取胜
- RNA 基础模型:把一段序列读成结构 — 同一思路用在 RNA 上
- AI 翻遍 2.14 亿个蛋白 — 大规模预计算到底能替代多少实验
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…