算力芯片新路线:Cerebras 把三万亿参数铺满晶圆级引擎
Cerebras 官方博客演示如何把开源三万亿参数的 Kimi K3 切成 59 块晶圆级芯片:4-bit 权重量化后整层驻留 44 GB 片上 SRAM,层间只通过 RDMA 传激活值,吞吐 1000–2000+ tokens/s。
10 月 22 日,Cerebras 工程博客发了一篇实操教程:怎么在自家晶圆级芯片上跑一个三万亿参数的开源模型。他们用的例子是 Kimi K3,月之暗面开源的那个,约 3 万亿参数,93 层——其中 69 层是线性注意力,24 层是全注意力。
先看这个模型的水平:Terminal-Bench 2.1 上 88.3%(GPT-5.6 Sol 是 88.8%),BrowseComp 91.2%(GPT-5.6 Sol 是 90.4%)。开源模型在编码和 agentic 任务上咬到闭源前沿身边了。问题是怎么在芯片上把它跑起来。
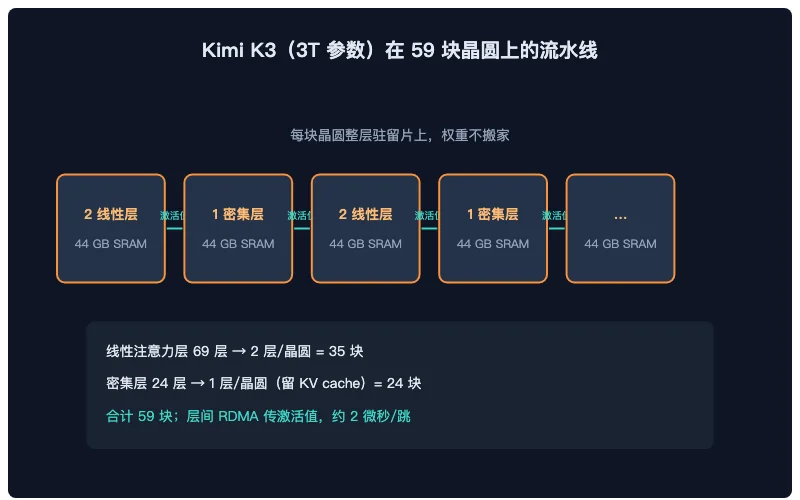
图1:Kimi K3 的 93 层被切到 59 块 WSE-3T 晶圆上,线性注意力层两块一层、全注意力层一块一层
一块晶圆 44 GB,一层权重 16 GB
Cerebras 的 WSE-3T 是一整块晶圆切下来的芯片,上面有 44 GB 片上 SRAM。和 GPU 那种「算力在芯片、权重在 HBM」的思路完全不同,它把整个模型直接放在片上。
Kimi K3 的三万亿参数,如果按 4-bit 量化存,原始 payload 是 3T × 4 bit = 12 Tbit ≈ 1.5 TB。93 层摊下来,每层约 16 GB。一块晶圆 44 GB 怎么放?Cerebras 按层类型分:全注意力层因为每个请求要存 KV cache,一块晶圆只放一层,剩下 28 GB 留给 KV cache;线性注意力层不需要存每 token 的 KV(它只维护一个固定大小的状态),一块晶圆能放两层,2 × 16 = 32 GB,还剩 12 GB 余量。
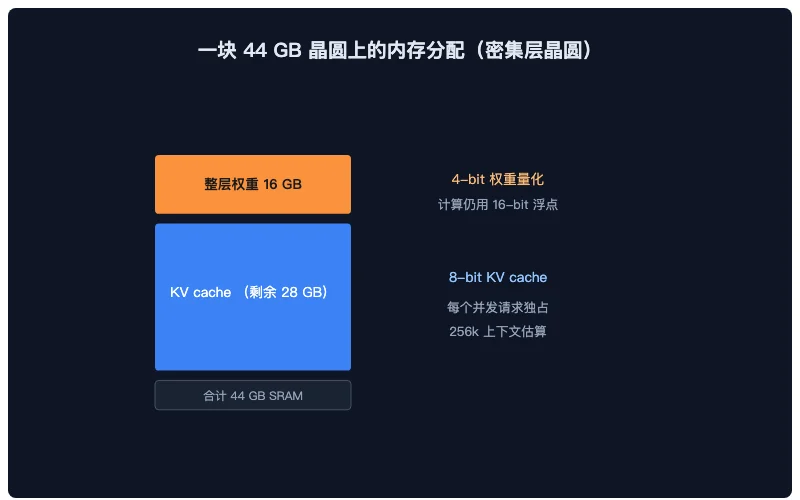
图2:一块全注意力层晶圆的内存分配:16 GB 权重 + 28 GB KV cache,全部在片上 SRAM
权重不搬家,只传激活值
这就是这套架构最不一样的地方。GPU 跑大模型,权重要在 HBM 和 SRAM 之间反复搬,带宽墙是瓶颈。Cerebras 把每一层的权重永久焊死在晶圆上,不动。一个请求进来,token 在 59 块晶圆组成的流水线上走:第 1 块晶圆算完第 1、2 层,把激活值通过 RDMA over Ethernet 发给第 2 块,第 2 块算第 3、4 层,依此类推,最后一块吐出来下一个 token。
每一跳大约 2 微秒。59 块串起来,一个 token 的延迟听起来不短,但流水线是满的——第 3 段在处理请求 A 的 token 时,第 2 段在处理请求 B,第 1 段在接请求 C。每一段还能再开 micro-batch。最终官方给出的吞吐是 1000–2000+ tokens/s。
并发上限由 KV cache 决定。每块全注意力层晶圆上,那 28 GB KV cache 被所有在飞请求瓜分。Cerebras 博客按 256k 上下文、8-bit KV cache 估算了一下能同时塞多少请求。
这条路能不能放大
文章最后说,这套方法是可扩展的:模型再大一块,就再加一块晶圆,权重还是不搬家,只多一段流水线。对照 GPU 路线——大模型要么靠张量并行切分权重(需要 NVLink 高速互联),要么靠流水线并行(需要层间激活传输)。Cerebras 等于把「流水线并行」做到极致:每块晶圆一整层,权重静态驻留,激活走普通以太网 RDMA。
这不是主流路线。主流还是 GPU + HBM。但当开源模型一夜间长到 3 万亿参数、单卡放不下的时候,晶圆级这条路的工程账开始变得能算了。
来源
- Sarah Chieng, How we deploy Trillion-parameter frontier models on Cerebras, Cerebras 官方博客, 2026-10-22
- Kimi K3 开源模型:Terminal-Bench 2.1 88.3% / BrowseComp 91.2%
- Cerebras WSE-3T 规格:44 GB 片上 SRAM,CS-3/CS-4 系统
[关联推荐]
- 1990 年那个被嘲笑的设想,2026 年成了芯片界的新希望 — 另一种被主流押注、但路线一直非主流的芯片思路
- 硅片上的光纤:把光纤的低损耗搬上芯片 — 片上互连带宽的另一种解法
- Apple M6 与 M5 Ultra:2nm 落地,四芯粒封顶 — 主流端侧路线在做什么
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…