10 年前的老 CNN,把 2026 年的前沿大模型比下去了
伦敦皮肤科医生 Magnus Lynch 用 200 个活检皮损测了 GPT-6 Astra 和 Claude Fable 5.1:六选一诊断准确率都只有 42%,而一个 2015 年的 Inception v3、只在单个 H100 上微调约 20 分钟,拿到 62%。
Magnus Lynch 是伦敦盖伊医院的皮肤科顾问医生,也是国王学院的荣誉 Reader。10 月 25 日他在自己的 lab 网站上发了一篇博客:他拿 200 个做过活检的皮肤皮损,去考了 GPT-6 Astra 和 Claude Fable 5.1——两个 2026 年 10 月能拿到的最强多模态大模型——然后又考了一个 2015 年的 Inception v3。
结果是老网络赢。200 个皮损六选一诊断,CNN 对 125 个(62%),GPT-6 Astra 对 84 个(42%),Claude Fable 5.1 对 85 个(42%)。老网络只微调了大约 20 分钟、单个 H100 GPU,用的是 ISIC Archive 上 68011 张皮肤镜和临床图像。
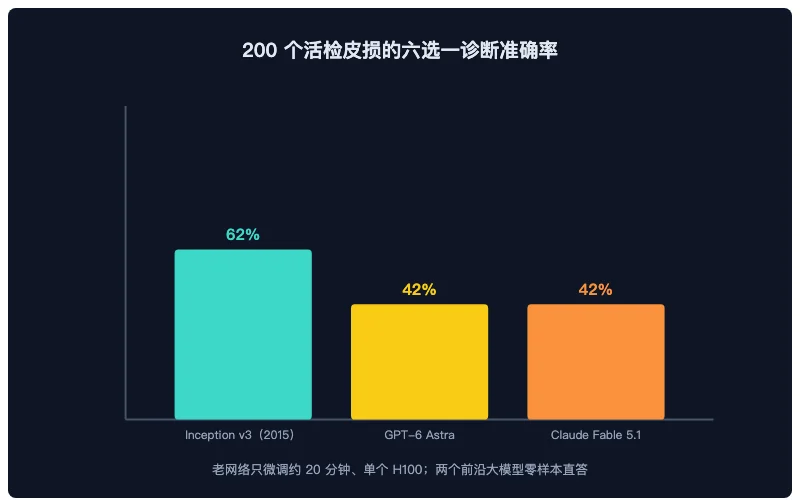
图1:200 个活检皮损的六选一诊断准确率。2015 年的 Inception v3 领先两个前沿大模型 20 个百分点
题目是怎么出的
200 个皮损来自 MILK10k——国际皮肤成像协会 2025 年公开的数据集,每个皮损都拍了两张:一张临床特写,一张皮肤镜下图像。Lynch 随机抽了 200 个,全部经组织病理确诊。其中 100 个是「不该放走」的:30 个黑色素瘤、25 个基底细胞癌、25 个鳞状细胞癌、20 个光化性角化;另外 100 个是「可以放走」的:50 个良性痣、50 个脂溢性角化。
关键在于:这 200 个全做过活检。换句话说,连良性痣都是医生觉得可疑、切下来化验过的——比普通门诊里的图像难。Lynch 把两张图直接喂给两个大模型,让它们从六个诊断里挑一个最可能的、给置信度、给第二个备选,再判断「这个病人能不能直接放走、不做活检不随访」。两个模型都用默认设置,都没拒答。
大模型错得很有规律
整体差距之外,更有意思的是错误模式。GPT-6 Astra 在 200 个皮损里把 75 个判成了基底细胞癌——但真正的基底细胞癌只有 25 个。其中包括 30 个黑色素瘤里的 14 个。Claude Fable 5.1 则把 53 个判成了光化性角化,真实的只有 20 个。每个大模型都有自己的「偏好答案」。
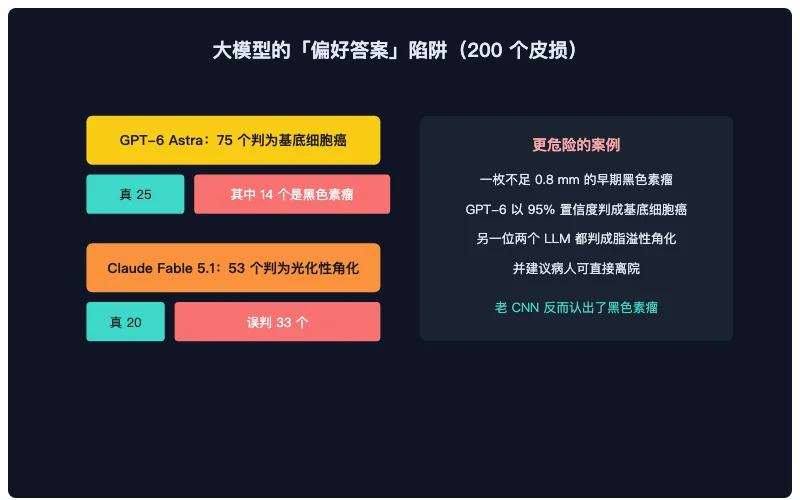
图2:GPT-6 Astra 把 14 个黑色素瘤误判成基底细胞癌;一例早期黑色素瘤被它以 95% 置信度判为 BCC
博客里有个让人不舒服的案例:一个不足 0.8 mm 厚的浸润性黑色素瘤,长在耳朵上。GPT-6 Astra 以 95% 的置信度判成基底细胞癌。另一个更早期的黑色素瘤,两个大模型都判成了脂溢性角化——一种无害的疣状增生——并建议病人可以离院。反而是那个老 CNN,两个都认成了黑色素瘤。
分病种看:黑色素瘤一选命中率,CNN 13/30,Claude 11/30,GPT-6 只有 8/30。基底细胞癌上 GPT-6 倒是全对(25/25),这也是它「偏爱 BCC」的来源。良性皮损上差距更大:良性痣 CNN 认出 37/50,GPT-6 只认出 16/50。
必须泼的冷水
Lynch 自己在文末列了一串 caveat,写得很诚实。200 个样本够看出模式,但不够给两个大模型排名次;30 个黑色素瘤样本量太小,不确定性很大。每个大模型只跑了一次,多次跑结果会变。MILK10k 是 2025 年公开的,大模型训练时可能见过——这一点上对大模型其实有利,对 CNN 不利。最关键的一条:Inception v3 不是 SOTA,真正受监管的皮肤癌 AI 产品用的是图像 Transformer 集成,效果比这个老网络好得多。
还有一个被很多人忽略的细节。如果按 CNN 自己预设的阈值做「放走 / 不放走」决策,它会错误放走 18 个黑色素瘤——比两个大模型(3 个、4 个)还危险。把阈值和大模型对齐之后,CNN 的放走数才降到 2 个或 1 个。所以这个故事不是「老 CNN 天下无敌」,而是:一个为皮肤图像专门训过的小网络,在诊断命名这件事上,比一个什么都见过的通用大模型靠谱;但在医疗决策的另一端(要不要放走病人),光靠准确率不够,还得看阈值和决策曲线。
附:Lynch 把所有病例、prompt、大模型回复和评分代码打包公开了,那个 CNN 小到可以直接在手机浏览器里用 WebGPU 跑。
来源
- Dr. Magnus Lynch, A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis, https://lynchlab.net/llm-skin-cancer, 2026-10-25
- MILK10k 数据集(International Skin Imaging Collaboration, 2025),CC BY-NC
- Inception v3 原始论文:Szegedy et al., 2015
[关联推荐]
- 为什么 AI 医疗榜单第一,到了真实病人身上就翻车 — 榜单表现和临床表现之间那道鸿沟
- 给细胞做一门通用语言:1.12 亿个细胞训出的基础模型 — 生物医学里的「大模型 vs 专用小模型」路线之争
- AI 开始读 30 亿字母「天书」:基因组语言模型 GPN-Star — 另一个大模型闯进专业领域的案例
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…