神经网络到底可不可解释?2026 年的争论有了新证据:干净的神经元可能比想象中多
叠加假说认为神经元概念被"任意打包"导致不可读。但 2026 年多项工作给出更细致的图景:统一理论框架 + 一份直言"重建好不等于解释对"的综述——可解释性既没那么悲观,也没那么乐观。
大模型是个黑箱吗?这个问题在 2022 年被 Anthropic 的叠加假说(superposition)推向了悲观的极端:维度不够用时,网络把比神经元数量还多的特征挤进同一空间,单个神经元于是对应多个不相关概念——既然如此,逐个读神经元自然读不出所以然。
2026 年,这个叙事正在被两边同时修正。
一边是理论上的收束。《自然·机器智能》发表的一篇框架性论文,把可解释性研究的三条线索缝在一起:可识别性理论证明分类训练的网络能恢复潜在特征(差一个线性混合)、压缩感知给"从混合中解出稀疏特征"提供保证、基于行为任务的指标检验解出的特征是否真与人类概念对齐。换句话说,叠加不再只是个现象描述,它开始有了可证明的结构。
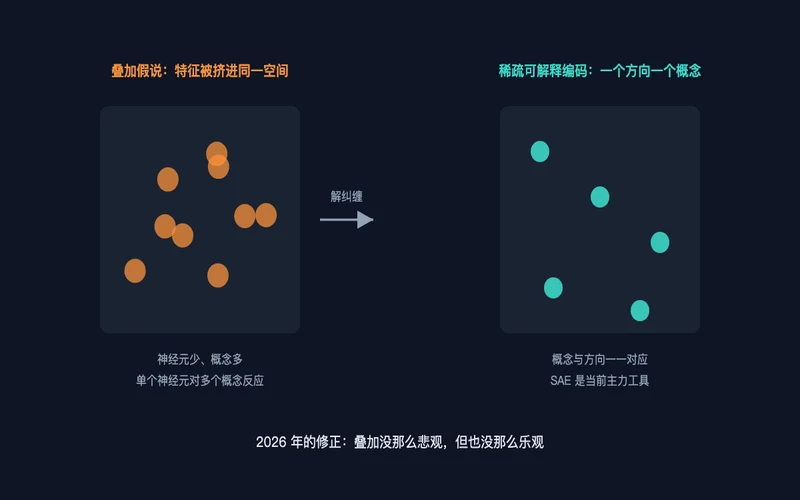
图1:叠加假说与稀疏可解释编码的对照
另一边是方法论上的泼冷水。一篇 2026 年的综述把稀疏自编码器(SAE)——目前最流行的可解释性工具——的老底揭了一圈:能高保真重建网络的激活,并不等于找到了网络真正使用的特征。最扎眼的证据是,把字典方向随机化并冻结,在多个标准指标上也能逼近完全训练好的 SAE。指标好,不代表解释对。
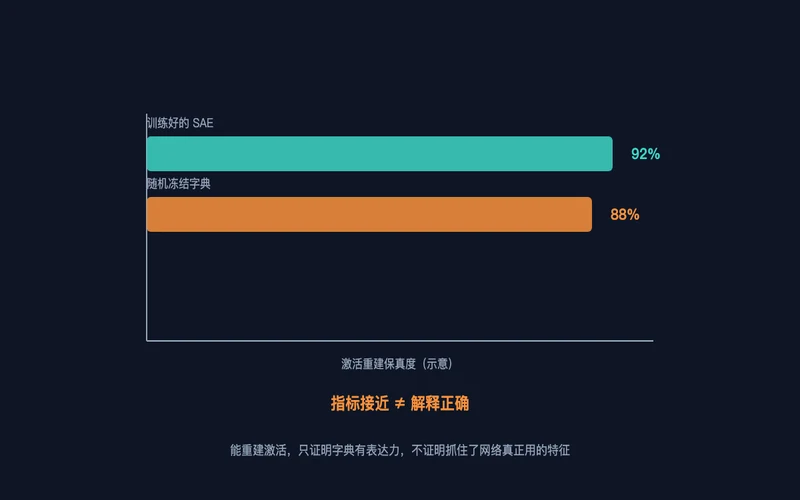
图2:重建陷阱——随机冻结字典的指标接近训练好的 SAE
综述还拆了几个流传甚广的直觉。比如"多义就等于叠加"——一个神经元对多个概念有反应,有时只是坐标系旋转或容量富余,不一定是特征被挤在一起。再比如训练目标本身会制造假象:稀疏惩罚会把一个真实特征拆成几个上下文相关的"子特征",或者让父特征被子特征"吸收"后沉默。
ICML 2026 上另一篇论文则从反方向提供了证据:增加神经元数量(不增加非零参数),让特征之间的干扰下降,准确率反而上升,且提升幅度与"叠加负荷"正相关。如果特征真被任意打包,单纯加宽不该这么灵光——这支持"多数特征其实可读,拥挤才是问题"的中间立场。
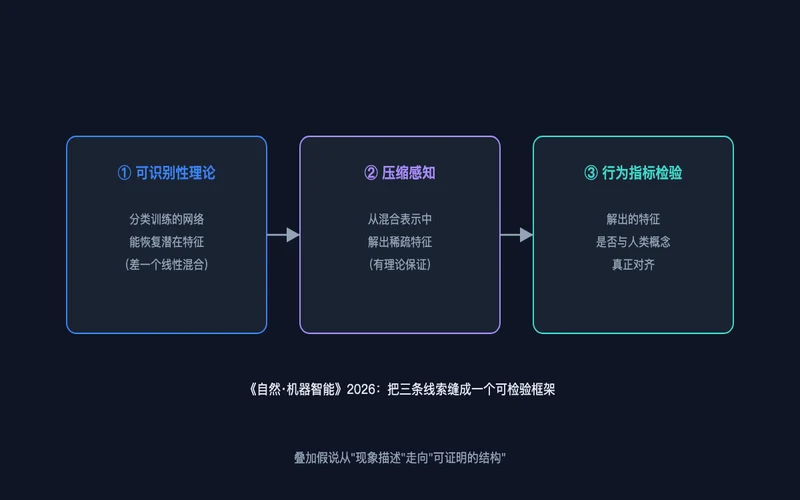
图3:可解释性研究的三步框架
把三边证据放在一起,2026 年的合理结论大概是:神经网络"本来就是脏的"被夸大了,多数神经元比叠加假说暗示的更可读;但"可解释性即将完工"同样是幻觉——重建指标与因果角色之间隔着一条还没合上的沟。这个领域终于从站队阶段走进了算账阶段。
关联推荐
- 爱因斯坦的引力,第一次在量子世界被"看见" — 另一个"测量颠覆解释"的领域
- 浅层量子电路在两个问题上胜过 LLM(IBM) — 对比基准本身如何误导人
- 量子纠错界的"黑马"跑通通用门集 — 工程细节如何推翻理论成见
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…