AI 训练范式转移:反向传播之后,零阶扰动训练来了
Q Labs 发布 Dust:不给权重加扰动,而是给每个 token 的激活值加高斯噪声,一次前向相当于并行评估几千个「虚拟个体」。在大算力预算下能逼近甚至超过反向传播,比权重空间进化策略省 10³–10⁴ 倍。
1986 年 Rumelhart 那篇反向传播论文,是后来所有深度学习的地基。四十年来,神经网络的架构、优化器、GPU 硬件,全是围着「前向算损失、反向求梯度」这两件事长出来的。
十月初,Q Labs 发了一篇论文叫 Dust,作者很直接:这是第一个在 Transformer 预训练上能和反向传播掰手腕的零阶(zeroth-order)优化方法。零阶的意思是,它不求梯度,只扰动、看损失变了多少,再反过来估梯度。
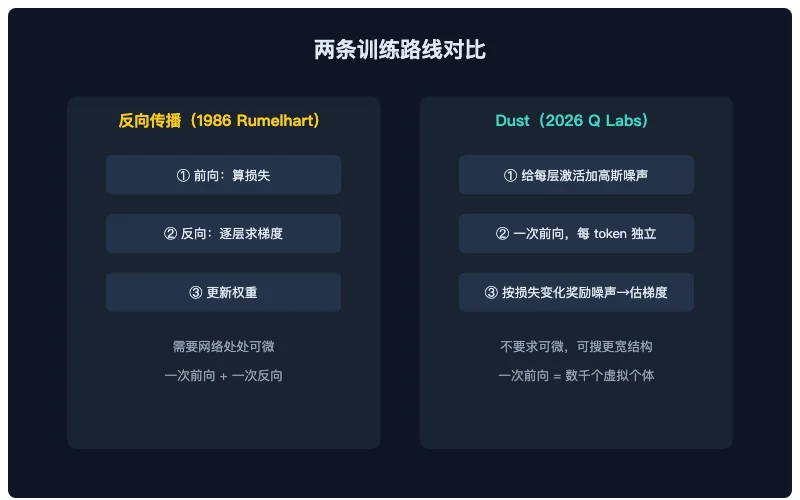
图1:反向传播需要一次前向加一次反向;Dust 用一次前向,每个 token 各算各的扰动
不给权重加噪声,给激活值加
过去三十年大家做零阶优化,都是去扰动权重:复制 N 份带噪声的权重,各跑一次前向,看谁的损失低,再按回报加权平均。这种思路叫进化策略(ES)。问题是 N 份权重就是 N 份显存,N 大不起。
Dust 换了个地方下手:不去动权重,而是在每个线性层的输出激活值上,按 token 独立地加高斯噪声。一个序列有几千个 token,一次前向,等于几千个带扰动的网络变体同时被评估了一遍——作者管这叫「虚拟种群」。每个 token 的噪声被奖励多少,取决于它在当前位置、以及未来若干位置让损失降了多少。奖励加权的噪声平均下来,就是对这一层输出误差的估计,再和这层的输入做外积,就是权重梯度。
整套东西没有任何一步需要网络处处可微。注意力内部用一个变体的信用分配规则,残差混合标量这种小参数还是用普通的权重空间 ES 训。论文原话:算法就这么多,剩下的是工程细节。
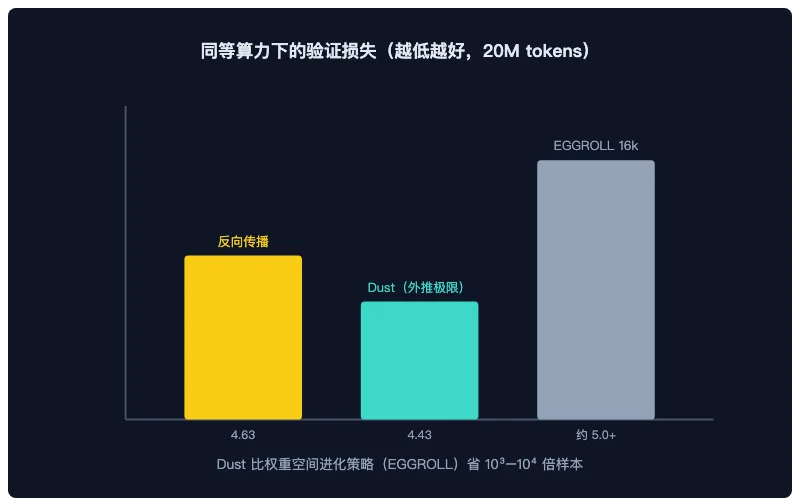
图2:20M tokens 预算下的测试损失(越低越好)。Dust 外推极限已低于反向传播,权重空间 ES 差一大截
大算力预算下,它真的能追上反向传播
作者在 FineWeb 上训 GPT 风格的小模型(8 层、宽度 512),把 token 预算从 10 万扫到 2000 万,种群规模从 64 扫到 16000。结论很直接:10 万 token 和 100 万 token 这两档,Dust 从几百次抽样开始就比反向传播低;1000 万和 2000 万 token 这两档,差距随种群规模扩大而缩小,2000 万 token 那档外推极限落到 4.43,反向传播是 4.63。
和权重空间 ES 比呢?EGGROLL 是目前最先进的权重空间 ES。Dust 比它快 10³ 到 10⁴ 倍——EGGROLL 把种群开到 16000,还是够不上 Dust 只开 64 的水平。反直觉的一点是:模型越大,Dust 的种群效率反而越高。一个 2.43 亿参数的模型,比一个小 120 倍的模型在大多数种群规模下表现更好。
作者自己泼的冷水
论文结尾作者写得很清楚:我们不是来做一个今天就能替换反向传播的算法的。Dust 在大算力预算下才追上反向传播,眼下算力效率远不如反向传播。它真正打开的口子是:从此以后,训练的网络不需要端到端可微了。搜索空间从「可微的网络」扩大到「任何能跑前向的东西」,这对未来的架构设计是个杠杆。
另外一个有意思的暗示:作者观察到 Dust 偶尔在大种群下直接低于反向传播的测试损失。他们猜,这可能是零阶方法在隐式地探测损失曲面的高阶曲率,把搜索往平坦区域拉。机制还没搞清楚,但这是反向传播(纯一阶梯度)天然做不到的事。
来源
- Q Labs, Dust: Pretraining Transformers Without Backpropagation, https://qlabs.sh/research/dust
- 机器之心中文报道:《不用反向传播,也能预训练 Transformer,Jeff Dean 投的这家公司出成果了》,2026-10-26
- Rumelhart, Hinton, Williams (1986):反向传播经典论文
[关联推荐]
- 扩散语言模型来了:英伟达三模式模型让 AI 一次吐出几十个字 — 另一条不走自回归+反向传播老路的语言模型路线
- Mojo 开源:想让 AI 开发者「既要 Python 的简单,又要 C 的速度」 — 训练栈底层的另一波重构
- DeepSeek 把生产级推理引擎也开源了 — 推理侧的工程边界
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…