DeepSeek 把生产级推理引擎也开源了:DeepInfer 里有什么

10 月 20 日,DeepSeek 在 GitHub 开源 DeepInfer——支撑其大规模生产服务的推理框架,Apache 2.0。默认支持 DeepSeek-V4.1-Flash,同时支持 NVIDIA SM100 与华为昇腾 950 NPU,内置 DSpark 投机解码、批不变推理、确定性采样等特性。
DeepInfer,用他们自己的话说,这是"驱动 DeepSeek 大规模生产服务的高性能推理框架",此次开源的是离线推理加规模化服务的核心功能,许可证为 Apache 2.0。默认配的检查点是
deepseek-ai/DeepSeek-V4.1-Flash-1017。
看一个推理框架,先看它支持什么硬件。DeepInfer 同时支持 NVIDIA SM100 GPU(CUDA 13)和华为昇腾 950 NPU(CANN 9.2),后者的 requirements-ascend.txt 单独一份——国产算力进了默认支持列表,而不是补丁。
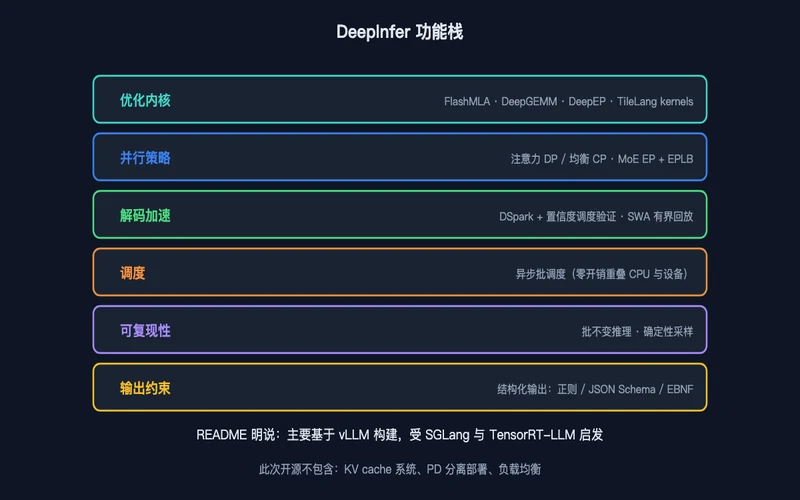
图1:DeepInfer 功能栈——从优化内核到可复现性开关的六层结构
功能清单几乎是近年来推理优化论文的"全家桶":优化内核来自自家的 FlashMLA、DeepGEMM、DeepEP 加上 TileLang kernels;并行策略覆盖注意力数据并行与均衡上下文并行、MoE 专家并行与 EPLB;DSpark 加置信度调度验证用草稿 token 加速解码;滑动窗口注意力(SWA)有界回放减少解码端的 prefill 工作量;异步调度把 CPU 批调度与设备执行重叠;还有两个对工程界很实用的开关——批不变推理(同样输入在不同批组成下结果一致,NVIDIA)和确定性采样(固定随机种子,输出逐 token 可复现)。结构化输出支持正则、JSON schema 与 EBNF 语法约束。
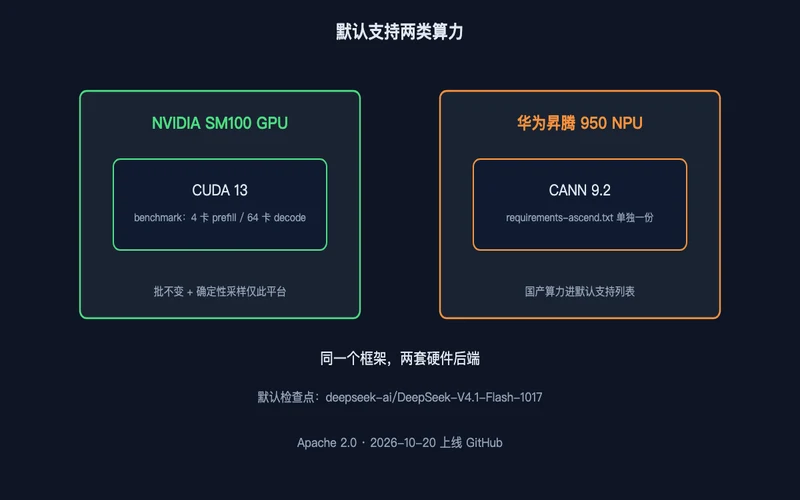
图2:默认支持两类算力——NVIDIA SM100(CUDA 13)与华为昇腾 950 NPU(CANN 9.2)
README 在致谢里写明:DeepInfer 主要基于 vLLM 构建,并受 SGLang 与 TensorRT-LLM 启发。这句话对判断它的定位很重要:它不是又一个从零开始的"玩具框架",而是把生产环境验证过的栈剥离出来开源。同时也坦白了这次发布不包含什么:KV cache 系统、prefill/decode 分离部署、数据并行副本间的负载均衡——一个完整的推理服务还需要这些,得自己补。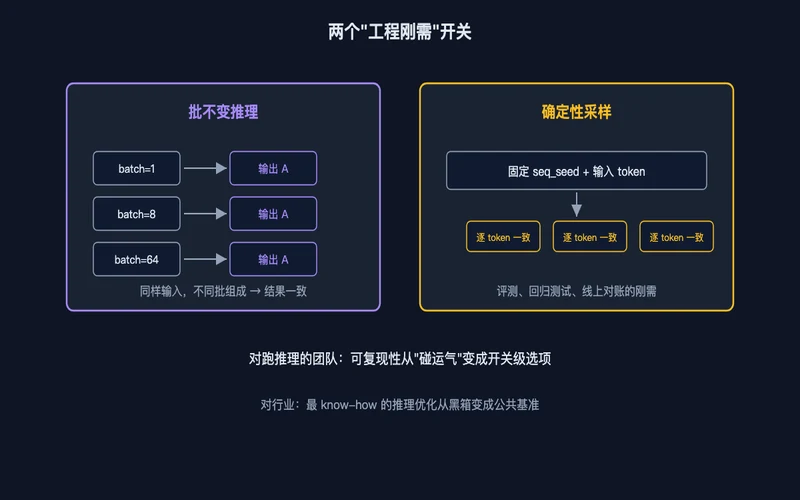
图3:两个工程刚需开关——批不变推理与确定性采样
对跑推理的团队,最直接的吸引力是可复现性:批不变和确定性采样让"同样输入永远得到同样输出"成为开关级的选项,这对评测、回归测试和线上对账都是刚需。对行业,把生产级推理引擎开源,等于把"推理成本优化"这项最依赖经验的工程,从各家黑箱变成了公共基准。 ---
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…