两万一千美元训一个文生图模型,账单摊开看
两人团队 Linum 把一次文生图训练的完整成本公开了:预训练 20,348 美元、后训练 690 美元,合计 21,038 美元,8,415 个 H100 小时按每小时 2.50 美元算。模型 2B,训练了 6.6 亿样本,权重 Apache 2.0。它不会写字,因为带渲染文字的图在数据阶段就被全过滤掉了。透明到这个程度的账单,比数字本身更有用。
先摆钱。Linum 这次训练总共 21,038 美元:预训练 20,348 美元(8,139 个 H100 小时),后训练 690 美元(276 个 H100 小时),一律按每小时 2.50 美元计价,合计 8,415 个 H100 小时,跑在 64 张 H100(8 个节点)上。样本量 6.6 亿:512² 阶段 610.27M(297,985 步),1024² 阶段 49.97M(24,400 步),全局 batch 都是 2048。
发布日是 11 月 4 日,作者 Sahil Chopra 和 Manu Chopra,一个两人的研究实验室。他们把话讲在前面:这是通往下一个视频模型路上的一次压力测试,不是成品。看见 2B 模型出图效果不错,才当成实验性发布放出来。
钱省在哪
架构叫 Pyramid-JiT(P-JiT),直接在像素空间做,把 VAE 整个拿掉。常规做法是先用 VAE 把图压进潜空间再训扩散模型,Linum 的理由是 VAE 的压缩率有经验上限,而且重建指标变好有时反而让下游生成变差。P-JiT 把图像切成 32×32 的 patch 压到 1024 维(3072 → 1024,3:1),token reduction 从上代的 16×16 提到 32×32,注意力上下文因此减到四分之一。文本侧是冻结的 Qwen3.5-4B,读第 7、15、27 层;主干 22 个 DiT 块,采样时 2.18B 参数,训练时多出约 0.24B 的只读头部。
他们自己的说法是,P-JiT 比 Linum v2 少用 11 倍样本收敛。做法上有两处值得记:一是在主干第 10、16 块之后加线性读出头,让网络中间层就预测四分之一、半分辨率的干净图,早期块的梯度信号因此变强;二是噪声日程分两段,前 8000 万样本集中在高噪声学结构,之后把分布铺开学细节。
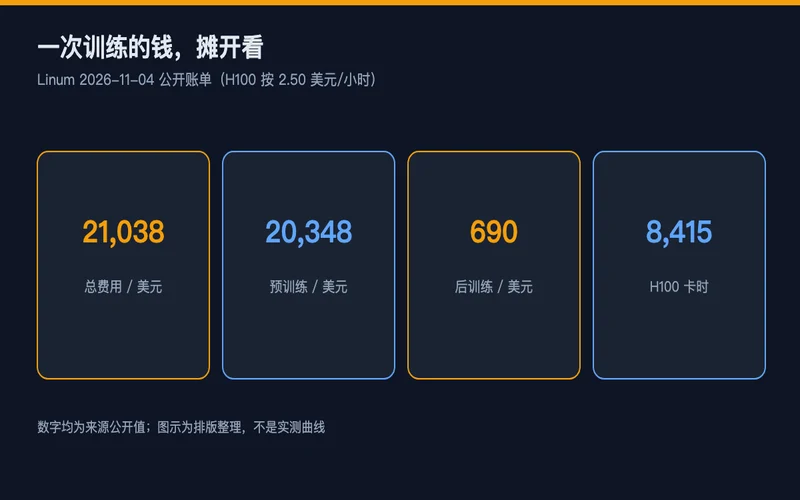
图1:21,038 美元成本的拆账
它不会写字,这是故意的
模型没训过带渲染文字的图——信息图、PDF、书页、PPT 全在数据过滤阶段剔掉了,理由是团队最终要做动画工具,这些数据没用。所以它写不出字,也做不了海报。2B 的体量在全身像、多实体(比如六辆车)、多人互动和世界知识上也吃力,作者明说练个 7B 加后训练大概能缓解。
后训练那段更坦白。他们用 FDFO 的一个变体,配 JEV-Image 和人工评审;同时写「扩散模型的后训练还是门很年轻的学问」,DPO 容易过拟合到特定审美,Flow-GRPO 去年秋天才把 RLVR 式框架带进来。根本原因他们也给了:扩散模型拿不到自回归 LLM 那样强的似然估计。
我看完最在意的不是「两万美元也能训」,这个说法容易误导。64 张 H100 同时跑,按 2.50 美元一小时租,本身就不是随手能凑的条件;而且团队把这次叫 proof-of-concept,目标是视频。真正稀缺的是账单:预训练、后训练、卡时、单价、样本量、步数、batch 全列出来,连重启算进去都写明。多数模型发布只给一个「训练成本」的形容词。有了这张表,别人才算得清自己复现要多少钱。
权重 Apache 2.0,代码在 GitHub,模型卡在 Hugging Face,页面还放了 249 张样本。作者署名声明里写了一句:页面文字都是人写的,Claude Opus 5.5 只帮忙做了图片画廊和示意图,模型卡与仓库文档则是让它从内部实验仓里抽出来整理的。这句话放在一篇讲模型账单的文章末尾,倒挺合适。
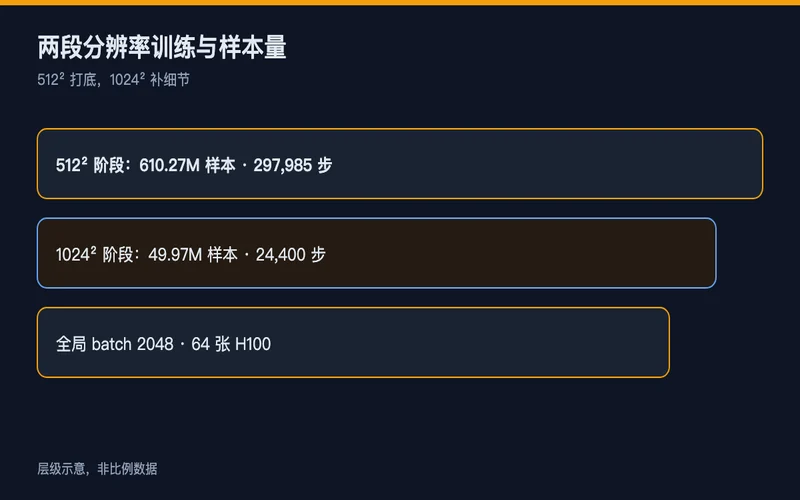
图2:P-JiT 的两阶段分辨率训练与样本量
核心信息来源
Linum, Training a Text-to-Image Model for $21K(linum.ai/field-notes/pjit-21k,2026-11-04):提供 20,348/690/21,038 美元、8,139/276/8,415 H100 小时与 2.50 美元单价、610.27M+49.97M 样本与步数、64×H100、2048 batch、2.18B/2.42B 参数、Qwen3.5-4B 与第 7/15/27 层、32×32 patch 与 1024 维、11 倍收敛、噪声日程 8000 万样本、FDFO 与 JEV-Image、模型局限清单、Apache 2.0 与署名声明。Hacker News 首页(2026-11-06,Show HN 条目 256 点):提供当日热度。文中「两万美元也能训」的辨析与「账单透明才是稀缺项」的判断:本文自述,不是官方口径。
关联推荐
- 3B 模型逆袭 Opus 4.5 + 国产 744B 开源 — 小模型路线在语言侧的对照
- 扩散语言模型来了 — 扩散范式跨到语言之后的取舍
- 为什么 AI 医疗评测不能只看榜单 — 只看一个总分,容易漏掉成本与适用范围
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…