乔姆斯基说这不算科学,Norvig 回了一封长信
2011 年 MIT 的一场研讨会上,乔姆斯基把统计语言模型的成功称为「逼近一堆没分析过的数据」。Norvig 随后写了篇长文,用平滑、语料实验和一张几乎全是 100% 的工程清单逐条反驳。十五年后,大模型把「拟合得好算不算解释」这个问题原样送了回来。今天这篇文章又出现在 Hacker News 首页。
「把成功理解成逼近一堆没分析过的数据。」2011 年 MIT 150 周年的 Brains, Minds and Machines 研讨会上,乔姆斯基被问到概率模型,给了这么一句。他不是随口一说。此前几十年他反复讲:语言学要找的是解释性原则,收集事实是「采蝴蝶」;一个带几十亿参数、谁也读不懂的模型,就算能干活,也算不上科学。
Peter Norvig 后来写了篇长文回他,标题叫 Chomsky and the Two Cultures of Statistical Learning。今天这篇文章挂在 Hacker News 首页,二十几点,讨论不多。十五年过去再看,里头的火药味淡了,问题还在。
先把词掰清楚
Norvig 下手的第一件事是拆概念。统计模型是从数据里训出来的,概率模型给的是分布而不是确定关系,训练模型是用学习算法从一族模型里挑一个——这三件事被乔姆斯基混在一起批了。牛顿引力公式里那个 也是靠实验数据做统计推断估出来的,但没人会说万有引力是「统计模型」。真正让乔姆斯基不舒服的,是香农那种十万词表、二阶马尔可夫要存 $10^{15}$ 个概率值的东西。
他借了 Leo Breiman 2001 年的框:一拨人相信黑箱背后有个简洁可理解的模型,先定形式再估参数(Breiman 估计占统计学家 98%);另一拨人不管形式,只要求算法对没见过的数据预测得准(2%)。乔姆斯基反对的是后一拨,而且相当彻底:把语言使用(performance)整个划出语言学,只留语言能力(competence)。
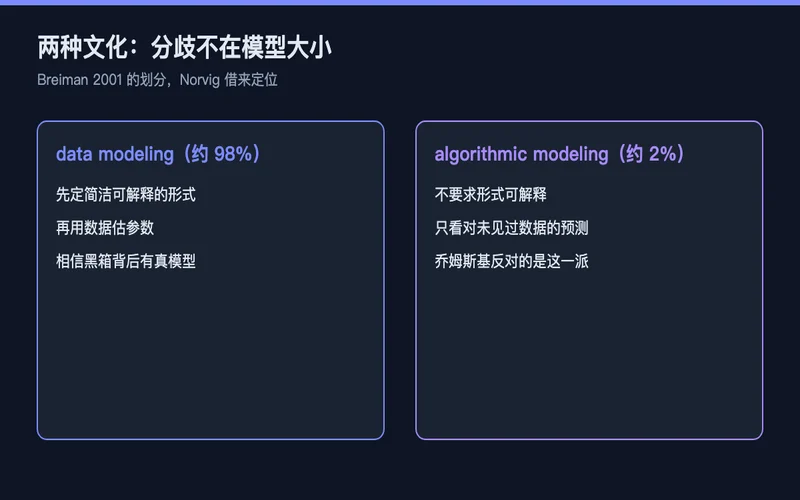
图1:两种文化的分歧点与各自更看重的东西
那句最硬的反驳,其实有个技术漏洞
乔姆斯基 1969 年说过,「句子的概率」在任何已知解释下都是个没用的概念。理由是新句子不断出现,而新句子的概率只能是零。Norvig 的回答很短:平滑。给未见组合留一点概率质量,是概率建模的标准动作,不是补丁。
他还真去算了那句著名的「colorless green ideas sleep furiously」。乔姆斯基拿它证明语法性不能靠经验:这句和它的乱序版本都没在经验里出现过,人却能分出哪句合语法。Pereira 2001 年用一个统计有限状态模型算出前者比后者概率高 20 万倍;Norvig 自己用更糙的模型、在 Google Books 1800–1954 语料上算,约 1 万倍。两个数字差得多,但方向一致,而且概率模型还能额外说出「两句都极不可能」,这是二值语法判断给不了的。
一张几乎全是 100% 的清单
Norvig 列工程证据时没客气:2011 年主流搜索引擎、主流语音识别系统,训练式概率方法占 100%;NIST 机器翻译评测的头部参赛者 100% 用统计方法;SemEval-2 词义消歧的头部系统 100%;覆盖 4000 个语言对的翻译系统里,除日英方向外统计系统都明显最好。他还补了一句自述:自己花了约 14 年用逻辑规则做语言模型,后来转向概率方法,周围没见人往反方向走。
这张清单证明的是「有东西在正常工作」,Norvig 自己写明它不是科学证明。这句话现在读起来比 2011 年更刺眼。模型规模早就越过乔姆斯基当年拿来当反例的 $10^9$ 参数,可解释性、数据污染、榜单与独立验证集之间的落差,一样一样又摆回桌上。
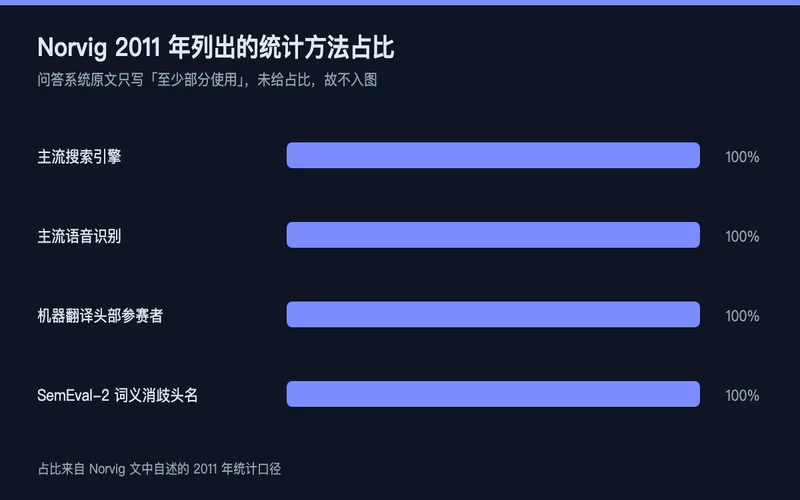
图2:Norvig 2011 年列出的统计方法占比
我不同意「谁赢了」这个说法
Norvig 文末写,语言是复杂、随机、受演化与文化变迁摆布的生物过程,因此只能用概率模型分析。他引 Sapir 1921 年的那句 All grammars leak,说语法性本来就不是二值的。这些我都认。但把「准确建模世界」直接等同于科学,跳得也快了点。他自己抽查《Science》当期 15 篇、《Cell》当期 8 篇,判定 100% 更偏准确建模而非提供洞见,紧接着承认这判断「难以界定」且可能有偏见。
文章最后一句是:这在数学上也许很有意思,但它没抓住语言是什么、以及语言怎么工作。2026 年最会拟合语言的那些系统,恰好也没回答后半个问题。争论没有结束,只是换了场地。
核心信息来源
Peter Norvig, Chomsky and the Two Cultures of Statistical Learning(norvig.com/chomsky.html;文中内证:2011 年 MIT 研讨会、IBM Watson 赢 Jeopardy、2011 年《Science》当期):提供乔姆斯基 2011/1969/1957 原话、Breiman 98%/2% 估计、$10^{15}$ 参数规模、Pereira 2001 的 20 万倍与作者自算的 1 万倍、搜索引擎/语音识别/机器翻译/词义消歧的 100% 占比、4000 语言对、14 年自述、《Science》15 篇与《Cell》8 篇的抽样判断。Leo Breiman, Statistical Modeling: The Two Cultures(2001):两种文化的划分。本文观点与「争论没有结束」的判断:本文自述,不是来源结论。
关联推荐
- 为什么 AI 医疗评测不能只看榜单 — 独立验证集与过拟合,同一个评估问题换了个科室
- 扩散语言模型来了 — 生成方式变了,概率建模的底子还在
- Claude 用 11 天把费马大定理做成机器可校验的证明 — 另一条「机器给出的答案要怎么验」的路
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…