你的气味在泄密:狗能闻出癌症,仪器还在追
从一位护士闻出丈夫的帕金森说起,讲清体味诊断的分子机制、犬嗅与电子鼻的真实战绩,包括一次特异度只有 27% 的翻车,以及为什么 91.3% 的特异度放进真实人群依然不够。
早些年《柳叶刀》登过一则短病例:一位女士腿上有块皮肤,被自家狗反复嗅、反复拱,持续了好几个月,她才去医院看。切下来一查,是黑色素瘤,还很薄,切干净就没事了。
这类故事在诊室里当趣闻传了几十年。真正让科学界坐不住的,是另一个版本:一位从来没受过任何训练的退休护士,在丈夫确诊之前好几年,就闻出他身上多了一种「麝香味的、油腻的」味道。
一、一个护士当众问了个怪问题
她叫 Joy Milne,住在苏格兰珀斯,退休前是护士。她的丈夫 Les 在 1986 年被诊断为帕金森病,从确诊到去世,一共病了 21 年。
2012 年,她去参加帕金森英国协会的一场活动。台上是爱丁堡大学的神经科学家 Tilo Kunath,讲的是帕金森病的生物学。讲完提问环节,Milne 站起来问了一句:帕金森病人身上是不是有一种特别的味道?
Kunath 当时的反应是「这什么鬼问题」。他把这事搁了半年,后来还是决定试一试。他们找了 12 件志愿者穿过的 T 恤,6 件来自帕金森病患者,6 件来自健康人,让 Milne 只靠闻来分。
结果她全部分对。而且她还指出,其中一件「健康人」的 T 恤,闻起来是病人的味道。那件衣服的主人不到一年后就确诊了。
这件事的性质从这里变了:不再是「某个人的鼻子很神」,而是一个可以被追问的问题——她闻到的到底是什么分子?那味道为什么能提前于症状出现?
二、气味不是玄学:身体每天在往外漏分子
要把这事讲清楚,得先接受一个前提:人是有气味的物体,而且是持续挥发的。皮肤、呼吸、尿液、汗液里,随时都在往外带分子。
能被鼻子或仪器捕捉到的这类分子,统称volatile organic compounds,缩写 VOC。它们的共同点是小、易挥发、脂溶性好,能穿过细胞膜进到血液,再经肺、皮肤或肾排出去。
病是怎么改变这套输出的?至少三条路,而且都能落到具体分子上。
第一条是氧化。细胞膜上的多不饱和脂肪酸被氧化时会断链,断出来的碎片是烷烃、醛和酮。肺癌病人呼气里那组著名的「戊烷、甲基烷烃升高」,走的就是这条路。氧化应激越重,这些碎片越多。
第二条是皮脂和皮肤菌。帕金森病有一个常被忽略的非运动症状:皮脂溢出。脸上油、头皮屑多,往往比手抖早出现很多年。皮脂一多,靠皮脂吃饭的马拉色菌(一种皮肤常驻酵母)就跟着繁荣,它的脂肪酶把皮脂分解成脂肪酸和更小的挥发物。这一步解释了为什么帕金森的味道出现在后背和额头,而不是腋下。
第三条是代谢与菌群的重排。肿瘤细胞的代谢路线和正常细胞不一样,肝脏里那套解毒酶(细胞色素 P450 家族)会被药物和病理状态诱导,肠道菌发酵产生的短链脂肪酸、胺、硫化物也会变。糖尿病人的丙酮味、肾功能不全者的鱼腥味(三甲胺),都属于这一类,是临床上早被记录的现象。
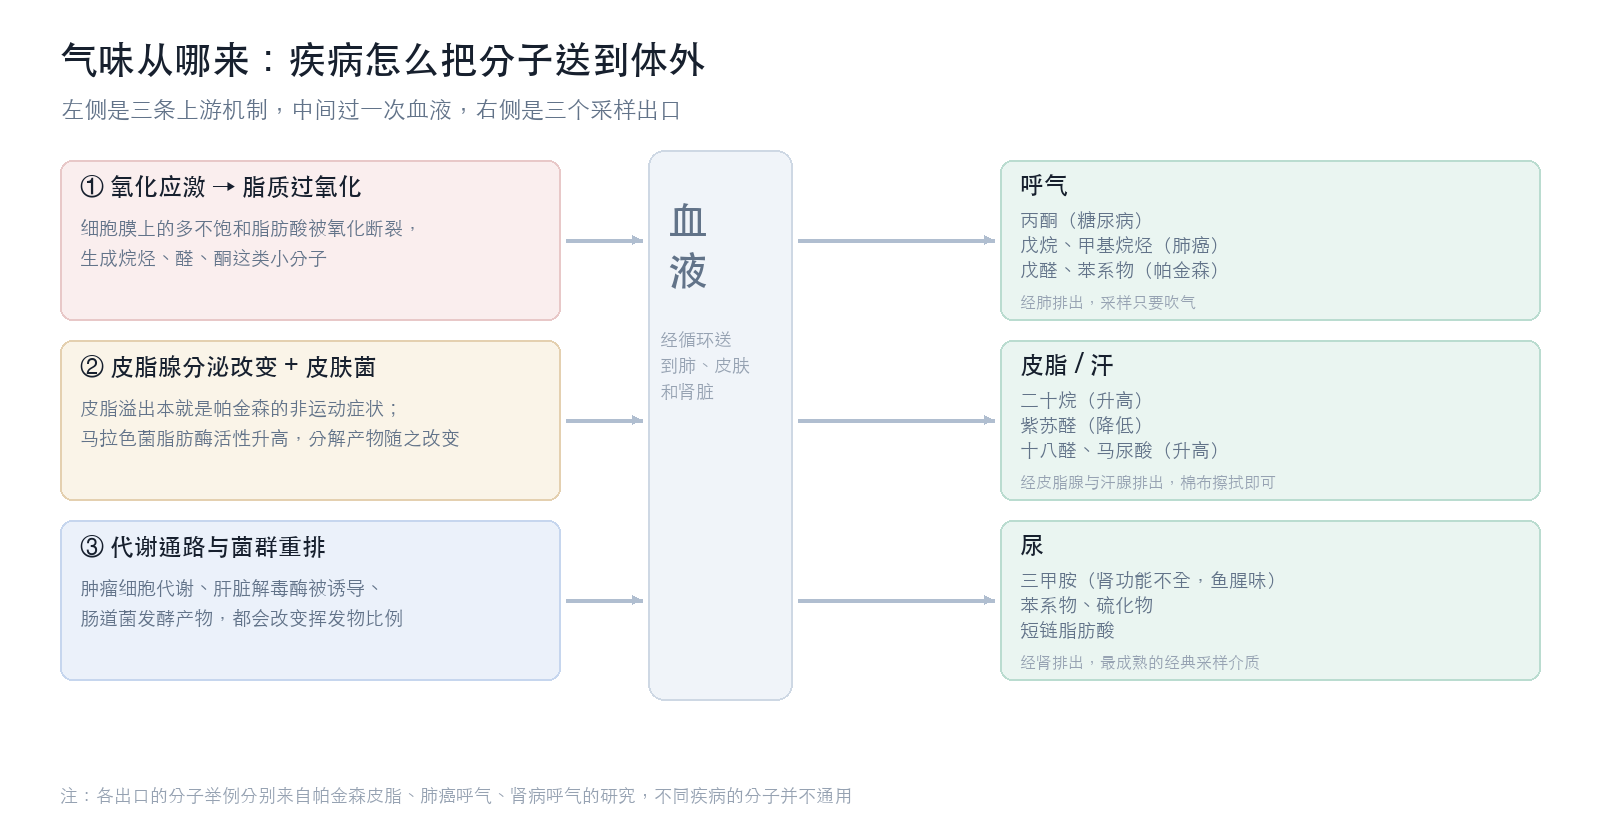
图 1|三条上游机制,三个采样出口;各出口旁的分子都是文献里被量到过的具体物质
三、狗凭什么闻得到
人闻不到这些,是因为灵敏度差得太远。数量上先有个直观感受:狗有大约 3 亿个嗅觉受体,人有 600 万左右,差 50 倍。更关键的是结构差异——狗可以一边用鼻孔中央吸气,一边从两侧的窄缝呼气,气流不打架,等于连续采样;鼻腔里的鼻甲把气流分成嗅觉通道和呼吸通道,气味分子被专门送进嗅觉上皮。
阈值上的差距更夸张。有综述给出的对比是:电子鼻的检出下限在十亿分之一(ppb,10⁻⁹)量级,而犬的嗅觉阈值可以低到万亿分之一(ppt,10⁻¹²)以下。也就是说,同一份样本,狗能闻到的浓度,仪器可能还差五个数量级。
这解释了为什么这个领域的第一步不是造仪器,而是先借狗和「超嗅觉者」当探测器。人的鼻子和狗的鼻子在这里是科研工具,是活体气相色谱。
四、把一个鼻子翻译成分子清单
2019 年,曼彻斯特大学的 Perdita Barran 团队在《ACS Central Science》上发了第一篇把这事钉到分子层面的研究。Joy Milne 是共同作者之一。
他们的设计很巧:用纱布擦受试者上背部的皮脂,一共 64 人(43 位帕金森病患者、21 位对照),另找一批完全独立的 31 人做验证。样本进gas chromatography–mass spectrometry,缩写 GC-MS。同时,让 Milne 坐在仪器的嗅闻口旁边——色谱柱把混合物一点点分开,她在出口实时闻,闻到「很浓的麝香味」就报时。
把「她报时的时刻」和「色谱峰出现的位置」叠在一起,19 到 21 分钟那段窗口对上了。那里有三个分子:二十烷(eicosane)、十八醛(octadecanal)、马尿酸,都在病人样本里升高;另有一个紫苏醛(perillic aldehyde)是降低的。
2020 年他们把这套方法扩到 129 人(100 位患者、29 位对照),得出了一个更耐人寻味的结果:那些差异信号,更像脂质降解出来的碳氢碎片,而不是某个完整的特征分子。换句话说,气味不是一个「疾病分子」,而是一整套脂类代谢与皮肤微生态被改写之后的产物。
到这一步,问题是清楚的:如果要把它做成检测,需要一台能重复、能标定的机器,而不是一位超嗅觉者。
2022 年,浙江大学陈星团队在《ACS Omega》上给出了第一台原型机:气相色谱加声表面波传感器,再套一层机器学习。训练用了 31 位患者和 32 位对照,测试用另外 12 对。结果准确率 70.8%,灵敏度 91.7%,特异度 50%。
这三个数字要拆开看。灵敏度 91.7% 意味着病人基本都能被抓到;特异度 50% 意味着健康人里有一半被误判成有病。这个模型当时更像一个「筛不掉病人、但会吓到一半健康人」的装置。
2025 年,同一支团队联合浙大一院和之江实验室,在《Analytical Chemistry》上换了个采样部位:不擦后背,改擦外耳道。理由很实在——后背的皮脂受洗澡、季节、出汗影响太大,同一个人夏天和冬天的样本能差出结果;耳道分泌物稳定得多,一根棉签就能取,还不用专业医生操作。
这次是 108 位患者对 101 位对照,锁定 4 个挥发物(乙苯、4-乙基甲苯、戊醛,以及一个长链的二氧戊环类化合物),准确率 94%。他们同时用了 GC-MS 和一台主机大小的气相色谱-声表面波设备(SAW),后者才是能进门诊的那台。
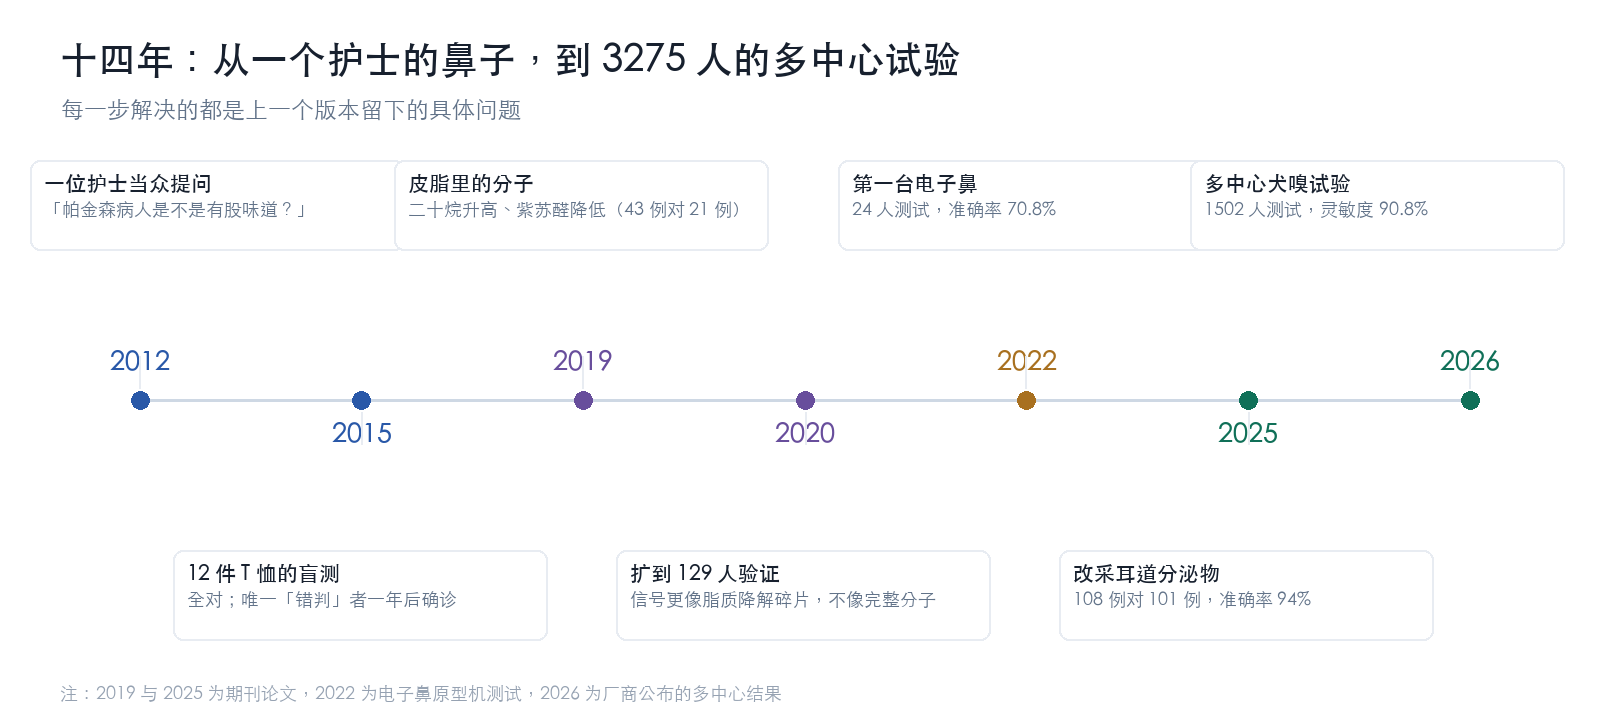
图 2|十四年里,每一次进步都在补上一次的具体短板:分子、机制、设备、采样部位
五、翻车的那一次:特异度只有 27%
顺着「狗很准」的叙事走下去,很容易忽略反例。2025 年一项乳腺癌的前瞻试验就翻了车,而且翻得很有教学价值。
研究纳入 181 位要做穿刺的受试者,107 位是乳腺癌(82 例浸润性、25 例原位),74 位是良性病变。取样方式是术前一夜在患侧乳房贴一块敷料,第二天给两只受训犬闻。
结果:随机选一只犬,灵敏度 68%、特异度 27%。换判定规则,只要有一只犬标记就算阳性,灵敏度升到 80.4%,特异度掉到 21.6%;要两只犬都标记才算阳性,则 48.6% / 45.9%。
特异度 27% 是什么概念:74 位良性病变的人里,大约 54 位会被标成「疑似恶性」。
为什么会这样?研究者自己点出了关键:训练时用的是「癌症病人 vs 健康人」,测试时面对的却是「恶性 vs 良性」。这两个任务不一样。良性病变的组织也在重建、也有炎症、也有代谢改变,气味谱并不是「健康」那一档。这种「训练集和测试集换了对手」的问题是筛查研究里最常见的坑。
六、2026:3275 人的多中心试验,和它还没证明的事
2026 年 4 月,《临床肿瘤学杂志》刊出一项规模大得多的研究,牵头方是一家专做犬嗅检测的公司。7 种癌、6 家医院、入组 3275 人。
流程简单到有点土:受试者对着一个外科口罩正常呼吸 10 分钟,口罩封存送检,7 只犬在一个八通道平台上闻。每份样本至少 3 只犬独立给出「有/无」,再用一个贝叶斯模型按每只犬的历史灵敏度和特异度加权融合,还叠加了受试者本人的临床风险因素。
在 1502 位犬从未见过的受试者上测试:灵敏度 90.8%,特异度 91.3%,AUC 0.962。拆开看,单靠犬的 AUC 是 0.932,单靠临床风险因素的模型是 0.832,融合之后才到 0.962。早期(I、II 期)病人的灵敏度 90.6%,和晚期差不多。
这些数字比上一代好看太多。但要看清它证明了什么:这属于「分析有效性」——在受控条件下,这套系统确实能把有癌和没癌分开。它还没证明「临床效用」:把无症状的普通人扔进去筛,能不能真的让人活得更久、少花钱。厂商接下来的计划是先在高风险人群里做前瞻,2027 年才在一个城市落地。
七、算一遍筛查的账
特异度 91.3% 听起来很高。放进真实人群里算一遍,会看到完全不同的一面。
阳性预测值(PPV)的意思是:结果阳性的人里,真正有病的比例。它不只取决于检测本身,还取决于被筛的人里到底有多少病人:
其中 Se 是灵敏度,Sp 是特异度,p 是这件事在被筛人群里的真实患病率。三个量里,前两个由检测本身决定,第三个由你把它用在谁身上决定。
拿 10 万人举例。假设患病率 1%(也就是 1000 个病人),灵敏度 90.8% 能抓到 908 个,漏 92 个。剩下 99000 个健康人,按特异度 91.3% 算,会有 8613 人被误判成阳性。总共 9521 个「阳性」,其中真的只有 908 个——9.5%。
同样的检出能力,如果特异度提到 99%:假阳性从 8613 降到 990,阳性总数 1898,真病人 908,PPV 变成 47.8%。
| 被筛人群的患病率 | 特异度 91.3% 时,阳性里真患病的比例 | 特异度 99% 时 |
|---|---|---|
| 0.1% | 1.0% | 8.3% |
| 0.5% | 5.0% | 31.3% |
| 1% | 9.5% | 47.8% |
| 5% | 35.5% | 82.7% |
| 10% | 53.7% | 91.0% |
| 30% | 81.7% | 97.5% |
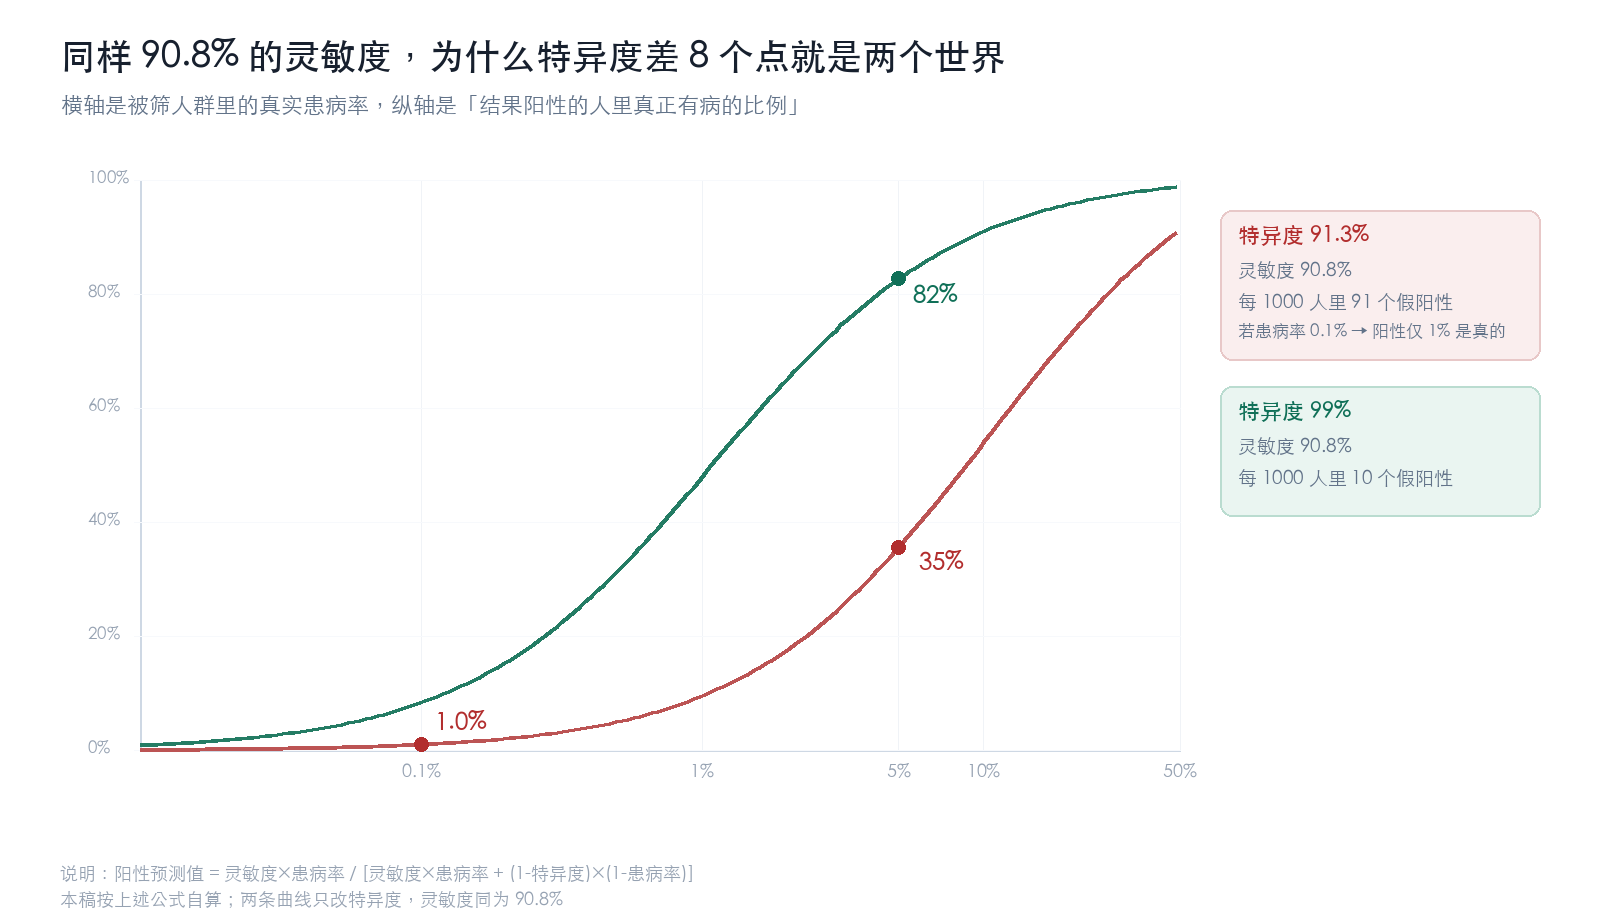
图 3|灵敏度相同,只改特异度:左边红线是 91.3%,右边绿线是 99%;横轴越往左,被筛人群越健康
这张表也解释了研究者的口径为什么一致:不管狗多准,他们都把它定位成「分诊」,而不是诊断。先用便宜的初筛把高风险的人挑出来,再让人去做 CT、活检这些又贵又有创的检查。在医疗资源紧张的地方,这个位置是有意义的;把它当成「闻一闻就知道有没有癌」,就会出事。
从这张表还能反过来读出一个判断:任何筛查工具的价值,都取决于它被放在什么人身上用。同样的设备,放在有症状的门诊人群里(患病率可能 10% 以上),阳性结果的可信度能到 50% 以上;放在随机健康人群里,阳性结果九成是虚惊。
八、结论:气味是真的,但「闻得出」离「能筛查」还差三道关
把这十四年捋一遍,能得到一个不那么刺激但更靠得住的结论:疾病确实会改变人排出的挥发物,这件事已经被分子层面证实了,机制也讲得通。但这套信号要变成临床工具,卡在三件事上。
采样标准化。同一块皮肤,洗澡前后、夏天冬天、有没有用化妆品,挥发谱都不一样。耳道采样之所以比后背好,就是因为它更少受这些干扰。谁先把采样流程钉死(采样位置、时间、容器、保存温度),谁才有可能做出可重复的产品。
特异度。灵敏度堆到 90% 不难,难的是在不动灵敏度的情况下把特异度推到 99%。这一步决定了筛查在低患病率人群里到底是帮忙还是添乱。
真实人群的前瞻验证。目前几乎所有漂亮数字都来自「已知有病 vs 已知没病」的对照设计。真正要回答的问题是:在还没确诊、甚至还没症状的人身上,它能不能提前发现,且不制造大量焦虑。
对普通人来说,这几条都有实际含义。别指望靠闻一闻、或者靠自家狗的反应来给自己下诊断;狗对着某个部位反复嗅,值得留意,但它不是诊断依据。反过来,如果你的体味在短期内明显改变,尤其是伴随体重下降、盗汗、持续低烧,那确实该去医院,只是要查的是身体,而不是研究气味。
至于那个最初的问题——狗能闻出癌症吗?能,在受控条件下,而且不止一种癌。它闻到的不是「癌症的味道」,是细胞代谢和免疫状态被改写之后,一整套分子比例的偏移。人类现在做的事,是把这套偏移翻译成仪器读得懂的数字。翻译已经开始了,只是还没翻译完。
关联阅读:体检查出阳性,真得病的概率有多大?(同样的筛查算术,换成体检场景)|多巴胺简史:从「快乐分子」的误读到它真正做的事|帕金森病的大脑里,藏着一个 20–35 赫兹的「疗效开关」
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…