不用试词表了:把大模型改成直接读字节
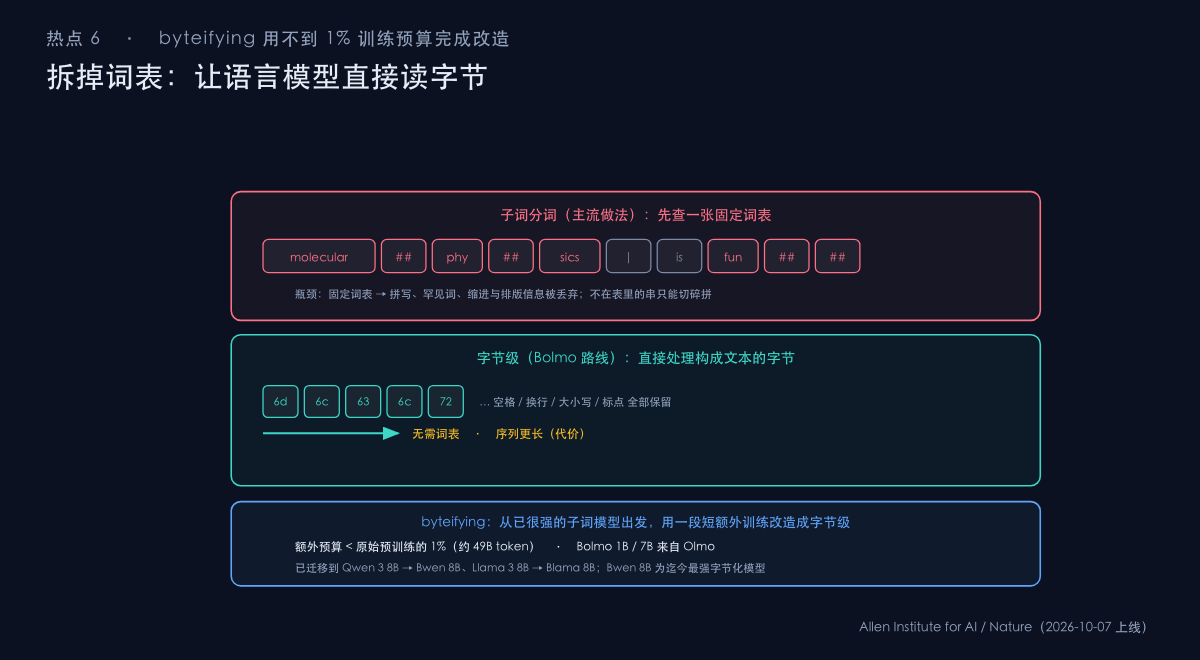
几乎所有主流大语言模型在读文本之前,都会先做一件事:分词(tokenization)。把文本切成"词"或"子词"单元,对照一张几万到几十万条目的固定词表转成整数编号。这个词表通常由一个训练好的分词器(tokenizer)定义。
分词器有个长期被诟病的问题:它是个信息瓶颈。很多排版信息在切分时被丢掉了。空格、缩进、大小写、标点位置——这些对代码来说是致命的(Python 缩进即语法),对拼写和形态丰富的语言也是负担。而且词表是固定的,任何不属于词表的字符串都得切成碎片拼。
字节级:退回最底层的表示
字节级(byte-level)模型的做法更简单粗暴:直接处理构成文本的字节——字母、标点、符号、空白符,以及计算机表示字符用的一切东西。不需要词表,不存在"这个词不在表里"的问题。因为字节是所有数字数据的基础,同样的思路理论上也能延伸到图像和音频。
代价是序列长度。字节数比词数多,一个英文单词平均 5-6 个字符,加上词首空格标记,一个词通常展开成 7-8 个 token。而序列越长,注意力计算越贵——这正是过去几年字节级模型一直没做起来的原因。
Byteify:不用从零训练
Ai2(Allen Institute for AI)2026 年 10 月 7 日在《自然》(Nature)上线的论文给了一个绕开这个代价的办法,方法叫 byteifying:从一个已经很强的子词模型出发,用一段相对短的额外训练把它改造成字节级模型。
这篇论文是 Bolmo 系列的基础。Bolmo 1B 和 Bolmo 7B 是从 Ai2 的开放模型 Olmo 改造来的,Ai2 称它们是第一批在广泛任务上能与强子词模型竞争的完全开放字节级语言模型。
关键数字:额外训练预算不到原始预训练预算的 1%,约 49B token。论文同时说明这招不局限于 Olmo——团队把它应用到 Qwen 3 8B 和 Llama 3 8B 上,得到 Bwen 8B 和 Blama 8B,两者性能都接近各自的母模型,其中 Bwen 8B 被描述为迄今最强的字节化模型,在 Ai2 的综合评测套件上超过 Bolmo 7B。
为什么值得关注
三点。
- 开放配方。Ai2 同时发布了论文、训练方法和多个 checkpoint。其他实验室可以直接验证或移植这套方法,而不是只能看着一个具体产物。
- 多语言与代码受益。字节级不需要"为每种语言维护一份词表",也不存在不同语言的 token 效率严重不均的问题。对中文、形态变化的语言(俄语等)、以及代码,这是直接的好处。
- 一个更根本的赌注。Ai2 的说法是:也许"文本只有一种合适的表示方式"这个前提本身就是错的。这句话背后是一个更大的判断——分词器是当前架构里一个纯粹的历史遗留包袱,字节才是数据的最底层真实。
与此同时,Ai2 在同期的 COLM 2026 上报告了另一项结果:把注意力层和线性递归层结合的 Olmo Hybrid,在 MMLU 基准上达到 Olmo 3 7B 的同等准确率,只用了 49% 更少的训练 token。这两项进展指向同一个方向——通过改变信息在模型内部的表示和处理方式,而不是单纯堆算力,来提升效率。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…