950 个智能体扫了 21 小时 DNA:AI 发现科学走到了哪一步
2026 年 9 月,Anthropic 公布了一次不同寻常的实验:让 AI 系统调度大约 950 个并行工作的智能体,连续扫描 21 小时的 DNA(脱氧核糖核酸)数据,最后找出一组此前未被系统描述过的重复序列、附属蛋白与已知逆转录酶的组合——结构上看,像一套 CRISPR 样的酶系统。
2026 年 9 月,Anthropic 公布了一次不同寻常的实验:让 AI 系统调度大约 950 个并行工作的智能体,连续扫描 21 小时的 DNA(脱氧核糖核酸)数据,最后找出一组此前未被系统描述过的重复序列、附属蛋白与已知逆转录酶的组合——结构上看,像一套 CRISPR 样的酶系统。
它到底发现了什么
需要把措辞收紧一些:这不是"AI 发现了新生物",也不是"又一套 CRISPR 已可用"。报道的描述是找出了一组有意思的序列模式——重复序列、与之相邻的附属蛋白、以及一个已知类别的逆转录酶,三者在基因组上的排布方式与已知的 CRISPR 相关系统有相似之处。这属于"值得去做湿实验验证的候选",离"功能确认"还隔着几个月到几年的实验工作。
为什么这类任务适合先让机器跑
宏基因组数据的规模已经超过人工可审阅的极限。公共数据库里的序列以万亿碱基计,其中大量来自无法培养的微生物,功能未知。人类研究者的策略通常是带着假说去查:我觉得这类环境里应该有某种系统,于是针对性搜索。这个策略高效,但视野受限于假说本身。大规模并行扫描换个思路:不做强假设,先把所有看着像"重复序列 + 邻近蛋白"的组合枚举出来,再按相似性与合理性排序。
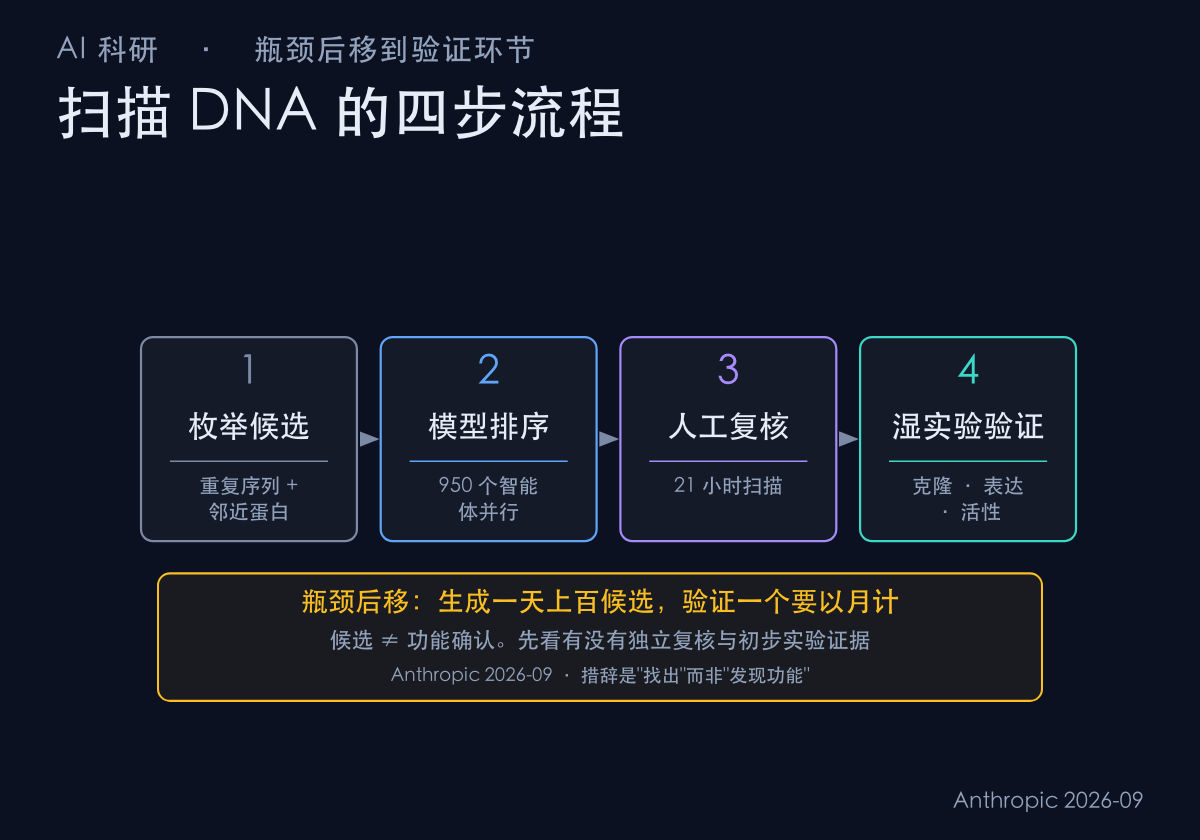
图6:枚举候选 → 排序 → 人工复核 → 湿实验验证
21 小时意味着什么
真正的变化在成本曲线上。过去这类穷举式扫描要占用一个团队几个月,现在变成一次可以在下班前发起、第二天早上看结果的计算任务。当搜索便宜到这个程度,研究策略本身会变:假说生成从稀缺资源变成可批量生产的中间产物,瓶颈整体后移到验证环节。
瓶颈搬到了实验室
这正是当前最值得警惕的地方。AI 可以一天产出上百个候选系统,但验证一个候选需要克隆、表达、纯化、活性测定,周期以月计。如果生成能力远超验证能力,多出来的候选不但不构成进展,还会消耗实验资源。这个领域接下来真正需要的不是更大的模型,而是更快的验证通路——这也正是"自驱动实验室"那条线在并行推进的原因。
怎么读这类新闻
三个问题可以帮你不被标题带走:候选有没有被独立方法复核、有没有初步的实验证据、原始团队自己怎么描述确定性。Anthropic 这次的表述相对克制,用了"找出"而非"发现功能",这是好的迹象。遇上一上来就宣称"改写生物学"的标题,先回原文看它的动词。
关联推荐
- AI 共同科学家:科研从"人做"到"人机共创" — 同一趋势的更完整图景
- 桑格研究所:人类基因组三分之一产自这里 — 这些数据是怎么被生产出来的
- 诺奖溯源:6 项改写生物学的发现,最初都长什么样 — 从候选到确认有多远
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…