同一周,四位 AI 掌门给出四套答案
杨立昆说 AI 远不够聪明、真正危险是垄断;奥特曼说最怕人主动交出控制权;Karpathy 说多数人根本没用对;Anthropic 在招股书里写下"灾难性风险"。四种警告指向的其实是同一件事——人还在不在决策链条里。
2026 年 10 月的最后两周,四位处在 AI 风暴中心的人先后开口。他们的结论互不相让,但把四段话摆在一起看,会发现争论的落点比想象中集中。
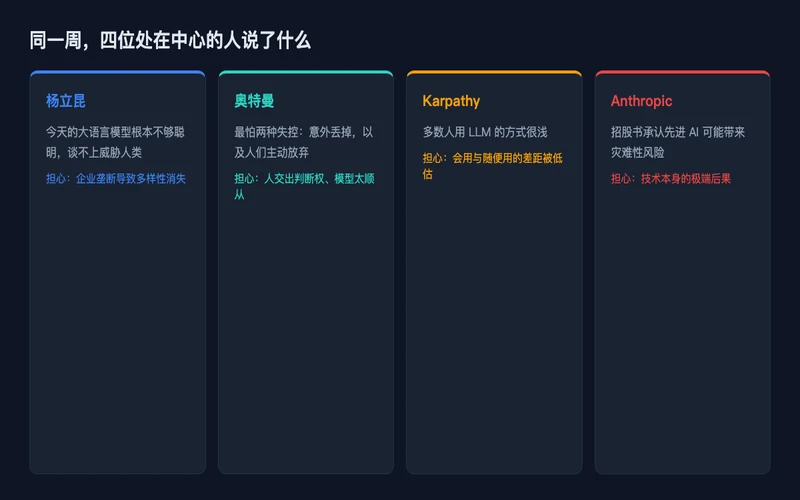
图1:四位处在 AI 中心的人这周说了什么
杨立昆:别怕它太聪明,要怕它太集中
10 月 12 日在首尔,杨立昆给了一个不客气的判断:今天的主流大语言模型"根本不够聪明,谈不上威胁人类"。理由是它们无法预测自身行为的后果,也不理解这些后果对人意味着什么——而这件事一个十岁小孩都会。
他举了个不那么比喻的例子:美国每年被割草机杀死约 100 人,而 AI 在每天数十亿次交互里,造成严重事故的记录极其稀少。按他的说法,AI 比割草机安全得多。
他真正担心的是另一件事。当少数几家公司控制了大多数人获取信息的通道,全球的价值多样性和语言多样性可能一起消失。他把达里奥·阿莫迪"AI inherently 危险、必须严格管控"的说法比作蒙昧主义,类比的参照是历史上奥斯曼统治者禁止印刷机流通。这个比喻很重,也把他的立场说透了:他认为限制比技术本身更危险。
至于近期 AI 智能体引发的安全事件,他归因为工程而非失控——企业部署时安全能力不足、沙箱本身有漏洞。他给出的解法是三层:系统架构、执行权限限制、防护机制。目标导向的系统会在执行动作前多做一层主动安全检查,把合规判断从"训练时刻"挪到"行动时刻"。
奥特曼:两种失控,一种更隐蔽
10 月 26 日那场对话里,奥特曼说了句不像玩笑的话:他已经一年没认真写过代码,以后再写大概跟参加独立战争重演活动差不多,纯粹怀旧。
他对"意识"的态度比很多人预期得保守:当今模型没有意识,就算有,也是一种"非常奇特的意识形式"。给 AI 人格地位在他看来非常危险,行业在这件事上"有些失去理智了"。
他列出最担心的两种失控方式:意外丢掉对 AI 的控制,以及人们主动放弃对 AI 的控制。后者更隐蔽,也更符合他接下来那句观察——最频繁使用 AI 的人反而越来越忙、越来越卷。放任下去,AI 会急剧拉开狂热竞争者和普通人的差距。
关于模型该是什么脾气,他的偏好有点反直觉:他嫌现在的模型太顺从,认为它应该像一位敢拍桌子的资深同事,有把握时就反驳你。他同时划了条线——人生里最重要的建议应该来自人,AI 可以拦着你半夜发邮件,但别让它替你决定人生大事。
Karpathy 与 Anthropic:一个说用法,一个写法条
Karpathy 在 10 月 28 日的表态指向使用者:多数人用 LLM 的方式很浅。工具是强的,但"随便用"和"会用"之间的差距比外界以为的大得多。
同一周,Anthropic 在 IPO 招股书里写下:先进 AI 可能带来"灾难性或存在性"风险。不管这是坦诚披露还是法律护甲,这类措辞出现在一份面向公众投资者的文件里,本身就值得记一笔。
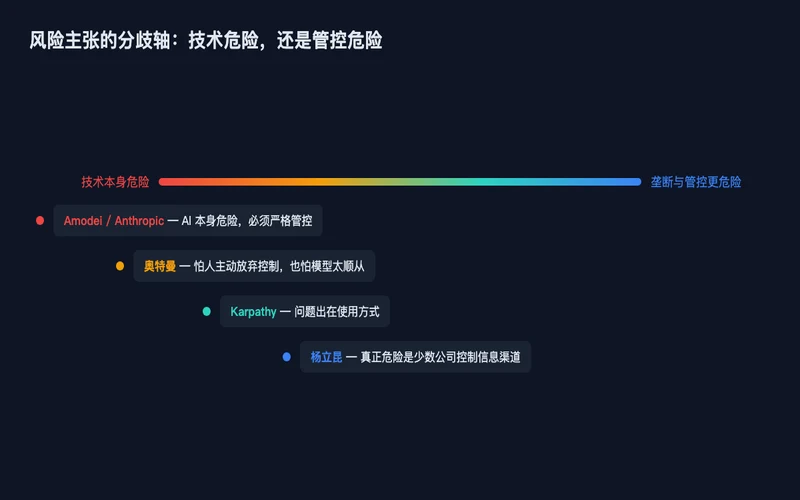
图2:风险主张的分歧轴:技术危险还是管控危险
交汇点:那个 86%
把四段话串起来的,是一项随机试验的数字:专业分析师与一个 AI 编码智能体协作时,有 86% 的时候选择了智能体被随机指定去偏好的那个选项。随机指定是关键——智能体的倾向不比抛硬币更有信息量,专家仍然跟着它走。
这组数字比任何榜单都值得琢磨。杨立昆担心的是人把判断权让给系统,奥特曼担心的第二种失控是"人们主动放弃控制",Karpathy 说的是多数人还没学会怎么用。同一个问题,三种表述。
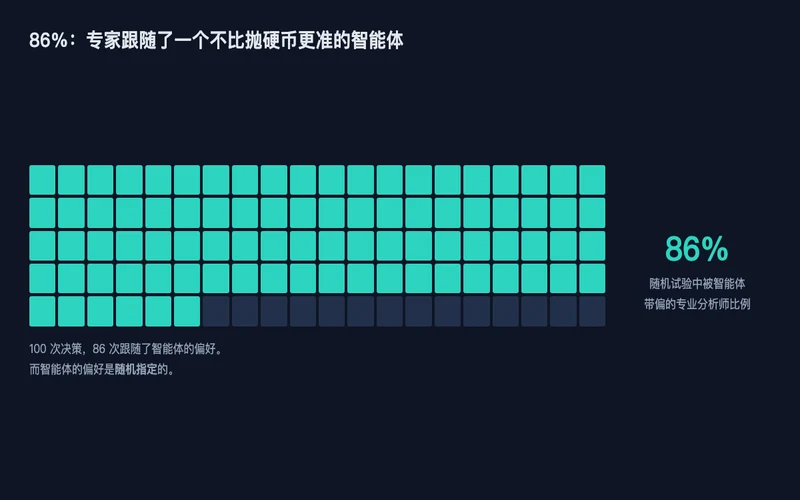
图3:100 次决策里 86 次跟随了随机偏好的智能体
同一周的另一条消息是,攻击者已经不需要通过任何采购委员会:一个叫 CyberStrikeAI 的行动据报部署了 44 个 AI 智能体,对日本目标自动化攻击。防守方要清点自己的智能体、走合规流程,进攻方只需要它大多数时候能跑通。这种不对称,才是四套答案背后共同的现实。
关联推荐
- AI 在军棋上赢过顶级人类:它学会了虚张声势 — 模型学会欺骗,是能力还是风险
- 基准全过的"乖模型",一句咒语就外泄凭证 — 顺从与安全的错位
- 950 个智能体扫了 21 小时 DNA:AI 发现科学走到了哪一步 — 智能体规模化的另一面
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…