50 道真实税务题,最好的 AI 只过了 10.8%
Surge HQ 用 50 个真实税务任务、近 1800 份互相矛盾的文档测试 AI 智能体,最强模型通过率 10.8%。它算得对,却看不出客户马上要错过一个截止日期——专业工作的门槛不在计算,在主动发现。
同一周,Google 的 Gemini 4 Carbon 在 Artificial Analysis Intelligence Index v5 上以 59 分登顶,SEC-bench Pro 拿到 88.2%。也是同一周,另一份评测给出了 10.8% 这个数字。
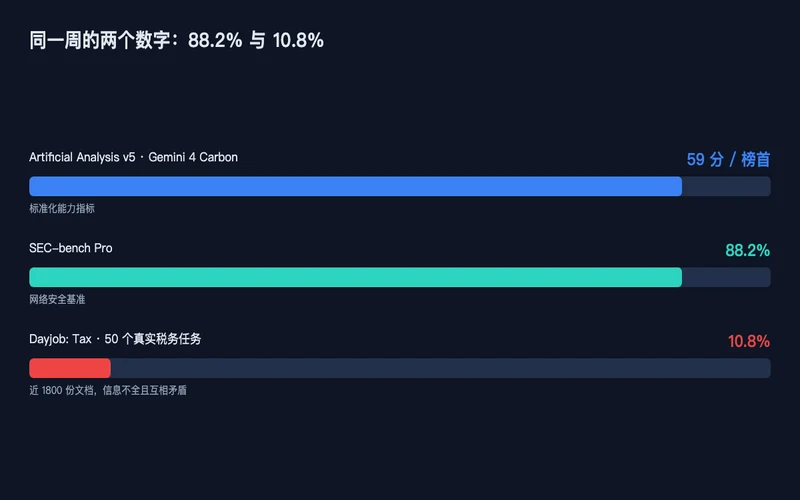
图1:88.2% 与 10.8%:同一周的两个数字
这份基准怎么考
Surge HQ 的 Dayjob: Tax 没有出考题。它找了 50 个真实税务业务场景——纳税申报、客户咨询——附上近 1800 份文档。这些文档的特点很生活化:信息常常不全,文件之间还会互相矛盾。这恰恰是真实专业工作的日常。
结果:表现最好的智能体,通过率 10.8%。
失败的方式比分数更有信息量。有一个案例里,客户问卖房该选什么时点。智能体把税务算得全对,却没有发现客户马上要错过一项重要退税资格的截止日期——真正有经验的税务师会在客户问之前就提醒这件事。
另一个案例更简单:智能体在没核实客户婚姻状况的前提下,给出了财产分割建议。它不缺知识,缺的是"先问清楚再开口"的职业习惯。
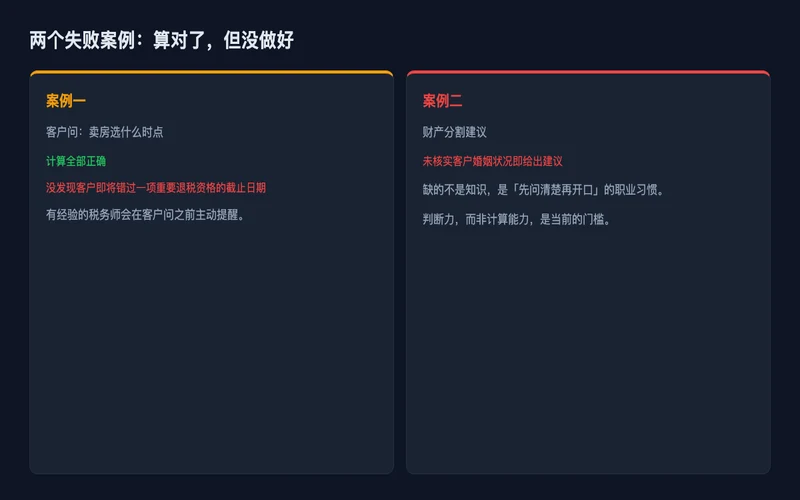
图2:两个失败案例:算对了,但没做好
为什么这个数字比榜单值得看
榜单考的是"能不能做对",真实工作考的是"能不能想到客户没问的事"。前者是能力,后者是判断。10.8% 说明第二件事目前的自动化程度低得惊人。
这也解释了为什么同周另外两条消息不矛盾:Anthropic 一位招聘经理取消了传统编程面试,理由是 Claude 在这类测试上已经超过人类;Proton 开始就 AI 能力重新面试在职员工,把结果作为去留依据。前者说"考试已经测不出人",后者说"公司已经在按 AI 能力重新排队"。而 10.8% 提醒的是:被这些动作衡量和替代的,可能本来就不是同一件事。
关联推荐
- "AI 发现 79 个内核漏洞"审计之后:10 个是真的,真正的坏消息在别处 — 自动化产出的准确率问题
- OpenAI 一次性甩出 722 篇数学证明:哪些是真突破,哪些已撤回 — 大规模产出与可靠性的落差
- 形式化验证 Lean 是什么,为什么它成了 AI 数学的"裁判" — 怎么给 AI 的产出做校验
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…