不反向传播,Q Labs 的 Dust 预训练了 Transformer
Q Labs 在 2026 年 10 月放出 Dust——一种不用反向传播、靠在激活上叠加噪声来近似梯度的 Transformer 预训练方法。论文声称在 243M 参数规模上和反向传播可比,但第三方复现泼了冷水:换上合适的优化器,反向传播明显更便宜也更准。它现在是个昂贵的玩具,但把"还需要处处可微吗"这个老问题重新摆上了台面。
10 月底,一篇标题很挑衅的论文在圈子里传开:《Dust: Pretraining Transformers Without Backpropagation》。Q Labs 声称,他们不用反向传播,也能预训练一个 Transformer,而且在 243M 参数的规模上,效果能跟反向传播比一比。
过去 40 年,"训练神经网络"几乎等于"反向传播"。这篇论文敢把"不用"写进标题,自然引发了两派反应:一派兴奋,觉得路线被拓宽了;另一派冷静,觉得这不过是又一篇"重新发明轮子还更贵"的工作。两边都对,只是说的是不同层面。
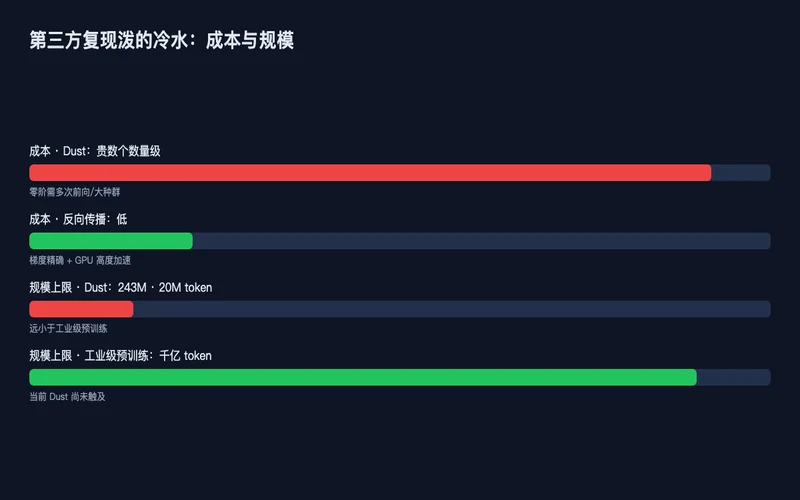
图1:反向传播算梯度,Dust 用扰动试梯度——两条路都指向"往哪改参数"
它到底改了什么
传统零阶优化在权重空间扰动:复制多份模型,每份略不同,跑前向比谁好。模型一大,复制成本就爆炸。Dust 把扰动挪到激活空间:不复制权重,而是给每层输出加一份高斯噪声,而且每个 token 独立加。一个序列几千个 token,等于一次前向并行试了几千份略不同的参数,Q Labs 叫它虚拟种群。哪个噪声让损失降了就记功,加权平均后近似出梯度。
图2:扰动从权重搬到激活,借 token 维度实现大规模并行采样
论文里最反直觉的一点
零阶方法通常被认为"越大越不灵",但 Dust 报出相反趋势:模型越大,种群效率越高——243M 的模型在多数设置下优于比它小 120 倍的版本。如果可复现,这等于把"过参数化是负担"这句老话翻了个面:参数多,可能意味着搜索空间更好、几何结构更友好。
第三方泼的冷水
兴奋归兴奋,复现很快来了。SOTAAZ Lab 的独立实验指出两点:第一,Dust 目前比反向传播贵"几个数量级";第二,实验上限只有 243M 参数、20M token,和工业级预训练差着量级。更重要的是,他们把反向传播换上合适的优化器、在同样数据上多训几轮后,反向传播不仅更准,还便宜得多。
图3:论文声称可比,第三方复现显示反向传播在成本与精度上仍占优
我的判断
Dust 不是"反向传播的终结者",而是"反向传播为什么是默认"这个问题的重启键。它的真价值在于:对不可微的模块——离散决策、黑箱仿真、带硬件约束的系统——零阶是一条不用重写整个技术栈就能接入的旁路。今天它贵得离谱,但玩具里藏着一条可能的路线。值得盯着,不值得现在下注。
核心信息来源
本文区分"官方口径"与"本文判断":
- 官方口径(Q Labs 主源):Dust 在 243M 参数、20M token 上,预训练效果可与反向传播相比;模型越大种群效率越高;当前成本比反向传播高数个数量级。来源:qlabs.sh/research/dust(2026-10)。
- 第三方复现(SOTAAZ Lab,经机器之心、The Tessera Press 报道):同等数据与优化器下,反向传播精度更高、成本更低;Dust 实验规模远小于工业级。来源:机器之心《不反向传播也能预训练 Transformer》(2026-10-26)、The Tessera Press 同名报道。
- 本文判断(非官方数据,属作者推演):Dust 的现实意义在于为不可微模块提供旁路,而非取代反向传播。该结论为本文观点,不代表 Q Labs 或复现方立场。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…