模型改行做判断:专用小模型开始领工牌
2026 年秋天,一类"只做判断、不做生成"的小模型密集出现——微软 Decision-1、JetBrains Mellum 2.1、Liquid d1。它们参数量只有旗舰的几十分之一,却在"该不该做、错在哪"这类判断任务上超过大模型。智能体时代,评判权正在从大模型下放。
如果说 Dust 是在"怎么训练"上动刀子,另一类新模型是在"模型该干嘛"上重新分工。2026 年秋天,几条几乎同时的消息指向同一个趋势:模型开始改行做判断。
微软放出 Decision-1,JetBrains 迭代到 Mellum 2.1,Liquid AI 推出 d1。它们的共同点很反直觉——参数量只有旗舰大模型的几十分之一,不负责"写出一段话",只负责"判断这件事该不该做、刚才那步对不对"。而在它们各自的判断任务上,这些小模型跑赢了体量远大于自己的通用大模型。
图1:通用大模型负责"生成",专用小模型负责"判断与纠错",评判权被拆分
为什么是"判断"而不是"生成"
生成是开放式的,需要海量参数记住世界;判断是收敛式的,只要把"好/坏、对/错、该/不该"这条窄缝做准就行。智能体真正缺的往往不是"会不会做",而是"做完之后谁来判断做对了没有"。把判断拆成独立的小模型,意味着一个智能体可以跑着便宜的小模型做实时校验,只在必要时才调用昂贵的大模型。
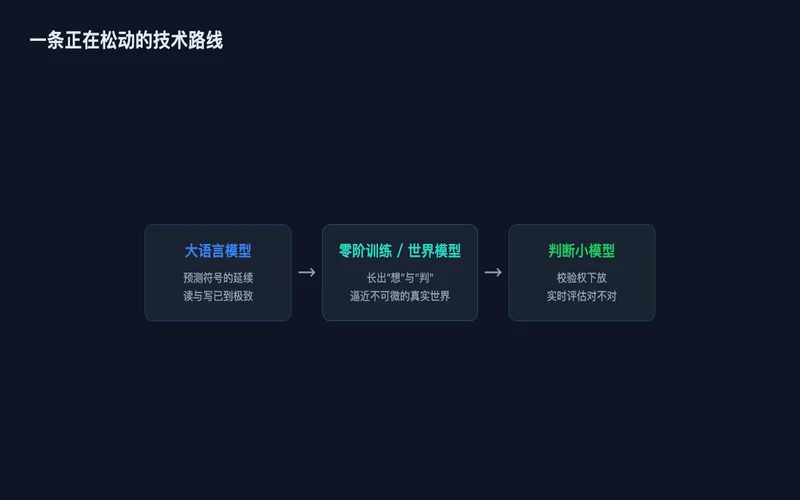
图2:Decision-1 / Mellum 2.1 / d1 三个专用判断模型的定位对比
它和世界模型、Dust 是同一条暗线
把这三件事放一起看就清楚了:世界模型让 AI 预测后果,Dust 想换一种更宽松的方式去训练,而判断小模型则把"评估"从大模型里剥离出来。三者都在做同一件事——让系统不再只是一条"输入→输出"的管道,而是长出"想"和"判"的能力。当算力便宜到可以随手跑一个小模型做陪审,大模型的角色就从"全知全能的执行者"变成了"需要被监督的专家"。
值得记住的一句话
未来重要的可能不是"谁的参数最多",而是"谁把判断权分了出去"。评判权一旦下放,系统的可靠性就不只取决于最大的那个模型,而取决于那张判断网络织得够不够密。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…